インスタンスセグメンテーションのラベル付けとトレーニング
ポリゴンラベルを作成し、コードで確認して、COCO8-segでyolo26n-seg.ptをトレーニングし、ボックス指標とマスク指標の差からモデルを診断します。
インスタンスセグメンテーションでは、各オブジェクトに個別の輪郭を割り当てます。面積、重なり、境界が判断基準となる場合に必要な機能です。ポリゴンは多くのチームが購入するラベルの中でも特にコストが高く、形式が不正な行があってもトレーニングは停止せず、誤った形状で気付かないまま学習が進みます。このレッスンでは、行の形式を正しく整え、コードでラベルセットを確認し、最初のモデルをトレーニングします。これにより、追加のラベル付けで得られるもの、つまり位置だけでなく輪郭も評価する2つ目の指標を確認できます。
実践的
ポリゴンラベルの行#
セグメンテーションのラベルファイルは、検出ラベルと同様にオブジェクトごとに1行で構成されます。ただし、ボックスの代わりに、オブジェクトの輪郭を正規化された頂点ペアで記述します。COCO8-segの実際の行を短くした例を示します。
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| 位置 | 検出の行 | セグメンテーションの行 |
|---|---|---|
| 1 | クラスインデックス(45はbowlです) | クラスインデックス |
| 2–5 | x_center y_center width height | 最初の2つの頂点、x1 y1 x2 y2 |
| 6+ | — | 輪郭に必要な数の頂点を追加 |
| 単位 | 0~1に正規化 | 0~1に正規化(ピクセルx ÷ 画像幅、ピクセルy ÷ 画像高さ) |
重要なルールは3つです。オブジェクトごとに頂点を3つ以上指定すること、画像サイズで割った座標を使うこと、同じクラスのオブジェクトが接していてもインスタンスごとに1行を作成することです。完全な仕様については、セグメンテーションデータセットガイドをご覧ください。
ポリゴンはボックスラベルを包含する形式です。同じラベルフォルダーを使って yolo26n.pt(Ultralyticsがポリゴンから各ボックスを導出)と yolo26n-sem.pt(ポリゴンをラスタライズしてクラスマップを作成)の両方をトレーニングできます。これらはどちらも coco8-seg.yaml でトレーニングしました。ラベル付け後に計画が変わっても、費用は無駄になりません。
トレーニング前にラベルを確認する#
値の個数が奇数の行、ピクセル単位で記述された座標、誤った対象をなぞった輪郭があっても、トレーニングは停止しません。このチェッカーはUltralytics独自のローダーでデータセットを読み込み、不正な行を除外して、各ポリゴンの面積とUltralyticsがそこから導出するボックスを並べて出力します。
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38面積は画像に対する割合で示されるため、最初のボウルは写真の39%を占めています。塗りつぶし率はポリゴン面積をボックス面積で割った値で、確認すべき列です。
- ボウル、オレンジ、ブロッコリーなど、形状が比較的まとまったオブジェクトの多くは0.6~0.7程度になります。
- キリンの0.31は妥当な値です。長い脚と首のため、ボックスの大部分が空いています。これこそ、このオブジェクトにマスクが必要な理由です。
- 3つ目のボウルの0.15は、レビュアーが確認すべき行です。食べ物の周囲にボウルの縁が細く見えるだけなので、輪郭は大きなボックス内の細い帯状になります。この例では正しい結果ですが、独自のデータでは、塗りつぶし率がこれほど低い場合、誤ったオブジェクトの輪郭をなぞっていることもよくあります。
トレーニング前に、BADと判定された行をすべて修正してください。次にfillで並べ替え、各クラスの中でfillが最も低い数パーセントの行をアノテーションツールで開いてください。fillが低い場合は、細いオブジェクトや遮蔽されたオブジェクト(維持)か、誤ったトレース(修正)のどちらかです。
すべての輪郭を手作業でなぞらずにポリゴンを取得する#
輪郭を手作業でなぞる作業は、データラベリングの中でも特にコストがかかります。作業を始める前に、どの方法が適用できるか確認しましょう。
| すでにあるもの | ツール |
|---|---|
| セグメンテーションを含むCOCO JSON | convert_coco(labels_dir, use_segments=True)(ultralytics.data.converterから) |
| PNGマスク(ピクセル値 = クラスインデックス + 1、0 = 背景) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes) — 同一クラスの接触したオブジェクトは1つのポリゴンになるため、レビューで分割してください |
| ボックスラベルのみ | yolo_bbox2segment(im_dir) — 各ボックスをプロンプトとしてSAMに渡し、ポリゴンを生成します |
| まだ何もない | スマートアノテーションと一括ラベリング — 1回クリックして、ポリゴンを確認します |
Ultralytics Platformでは、スマートモードでSAMを実行します。対象をクリックする正のクリックと、除外する対象をクリックする負のクリックでマスクを生成し、その後レビューします。
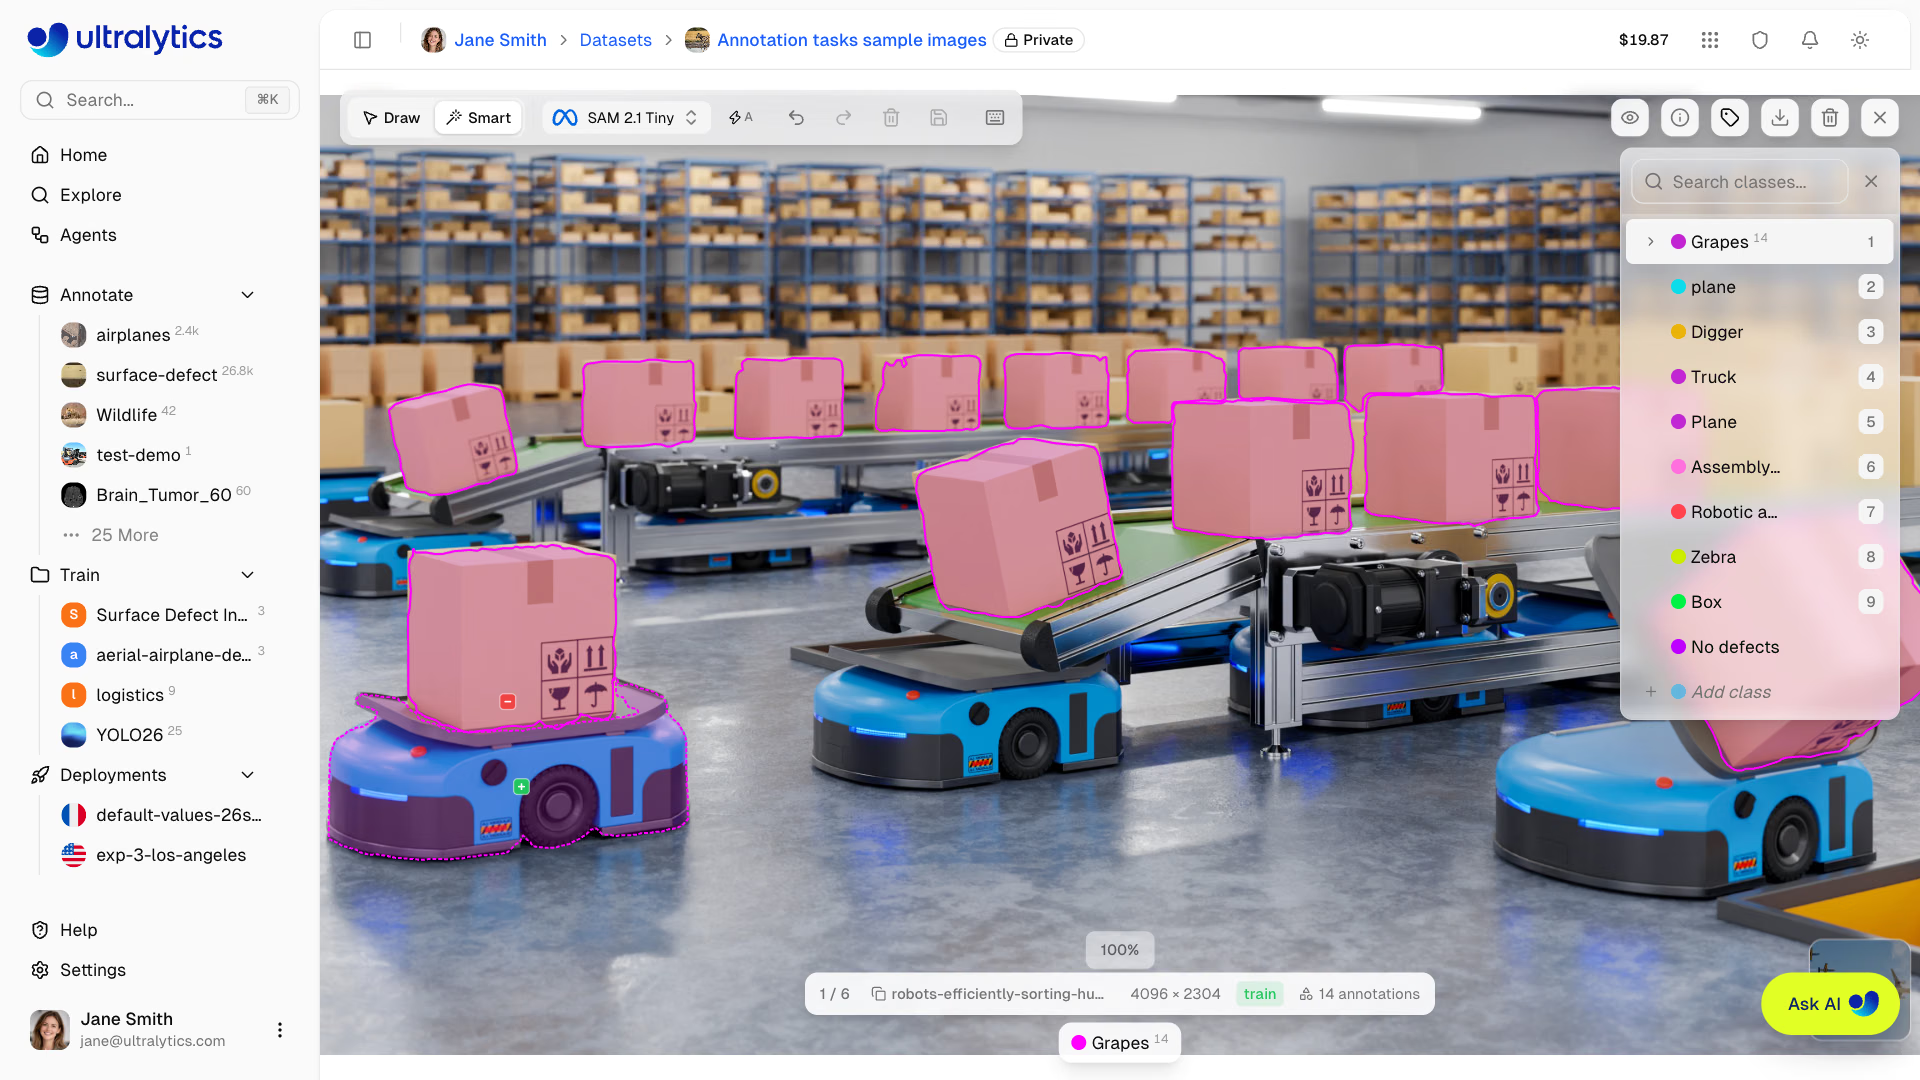
背景にはみ出したマスクを使うと、モデルも同様のマスクを生成するようトレーニングされます。機械生成ポリゴンをボックスとマスクの品質基準に照らして確認し、上記のラベルチェックを再実行してください。
COCO8-segでトレーニングする#
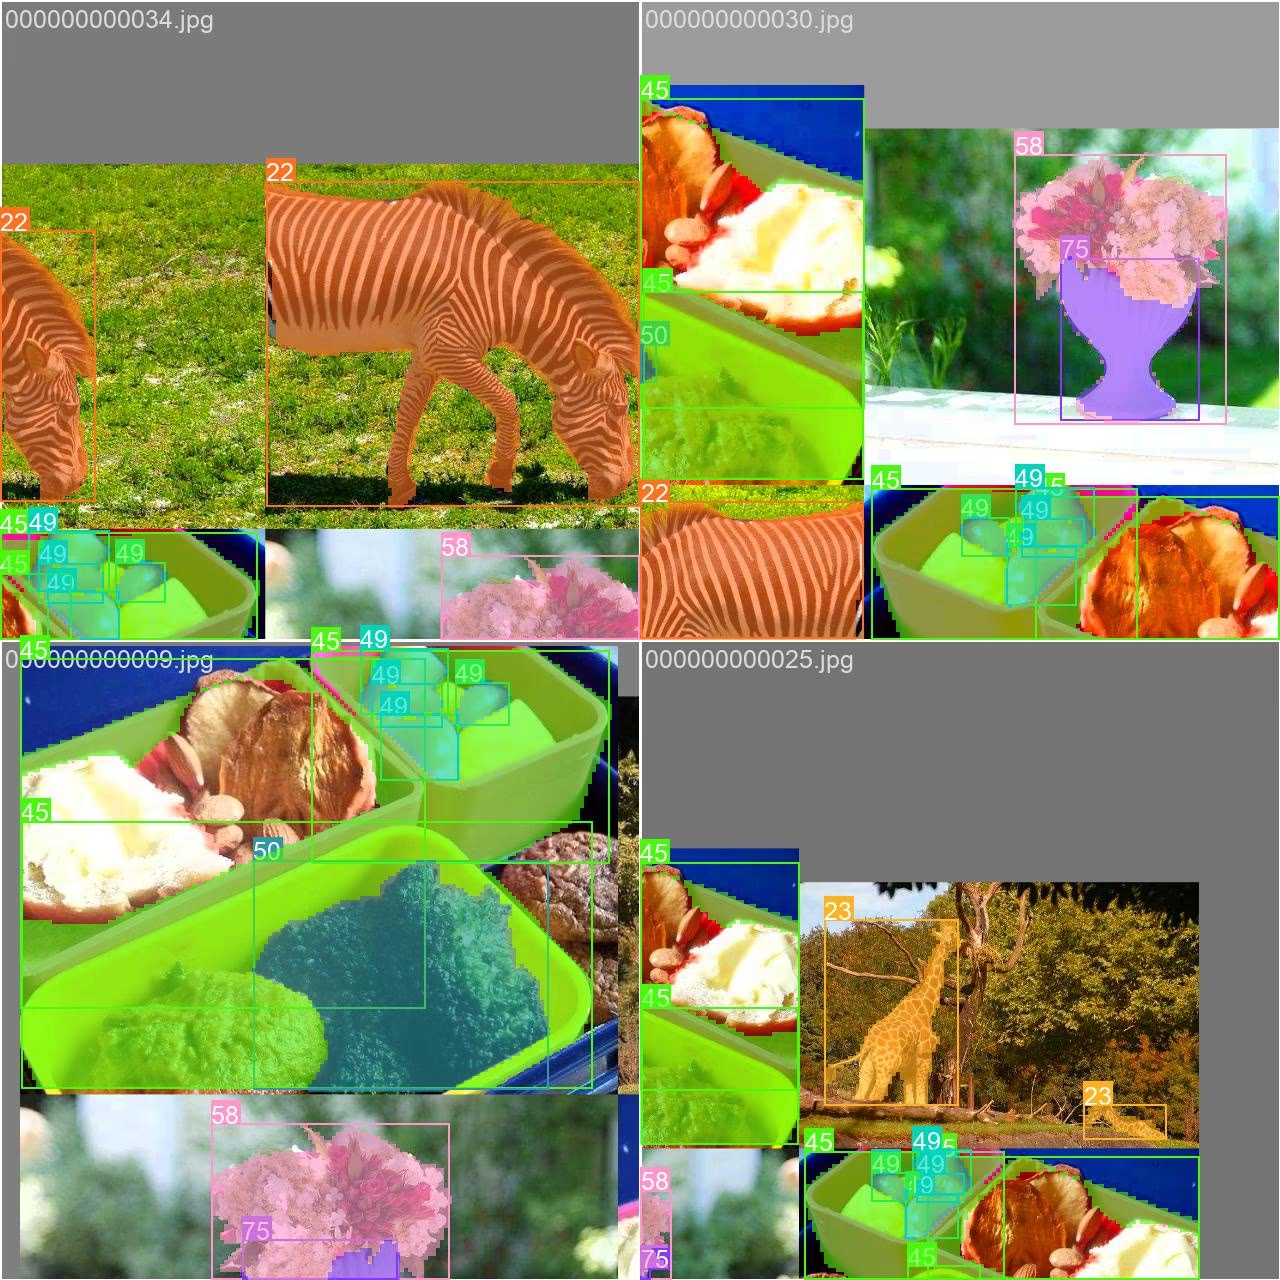
トレーニングは、-segモデルとセグメンテーションデータセットを使う検出ワークフローです。ノートPCのCPUでimgsz=320の1エポックを数秒で完了でき、パイプライン全体の動作を確認できます。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377検証画像が4枚だけでは、これらの数値はノイズにすぎません。重要なのは、実行が完了し、runs/segment/の下にweights/best.ptが書き出されることです。実データでは、セグメントタスクガイドに従い、GPUでスケジュール全体をトレーニングしてください。
ボックスとマスクの指標を並べて確認する#
検証テーブルには2つのブロックがあります。Boxは予測ボックスをラベルから推定されるボックスと比較して評価し、Maskは予測ピクセルをラベル付けされたポリゴンと比較して評価します。どちらも同じmAPの計算を使い、異なるのはIoUだけです。
マスクmAP50-95は、ほぼ常にボックスmAP50-95を下回ります。ピクセル単位のIoUのほうが厳しいためです。ボックスが数ピクセルずれても十分に重なりますが、マスクが腕を捉え損ねたり道路にはみ出したりすると、しきい値0.75~0.95ではIoUが急激に低下します。horseの行は、その極端な例です。ボックスmAP50-95は0.564、マスクは0.199です。モデルは両方の馬を検出し、ボックスで正しく囲みましたが、脚と尾の輪郭は捉えられませんでした。この差を使って修正内容を決めましょう。
- 両方とも低い場合:問題は輪郭ではなくオブジェクトの検出です。まず、検出できなかった条件のデータを追加します。
- ボックスは良好で、マスクが大きく下回る場合:モデルはオブジェクトを検出していますが、輪郭の精度が低い状態です。ラベルを確認し、より大きなモデルを試すか、より高い
imgszでトレーニングと検証を行います。 - ボックスの改善が停滞しても、マスクが改善している場合:問題ありません。セグメンテーション製品では、リリース判定にマスクmAP50-95を使います。
overlap_mask=True はトレーニング時にインスタンスマスクを1枚の画像に統合し、mask_ratio=4 はトレーニングマスクをダウンサンプリングします。どちらも予測マスクの解像度は変更しません。解像度を決めるのは次のレッスンで扱う retina_masks です。変更する理由を測定で確認できていない場合は、どちらもデフォルトのままにしてください。
解答を表示
すべての分割を確認するには、ループ内のフォルダーをPath(data["path"], "labels").rglob("*.txt")に置き換えます。次にトレーニングを実行します。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}") # 0.377 in our run0.1の差は想定内です。マスクIoUではすべての境界ピクセルが評価対象ですが、ボックスIoUでは4辺だけが対象です。今回の実行で差が最大だったのはhorse(ボックス0.564、マスク0.199)です。ボックスmAPは良好ですが、マスクは大きく下回っているため、チャートは輪郭の品質を示しています。まずポリゴンを確認し、その後、より大きなモデルか、より高いimgszを試してください。