비용 및 지연 시간 조정
전체 파이프라인의 프로파일을 측정하고, 지연 시간과 비용에 실제 영향을 주는 조치를 순서대로 적용한 뒤 예산에 도달하면 중단합니다.
팀은 모델에서 몇 밀리초를 줄이는 데 몇 주를 쓰지만, 실제 병목은 데이터베이스 쓰기나 RTSP 디코더인 경우가 많습니다. 주요 조치는 몇 가지뿐이며 효과도 잘 측정할 수 있습니다. YOLO26s는 CPU에서 YOLO26n보다 mAP 포인트가 7.7 높지만 실행 시간은 2.2배 더 걸리고, 프레임을 하나씩 건너뛰며 검출하면 작업량이 절반으로 줄어듭니다. 이 강의에서는 먼저 프로파일을 측정하고, 효과가 가장 크면서 요구 사항에 맞는 조치를 적용한 다음, 미리 정한 예산에 도달하면 중단하는 방법을 다룹니다.
실습형
먼저 전체 파이프라인 측정하기#
모든 Results 객체는 자체 실행 시간을 단계별로 나눕니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frame여기서는 추론이 모델 실행 시간의 95%를 차지하므로 모델 관련 조치가 효과가 있습니다. 디코딩과 자체 싱크도 같은 방식으로 시간을 측정한 다음(time.perf_counter()을 각각 감싸서 측정), 결과에 따라 다음 규칙을 적용합니다:
| 측정 결과 | 먼저 해결할 항목 |
|---|---|
| RTSP 디코딩 60ms, 추론 5ms | 하드웨어 디코딩, 스트림 해상도 낮추기 또는 디코더 스레드 추가 |
| 추론 30ms, Python 후처리 100ms | NumPy로 벡터화하거나 작업자 프로세스로 옮기기 |
| 추론 5ms, 데이터베이스 쓰기 200ms | 쓰기를 배치 처리하거나 비동기로 전환하기 |
| 추론이 주요 병목인 경우 | 아래 조치별 성능 순위표 |
조치별 성능 순위표#
위에서부터 시도하고 예산을 충족하면 중단합니다:
| 조정 항목 | 일반적인 속도 향상 | 일반적인 정확도 비용 |
|---|---|---|
| 더 작은 모델(m → s, s → n) | 1.5–2.5× | COCO에서 4.5~7.7 mAP 포인트, 범위가 좁은 작업에서는 그보다 적음 |
더 작은 imgsz(640 → 480) | 약 1.8배 | 작고 멀리 있는 객체부터 영향받음 |
| 더 빠른 런타임, FP16 | GPU에서 약 1.5배 | 대개 없음. 동등한 성능인지 확인합니다 |
| 캘리브레이션을 적용한 INT8 | GPU에서 추가로 1.2배, CPU에서 최대 2.9배 | YOLO26n은 1포인트, 대형 모델은 4~6포인트 손실. QAT로 대부분 복구 가능 |
프레임 수 줄이기(vid_stride=N) | 최대 N배 | 빠르게 움직이는 객체와 짧은 이벤트를 놓칠 수 있음 |
| 배치 크기 늘리기(서버) | 처리량은 증가하지만 지연 시간은 줄어들지 않음 | 없음 |
수치는 YOLO26, TensorRT, OpenVINO 벤치마크 표와 아래 측정값에서 가져왔습니다. 실제 결과는 다를 수 있으므로 직접 측정하세요.
더 작은 모델#
COCO에서 측정한 YOLO26 벤치마크 표:
| 모델 | mAP50-95 | CPU ONNX(ms) | T4 TensorRT10(ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
CPU에서는 모델을 한 단계씩 줄일 때마다 2.2~2.5배 빨라집니다. COCO의 정확도 차이는 최악의 경우입니다. 대형 객체를 다루는 3클래스 창고 검출기는 80클래스 일반 검출기보다 m에서 n으로 줄였을 때 성능 저하가 훨씬 적은 경우가 많으므로, 자체 검증 세트에서 더 작은 모델을 반드시 테스트해야 합니다.
더 작은 입력 크기#
연산량은 픽셀 수에 대략 비례하므로 imgsz=480은 640 크기의 약 56%에 해당하는 연산만 필요합니다. 테스트용 노트북의 CPU에서 ONNX Runtime, 배치 크기 1로 측정한 결과입니다(bus.jpg에서 25회 실행한 중앙값):
| 모델 | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
판단 기준: 새 크기에서 가장 작은 주요 객체가 여전히 약 10픽셀 이상이면 시도해 보세요. 객체가 작거나 멀리 있는 경우(드론, 카메라에서 멀리 떨어진 선반)에는 해상도를 유지하고 대신 모델 크기를 줄입니다.
프레임 수 줄이기#
추론이 프레임 속도의 병목이고 장면이 천천히 움직인다면 vid_stride=N으로 N번째 프레임마다 검출을 실행하고 트래커로 그 사이를 연결합니다:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDs프레임 수를 절반으로 줄이면 실행 시간도 대략 절반이 되며, 트래커는 ID 32개 중 30개를 유지했습니다. vid_stride=3에서는 ID 4개를 놓쳤으며, 이 보행 속도의 장면에서는 여기서 중단해야 한다는 신호입니다.
클라우드 비용 절감하기#
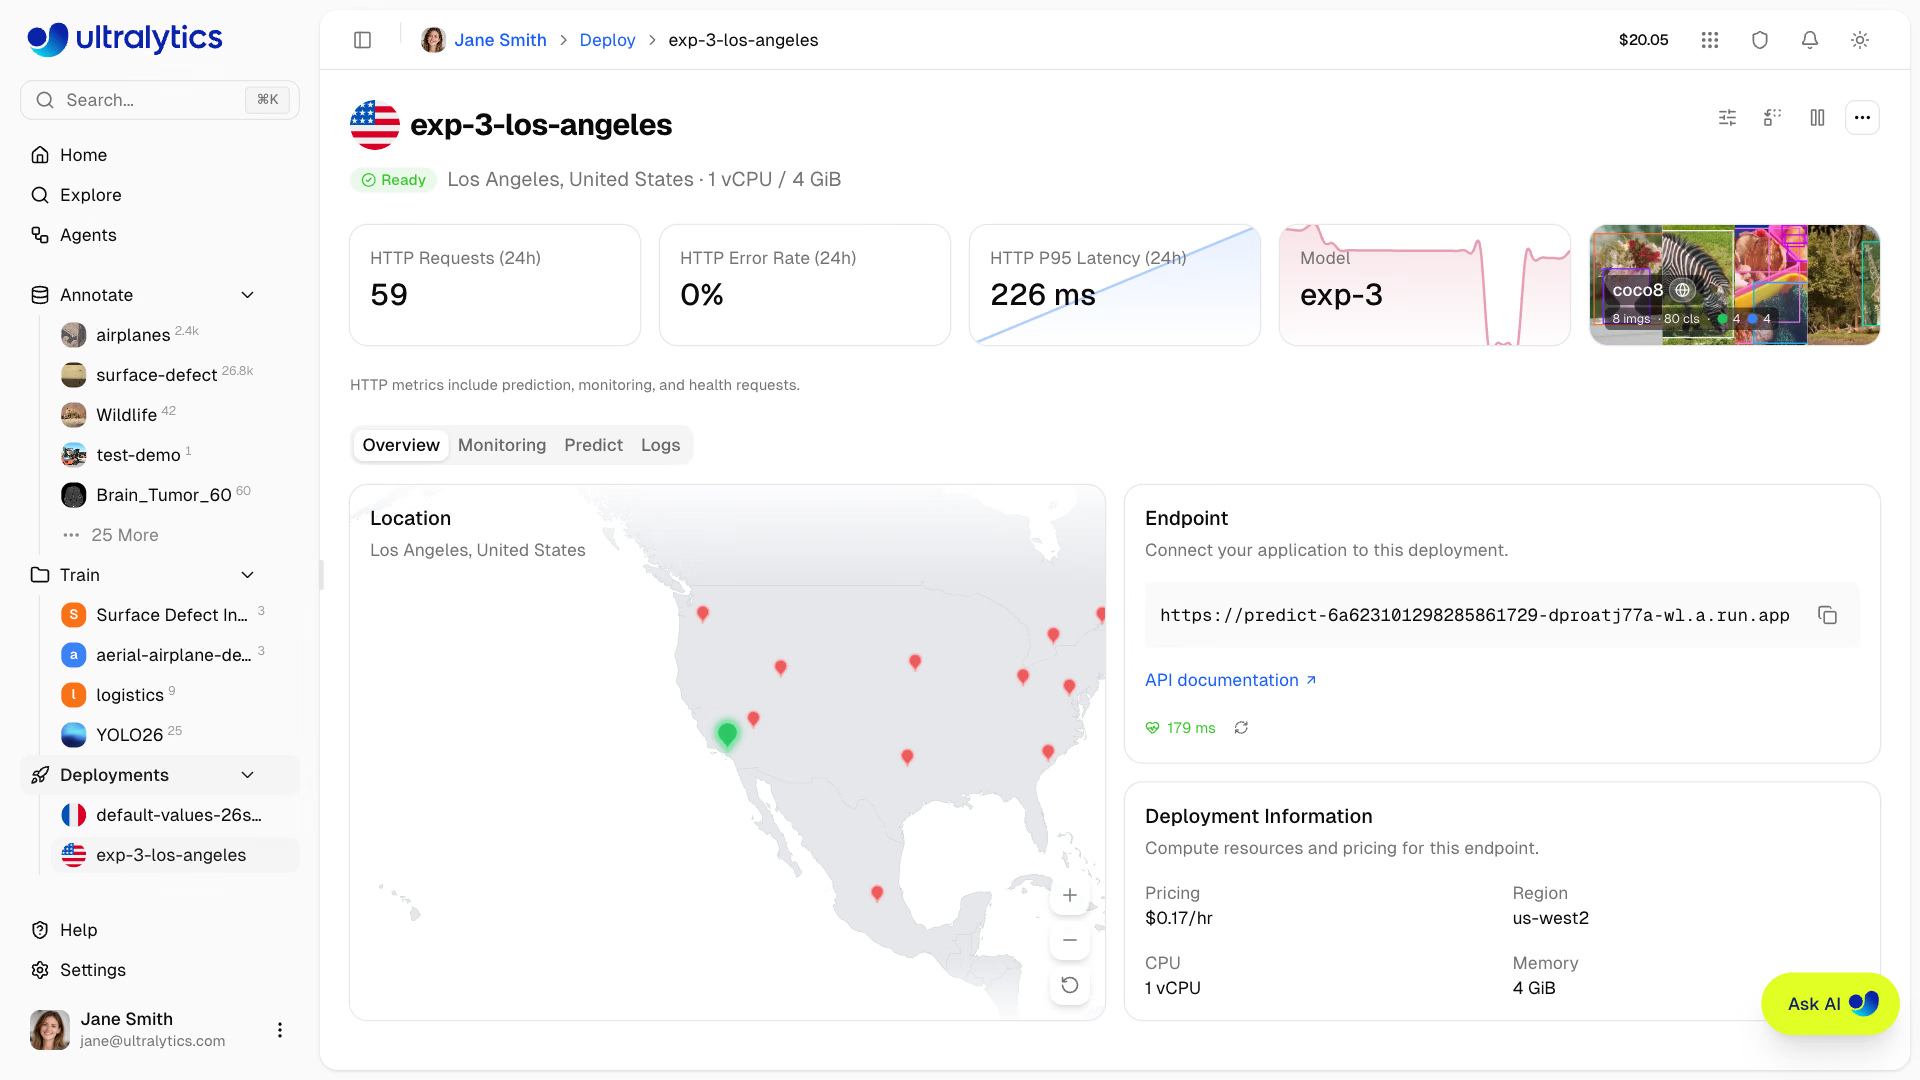
비용은 인스턴스 사용 시간을 유용한 작업량으로 나눈 값입니다. 이 카드와 같은 화면에서 필요한 수치 두 가지를 확인할 수 있습니다. 시간당 비용(여기서는 vCPU 1개와 4GiB에 $0.17)과 처리 작업량(대부분 유휴 상태인 엔드포인트가 P95 226ms로 24시간 동안 요청 59건 처리)입니다. 그런 다음:
- 사용률을 높입니다. GPU 사용률이 30%라면 비용의 70%가 낭비됩니다. 스트림을 배치 처리하거나(이전 강의 참조) Triton Inference Server를 통해 서비스를 제공합니다.
- 적정 규모를 사용합니다. 대형 GPU가 필요하다고 가정하기 전에 더 작은 GPU 또는 OpenVINO를 사용하는 CPU에서 벤치마크를 실행합니다.
- 배치 작업에는 스팟 또는 선점형 용량을 사용합니다. 보관된 동영상을 다시 처리하는 작업은 중단을 감당할 수 있지만, 라이브 스트림은 그렇지 않습니다.
주의할 점#
증상: 2주간 조정해 10ms를 줄였지만 시스템은 여전히 느립니다. 해결 방법: 먼저 전체 파이프라인을 프로파일링하고 무엇이든 가장 큰 비중을 차지하는 단계를 개선합니다.
증상: 결과 루프 안의 if i % 2: continue은 아무것도 절약하지 못합니다. 해결 방법: 모델은 이미 해당 프레임을 처리했으므로 vid_stride을 사용해 소스 단계에서 프레임을 건너뜁니다.
증상: 처리량은 증가했지만 각 프레임의 도착이 늦어집니다. 해결 방법: 배치 크기를 늘리면 프레임당 지연 시간이 아니라 비용 대비 처리량이 증가합니다. 여러 스트림이나 오프라인 작업에 배칭을 사용하고, 단일 실시간 카메라에는 사용하지 마세요.
모델 개선 수단을 모두 사용했다면 다음 선택지는 더 나은 데이터입니다. 프로덕션 환경을 반영하는 데이터셋을 사용하면 더 작은 모델도 더 큰 모델이 필요로 했던 정확도에 도달할 수 있으므로, 정확도 손실 없이 비용을 줄일 수 있습니다.
정답 보기
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
각 행은 워밍업을 위해 처음 5회 실행을 제외하고 나머지 실행 결과의 중앙값을 보고합니다. 지연 시간 예산을 충족하고 mAP 손실이 예산 이내인 첫 번째 행을 선택합니다. 예산 설정 예시: "이틀, 최대 1 mAP 포인트 손실, 매장 서버에서 20 FPS." yolo26s의 640 설정이 프레임당 50 ms를 넘고, yolo26n의 640 설정이 val 세트에서 1포인트 이내의 손실로 목표를 충족한다면 여기서 멈추고, 둘째 날을 480 설정에 쓰지 마세요.