CPU에서 OpenVINO 사용
FP32, FP16, INT8 OpenVINO 모델을 내보내고 각각을 검증한 다음, 사용 중인 CPU에서 효과가 있는 경우에만 INT8을 유지하세요.
이미 보유한 Intel CPU로 GPU 인스턴스를 대체할 수 있는 경우가 많습니다. Ultralytics 벤치마크에서 YOLO26m은 PyTorch의 192ms에서 노트북 Core Ultra CPU의 OpenVINO INT8 사용 시 36ms로 단축됩니다. 다만 성능 향상은 칩에 따라 달라지며, 이 강의의 ARM 테스트 노트북에서는 이미지 4장으로 캘리브레이션한 INT8 내보내기로 mAP가 3포인트 하락했습니다. 배포 전에 어떤 경우에 해당하는지 측정하는 방법을 알아봅니다.
실습형
OpenVINO의 이점#
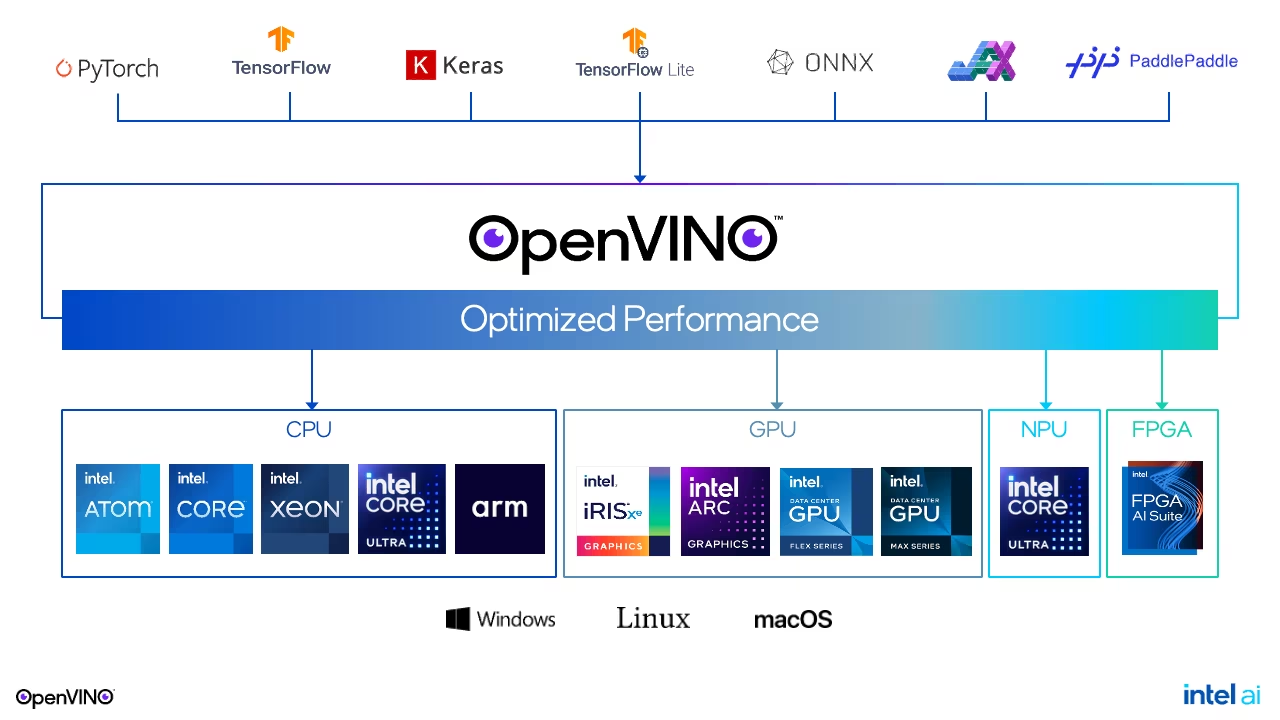
OpenVINO는 PyTorch 및 ONNX 모델을 가져와 단일 API를 통해 Intel CPU, 내장형 및 외장형 GPU, NPU에서 실행합니다. CPU 커널은 Intel 명령어 세트(AVX2, AVX-512, AMX)를 대상으로 하며, INT8 경로도 성숙해 있습니다. CPU 열의 ARM 타일에 유의하세요. OpenVINO는 ARM에서도 실행되지만 커널은 Intel에 맞게 튜닝되어 있으므로, ARM에서 사용하기 전에 성능을 측정하세요.
Intel Core Ultra 7 155H CPU에서 공개된 벤치마크 결과(COCO128):
| 모델 | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | FP32 → INT8 mAP50-95 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
이 표에서 세 가지 원칙을 도출할 수 있습니다.
- Intel CPU에서는 OpenVINO FP32만으로도 PyTorch의 지연 시간이 대략 절반으로 줄어듭니다. 먼저 이 방법을 적용하세요.
- 모델이 클수록 INT8의 효과가 커집니다.
n은 1.2배,m은 2.9배 빨라지는 대신 mAP가 1.2~1.7포인트 하락합니다.n에서는 정확도 손실을 감수하고 INT8을 적용할 가치가 거의 없습니다. - 하드웨어를 구매하기 전에 내장 GPU를 사용해 보세요. 같은 칩의 Arc iGPU(
device="intel:gpu")는 YOLO26n FP32를 9.13ms, YOLO26m을 34.47ms에 실행했습니다.
사용 중인 CPU에서 정밀도별 성능 비교#
각 정밀도를 내보내고 바로 검증한 후 다음 정밀도를 내보내세요.
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/각 줄에서 확인할 수 있는 내용:
- FP32와 FP16의 점수는 동일하고 FP16의 크기는 절반(5.1MB 대 9.6MB)이지만, 두 모델이 같은 폴더에 기록되었습니다. 두 모델을 모두 먼저 내보낸 다음 나중에 검증했다면 FP16을 두 번 측정했을 것입니다.
- INT8의 크기는 3.2MB이며 정확도가 3.2포인트 하락했습니다. COCO8의 이미지 4장으로 캘리브레이션했기 때문입니다. 경고 메시지도 이를 알려줍니다. 실제 캘리브레이션에는 자체 YAML(
fraction은 사용할 이미지 수를 제한함)에 지정된 실제 운영 환경과 유사한 이미지 수백 장이 필요합니다. - 이 측정으로는 속도를 알 수 없습니다. 속도는 아래의 벤치마크를 사용해 측정하세요.
내보낸 모델을 특정 Intel 장치에서 실행하려면 다음을 따르세요.
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # or intel:gpu, intel:npu
전체 폴더를 배포하세요. yolo26n.xml(그래프), yolo26n.bin(가중치), metadata.yaml입니다. intel:gpu과 intel:npu는 Intel 하드웨어가 필요합니다.
ONNX Runtime과 비교해 실행 시간 측정#
정확도는 확인했으므로, 실제로 처리할 부하를 적용한 상태에서 타깃 장치의 속도를 측정해야 합니다. 첫 번째 강의의 pick_runtime.py을 CANDIDATES = ("onnx", "openvino")과 함께 실행하세요. 다른 작업이 CPU를 함께 사용하는 Apple 실리콘 테스트 노트북에서 측정한 결과는 다음과 같습니다.
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO는 중앙값은 더 좋았지만 꼬리 지연 시간은 훨씬 나빴습니다. Ultralytics 래퍼는 LATENCY 힌트(로그에 Using OpenVINO LATENCY mode for batch=1 inference on CPU으로 표시됨)를 사용해 OpenVINO를 컴파일하여 각 요청을 CPU 코어 전반에 분산합니다. 다른 작업이 같은 코어를 사용하면 가장 느린 요청의 지연 시간이 특히 커집니다. 전용 Intel 장치에서는 대개 위의 공개 벤치마크와 비슷한 결과가 나오지만, 실제 p95는 자체 측정으로만 확인할 수 있습니다.
결정 규칙:
주의할 점#
증상: FP16 내보내기 파일은 크기가 절반이지만 속도는 전혀 빨라지지 않습니다. 해결 방법: 대부분의 CPU에서 플러그인은 자체적으로 실행 정밀도를 선택합니다. 다운로드 용량을 줄이려면 FP16을 사용하고, 속도를 높이려면 INT8 또는 iGPU를 사용합니다.
증상: FP32와 FP16이 같은 파일이어서 동일한 수치가 보고됩니다. 해결 방법: FP32와 FP16 내보내기는 *_openvino_model/ 폴더를 공유하므로, 내보내기 직후 검증하거나 폴더 이름을 변경합니다.
증상: 평균은 괜찮아 보이지만 부하가 큰 순간에는 여전히 프레임이 누락됩니다. 해결 방법: 프로덕션 부하가 실행되는 상태에서 추론 시간을 측정하고, 평균이 아닌 p95를 기준으로 판단합니다. 한 서버에서 여러 스트림을 처리하려면 지연 시간 및 처리량 모드 가이드에 나온 것처럼 OpenVINO 런타임으로 .xml을 직접 로드해 THROUGHPUT 힌트와 함께 컴파일합니다.
macOS와 Windows에서는 검증을 시작할 때 작업자 프로세스가 생성되며, 이 프로세스는 스크립트를 다시 임포트합니다. if __name__ == "__main__":이 없으면 이 강의의 테스트 실행에서 해당 작업자 프로세스들이 내보내기를 반복해 몇 분을 낭비하고, 측정하려던 CPU 자원을 놓고 경쟁했습니다.
정답 보기
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
위의 Core Ultra 7 155H 수치를 사용한 의사 결정 예시:
| 옵션 | mAP50-95 | 규모 | 이미지당 ms |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
통합 GPU에서 OpenVINO FP32를 배포합니다. 가장 빠른 옵션이며 성능 손실이 없습니다. 반면 CPU에서 INT8을 사용하면 2ms를 절약하는 대신 1.2포인트의 손실이 발생합니다. YOLO26m 배포에서는 1.7포인트의 손실이 허용 범위 내라면 CPU INT8이 2.9배 더 빠르므로 선택이 달라집니다.