TensorRT로 최적화
FP16 TensorRT 엔진을 빌드하고, INT8의 정확도 비용을 감수할 가치가 있는지 판단한 다음, 배포 전에 엔진을 게이트 기준에 따라 검증하세요.
NVIDIA GPU에서는 TensorRT FP16 엔진이 대개 가장 적은 비용으로 얻을 수 있는 속도 향상입니다. Ultralytics A100 벤치마크에서 mAP 변화 없이 약 1.5배 빨라집니다. INT8은 더 빠르지만, 사후 학습 INT8 적용 시 COCO에서 YOLO26s부터 YOLO26m까지 mAP가 4~6포인트 하락했습니다. 이 과정에서는 어떤 단계를 진행하고 있는지 파악하고, 사용자가 경험하기 전에 성능을 측정하는 방법을 알아봅니다.
실습형
이 강의의 코드를 실행하려면 TensorRT가 설치된 NVIDIA GPU가 필요합니다. 표시된 모든 인수는 내보내기 모드 문서의 format=engine 항목에 나와 있습니다.
FP16은 안전한 첫 단계입니다#
Volta 이후의 NVIDIA GPU에는 FP16 텐서 코어가 있으며, 탐지 모델은 추론 시 FP32가 거의 필요하지 않습니다. 다음 단계부터 시작하세요.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4) # FP16 엔진, 최대 4 GiB의 빌더 작업 공간workspace은 빌드 중 TensorRT가 사용할 수 있는 GPU 메모리 양을 제한합니다. 설정하지 않으면 TensorRT가 알아서 결정합니다. TensorRT 통합 페이지에 다음 A100 결과(YOLOv8n, 640px)가 공개되어 있습니다.
| 정밀도 | 예측, 배치 8(ms) | COCO 검증 mAP50-95 |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
이 모델은 YOLO26보다 오래된 모델이지만, 성능 간 절충의 양상은 유효합니다. FP16은 추가 비용 없이 약 1.5배 빨라졌고, INT8은 여기에 1.2배의 속도를 더 얻는 대신 정확도가 4포인트 하락했습니다. FP16으로 예산을 충족한다면 FP16을 배포하세요.
로컬 NVIDIA GPU가 없나요? Ultralytics Platform의 내보내기 탭에서 선택한 클라우드 GPU로 엔진을 빌드할 수 있으며, 이미지 크기, 정밀도, 배치, 동적 입력, NMS, 작업 공간 옵션을 동일하게 설정할 수 있습니다.

배포할 GPU 제품군을 선택하세요. 스크린샷의 엔진은 RTX 5090에서 빌드되었으며 해당 제품군에서만 실행됩니다.
INT8에는 캘리브레이션 데이터가 필요합니다#
INT8 양자화는 각 레이어의 활성값을 256개 수준으로 매핑합니다. 해당 범위를 정하기 위해 내보내기 도구는 캘리브레이션 이미지를 모델에 입력하고 관찰된 활성값을 기록하므로, 이미지는 실제 운영 데이터와 유사해야 합니다.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # 캘리브레이션 이미지는 이 데이터셋의 val 분할에서 가져옵니다. my_dataset/data.yaml을 사용하세요.
    fraction=1.0,  # 사용할 이미지의 비율(또는 개수)
    batch=8,  # 캘리브레이션 배치가 클수록 범위가 더 안정적으로 설정됩니다.
    dynamic=True,  # batch=8이면 엔진은 1~8개의 배치를 허용합니다.
    workspace=4,
)
INT8의 정확도 비용은 모델에 따라 다릅니다. 내보내기 모드 문서에서는 COCO val에서 YOLO26 TensorRT 엔진의 성능(mAP50-95)을 측정했습니다.
| 모델 | FP32 엔진 | INT8, 캘리브레이션 적용(PTQ) | 양자화 인식 학습(QAT) 후 INT8 적용 |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
캘리브레이션만으로도 YOLO26n은 1포인트, 더 큰 모델은 4~6포인트의 정확도를 잃습니다. QAT는 quantize=8을 사용해 train에서 모델을 미세 조정하여 가중치가 INT8을 견딜 수 있게 합니다. 체크포인트에는 자체 범위 정보가 포함되므로 INT8 내보내기에 캘리브레이션 데이터가 필요하지 않으며, FP32와의 차이는 1~2포인트 이내입니다. 다음 기준으로 결정하세요.
배포 전에 엔진을 게이트 기준으로 검증하세요#
모든 엔진은 배포 GPU에서 동일한 검사를 통과해야 합니다.
| 검사 항목 | 게이트 기준 |
|---|---|
| 검증 데이터셋의 mAP50-95 | FP16은 FP32보다 0.5포인트 이내여야 하며, INT8은 서면으로 설정한 예산 이내여야 합니다. |
| 클래스별 AP | 어떤 클래스도 약 1포인트 넘게 하락하지 않아야 합니다(소규모 클래스에서 변동이 가장 큼). |
| p95 지연 시간 | 실제 운영 배치 크기에서 예산 미만이어야 합니다. |
| 운영 임계값 | 엔진 자체의 F1 곡선에서 conf을 다시 선택합니다. |
| 결정성 | 같은 이미지를 두 번 입력하면 정확히 같은 박스가 반환됩니다. |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
속도 향상의 원리#
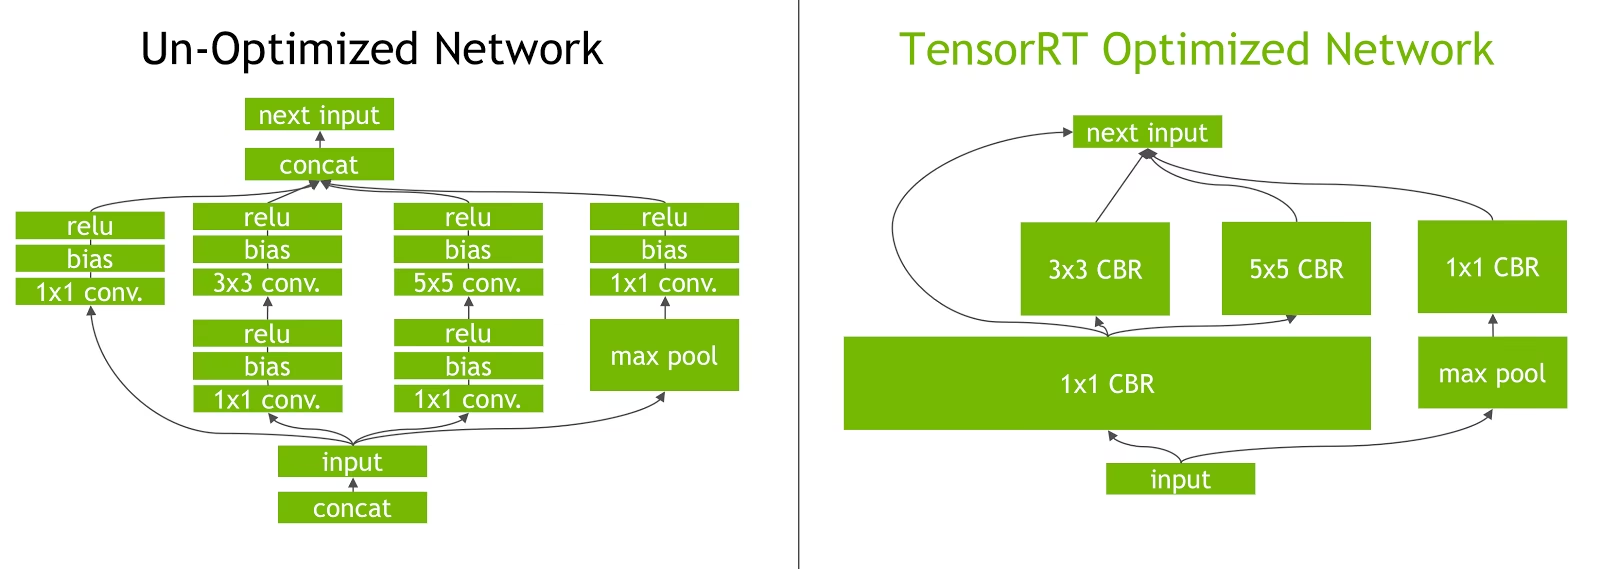
TensorRT는 각 컨볼루션, 바이어스, ReLU를 하나의 커널(오른쪽의 "CBR" 블록)로 융합하고 연결 단계를 제거합니다. 그 결과 GPU가 실행하는 커널 수와 이동하는 데이터가 줄어듭니다. YOLO26에서는 네트워크 전반의 conv-BN-activation 체인, 백본의 어텐션(PSA) 블록, 그리고 탐지 헤드의 여러 작은 연산에서 효과를 얻습니다. 엔진이 여전히 느리다면 trtexec 또는 NVIDIA Nsight로 프로파일링하세요. 한 레이어가 전체 시간의 30% 이상을 차지하는 경우가 많습니다.
주의할 점#
증상: INT8을 사용하면 COCO에서는 1점, 카메라 데이터에서는 6점 하락합니다. 해결 방법: 자체 검증 세트에서 보류한 일부 데이터로 보정합니다. NVIDIA는 대표성 있는 이미지를 최소 500장 사용할 것을 권장합니다. 보정 결과는 장치에 따라서도 다르므로 배포할 GPU에서 보정합니다.
증상: 동일한 conf에서 INT8로 전환한 후 재현율이 떨어집니다. 해결 방법: INT8은 신뢰도 값을 바꿀 수 있으므로 INT8 엔진 자체의 F1 곡선을 기준으로 conf을 다시 선택합니다.
증상: 엔진을 배포 시스템에서 역직렬화할 수 없거나 예상보다 느리게 실행됩니다. 해결 방법: TensorRT 및 CUDA 런타임이 일치하는 배포 GPU 제품군에서 빌드하고, 장치에서 다시 빌드할 수 있도록 .onnx을 함께 배포합니다. 빌드 중 보정이 중단되면 workspace을 높이거나 imgsz 또는 batch을 낮춥니다.
Jetson에서는 DeepStream이 하드웨어 가속 비디오 파이프라인에서 생성된 엔진을 실행하고, 데이터 센터에서는 Triton Inference Server가 해당 엔진을 서비스합니다.
정답 보기
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
통과한 보고서의 예시는 다음과 같습니다. 정확도 차이는 0.5포인트 미만이고, p95 지연 시간은 예산 미만이며, 결정은 FP16 배포입니다. p95 지연 시간이 기준을 충족하지 못한다면 자체 캘리브레이션 YAML을 사용해 INT8을 내보내고 동일한 두 줄의 명령을 다시 실행하세요. 시작 전에 정한 예산 이내로 정확도 차이를 유지하는 경우에만 INT8을 배포하고, 그렇지 않다면 QAT를 시도하거나 더 작은 모델을 사용하세요.