멀티 스트림 추론
배치 추론, 제한된 큐, 측정된 프레임 드롭을 사용해 하나의 모델로 여러 카메라를 처리합니다.
카메라 하나를 처리하는 시스템도 네 대를 연결하면 몇 분씩 뒤처질 수 있지만, 오류는 발생하지 않습니다. 결과가 점점 늦게 도착하다가 결국 메모리가 부족해질 뿐입니다. 여기서 사용한 노트북 CPU에서는 30 FPS 스트림 하나는 실시간 처리했지만, 네 개에서는 프레임의 절반을 드롭했고, 여덟 개에서는 3분의 2가 넘는 프레임을 드롭했습니다. 이 강의에서는 하드웨어 용량을 산정하는 데 필요한 이 값을 측정하는 파이프라인을 구축합니다.
실습형
시간이 소요되는 단계#
각 프레임은 네 단계를 거칩니다:
| 단계 | 일반적인 처리 비용 | 실행 장치 |
|---|---|---|
| 디코딩(RTSP 또는 파일 → 배열) | 1080p 프레임당 5–20 ms | CPU |
| 전처리(레터박스, 정규화) | 약 1 ms | CPU |
| 추론 | 몇 ms(GPU)에서 수십 ms(CPU) | 가속기 |
| 후처리, 트래킹, 싱크 | 몇 ms, 느린 데이터베이스에서는 더 오래 걸립니다. | CPU |
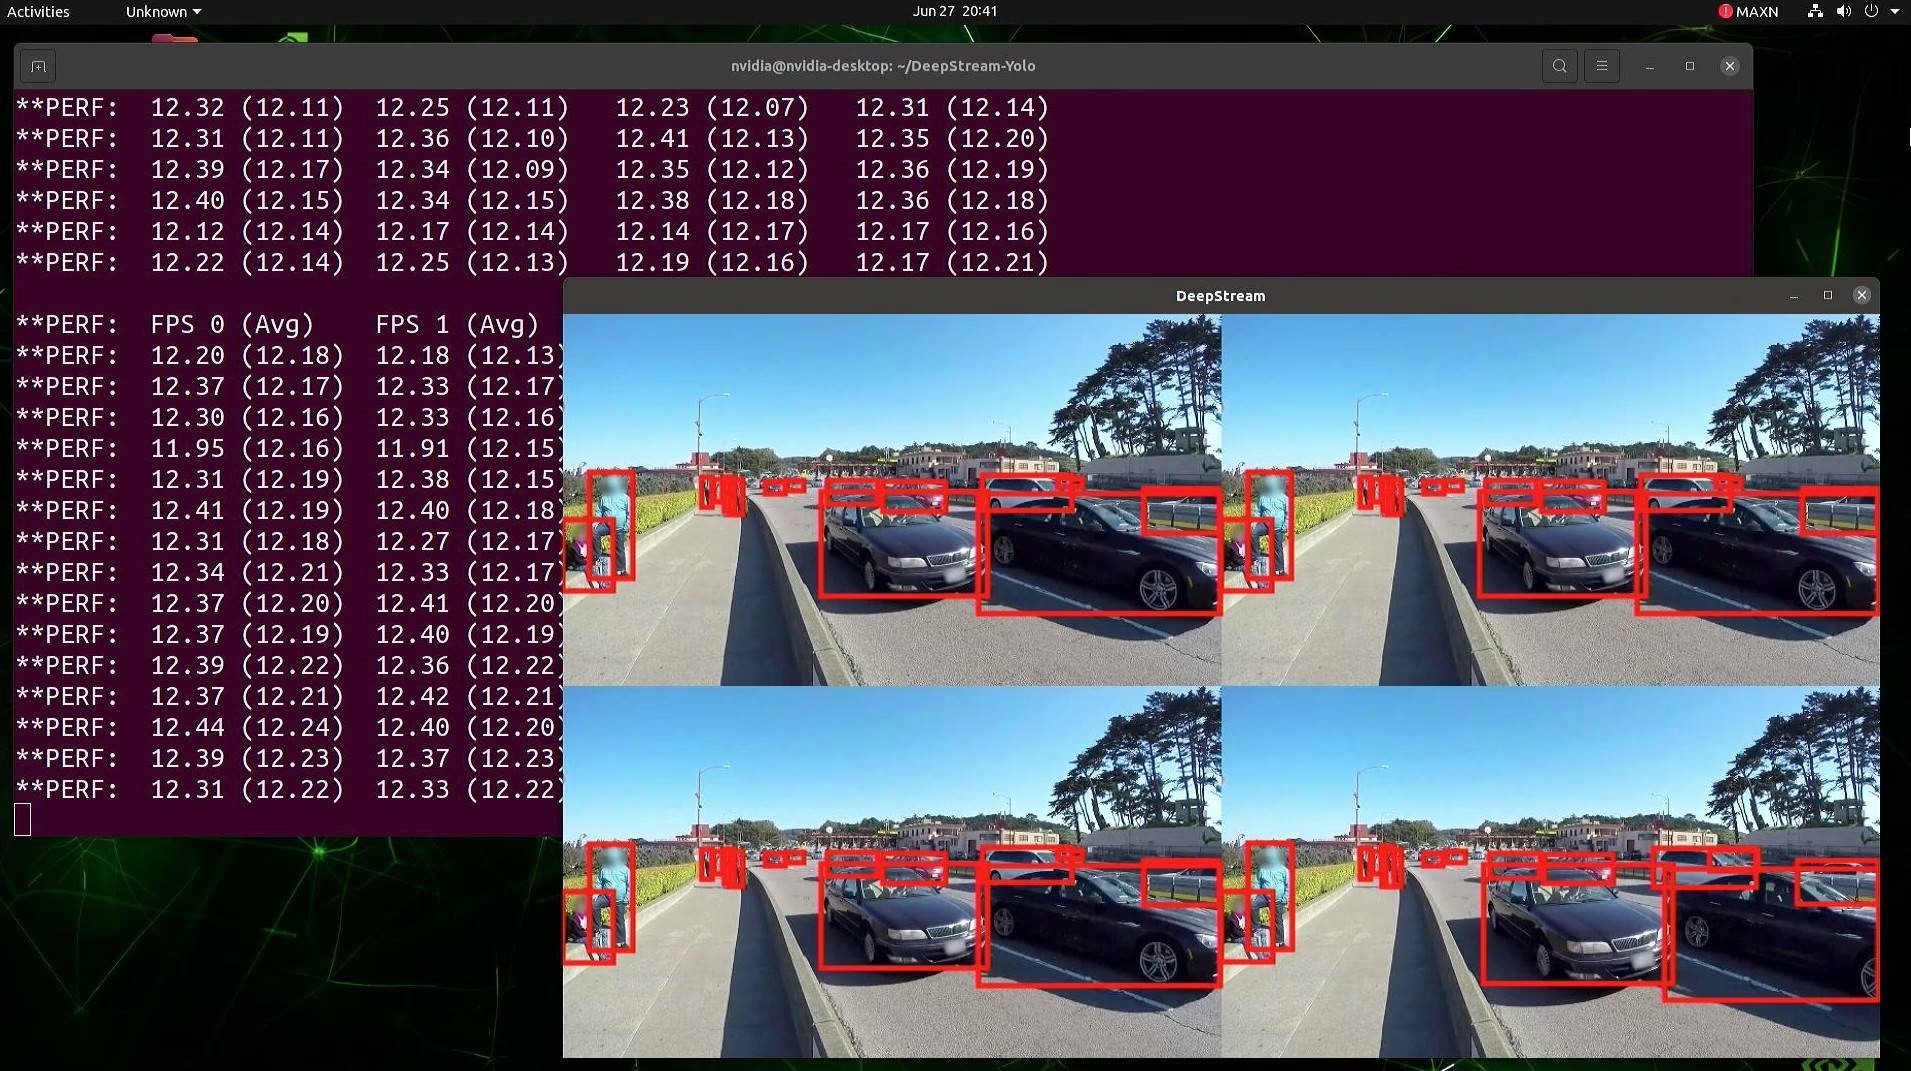
단일 스레드에서 카메라별로 각 단계를 순차적으로 실행하면, 프레임을 디코딩하는 동안 가속기가 유휴 상태가 됩니다. 해결 방법은 단계를 분리하는 것입니다. 위의 DeepStream 파이프라인이 바로 이 방식을 사용합니다. 스트림 네 개가 하나의 장치를 공유하며, 각 스트림의 FPS를 개별적으로 보고합니다(여기서는 약 12 FPS). Python에서도 같은 구조를 사용할 수 있습니다:
기본 제공 방식: .streams 파일#
Ultralytics는 여러 소스를 자동으로 배치 처리합니다. .streams 파일에 소스를 한 줄에 하나씩 입력한 다음 Predict 또는 Track 모드에 전달하세요. 각 스트림에는 자체 리더 스레드와 트래커가 할당되며, 반복할 때마다 모든 스트림을 대상으로 배치 순전파를 한 번 실행합니다:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # 프로덕션 환경: 줄마다 rtsp:// URL 하나

model = YOLO("yolo26n.pt")  # 프로덕션 환경에서는 최적화된 내보내기 모델을 사용하세요.
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path에서 이 결과를 생성한 스트림을 확인할 수 있습니다.
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})공항 클립은 150프레임이지만 반복 처리는 가장 짧은 스트림이 끝날 때 중단되므로 두 스트림 모두 62개의 결과를 생성했습니다. stream_buffer=True은 모든 프레임을 처리했으며, 녹화된 파일에는 이 방식이 적합합니다. 실시간 카메라에서는 기본값인 False을 사용하여 모델이 느릴 때 오래된 프레임을 건너뛰고 처리 지연이 누적되지 않게 하세요. 스트림별 처리량을 높이려면 TensorRT 또는 OpenVINO로 내보낸 모델을 함께 사용하세요.
사용자 지정 방식: 드롭 카운터를 사용하는 생산자-소비자 구조#
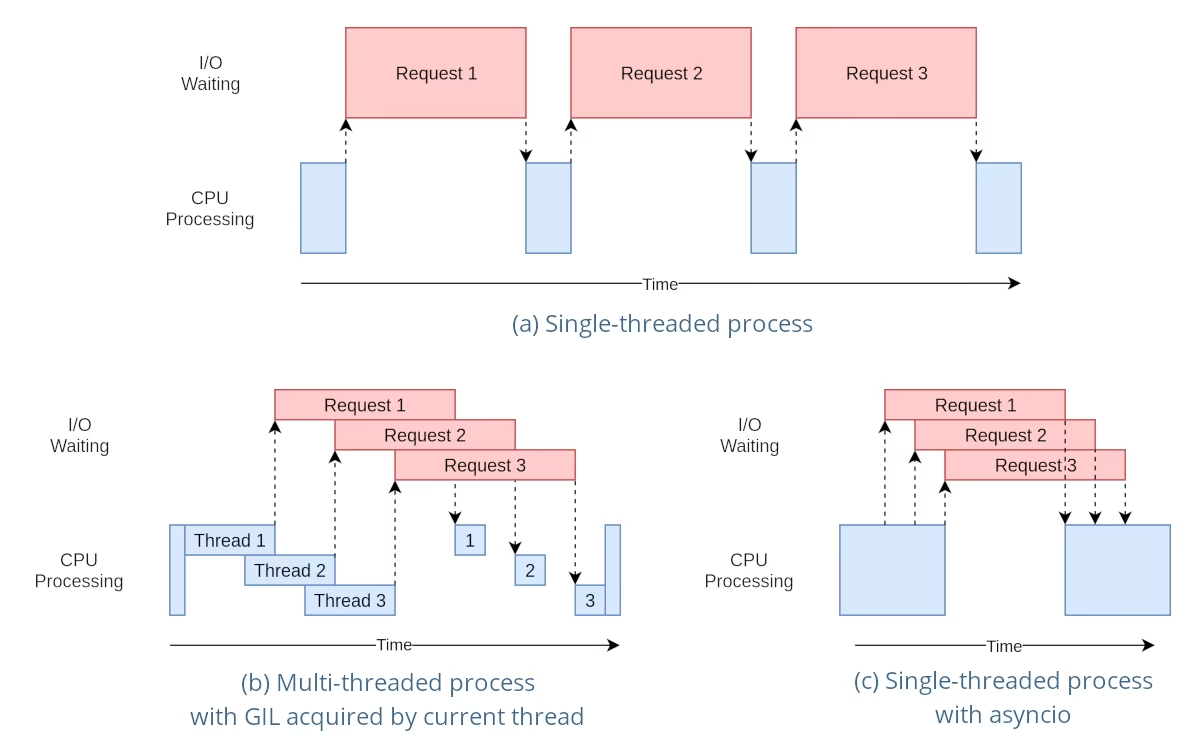
이 다이어그램은 이 파이프라인에서 스레드가 효과적인 이유를 보여줍니다. 디코딩은 대부분 대기 작업(분홍색 I/O 막대)이며, OpenCV와 PyTorch는 작업 중 Python의 GIL을 해제하므로 디코더 스레드가 효율적으로 병렬 실행됩니다(패널 b). 무거운 Python 후처리는 병렬로 실행되지 않으므로 별도 프로세스로 옮기세요.
자체 싱크, 카메라별 로직 또는 명시적인 드롭 지표가 필요한 경우 파이프라인을 직접 구축하세요. 디코더 스레드는 모델에 접근하지 않으며, 하나의 컨슈머 루프가 모델을 담당합니다. 이 구조는 스레드 안전 추론 원칙도 준수합니다:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]두 클립의 프레임 수는 각각 62개와 150개이며, 모든 프레임은 처리되거나 드롭됩니다(56 + 6 = 62, 131 + 19 = 150). 따라서 카운터가 모든 프레임을 집계합니다. 212개 프레임 중 25개가 드롭되었습니다. 이 노트북의 CPU는 PyTorch에서 yolo26n을 사용해 30 FPS 스트림 두 개를 처리할 수 없습니다. 클립을 반복해 더 많은 카메라를 시뮬레이션하고 한 번에 테스트한 결과:
| 스트림 수(각각 30 FPS) | 드롭된 프레임 수 |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
측정값을 바탕으로 용량 계획하기#
장치당 스트림 수 ≈ 지속 처리량(사용자의 배치 크기에서 모델이 처리하는 초당 프레임 수) ÷ 스트림당 요구 FPS입니다. 실제 하드웨어에서 앞선 강의의 최적화된 내보내기 모델을 사용해 처리량을 측정하고, 피크에 대비해 20–30%의 여유 용량을 확보하며, 드롭이 0보다 커지면 알림을 설정하세요. 고해상도에서는 픽셀 수에 비례해 계산량이 증가합니다. 1280×1280은 640×640보다 계산량이 약 4배 많습니다. 대규모 배포 환경에는 Triton Inference Server와 Jetson의 DeepStream이 자연스러운 프로덕션 실행 환경입니다.
주의할 점#
증상: model.track(["cam1.mp4", "cam2.mp4"])이 목록을 스트림이 아닌 이미지 배치로 처리합니다. 해결 방법: 소스를 한 줄에 하나씩 .streams 파일에 작성합니다.
증상: 파일마다 프레임이 한두 개만 반환됩니다. 해결 방법: stream_buffer=False은 오래된 프레임을 버리고 파일 리더는 모델보다 앞서 진행하므로, 파일에는 stream_buffer=True을 설정하고 라이브 카메라에는 기본값을 유지합니다.
증상: 부하가 걸리면 간혹 결과가 잘못되거나 뒤섞입니다. 해결 방법: 여러 스레드에서 하나의 YOLO 인스턴스를 동시에 호출하지 마세요. 위와 같이 하나의 소비자가 모델을 소유하게 하거나 각 추론 스레드 안에서 모델을 생성합니다.
증상: 지연 시간이 매분 증가하고 프로세스가 종료될 때까지 메모리 사용량이 늘어납니다. 해결 방법: 큐가 가득 차면 프레임을 버리는 제한된 크기의 큐와 드롭 카운터를 사용합니다. 실시간 시스템은 과부하 시 지연되는 대신 프레임을 버려야 합니다.
정답 보기
producer_consumer.py의 SOURCES 줄 바로 뒤에 다음 줄을 추가하여 스트림 수를 명령줄 인수로 지정하세요:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # 시뮬레이션할 카메라 수
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
그런 다음 값을 바꾸어 테스트하세요:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]이 장비에서 처리 가능한 스트림은 한 개입니다. 두 개부터 드롭이 시작됩니다. 카메라 네 대를 처리하려면 더 빠른 런타임으로 내보내기(강의 3 및 4), imgsz 낮추기 또는 가속기 사용을 적용한 다음 테스트를 다시 실행하세요.