Escolhe a tarefa e planeia o pipeline
Associa cada questão sobre o produto a uma das sete tarefas Ultralytics YOLO, com os respetivos pesos, campo de resultado, formato dos rótulos e métrica de aprovação, e comprova o plano executando cada tarefa numa imagem.
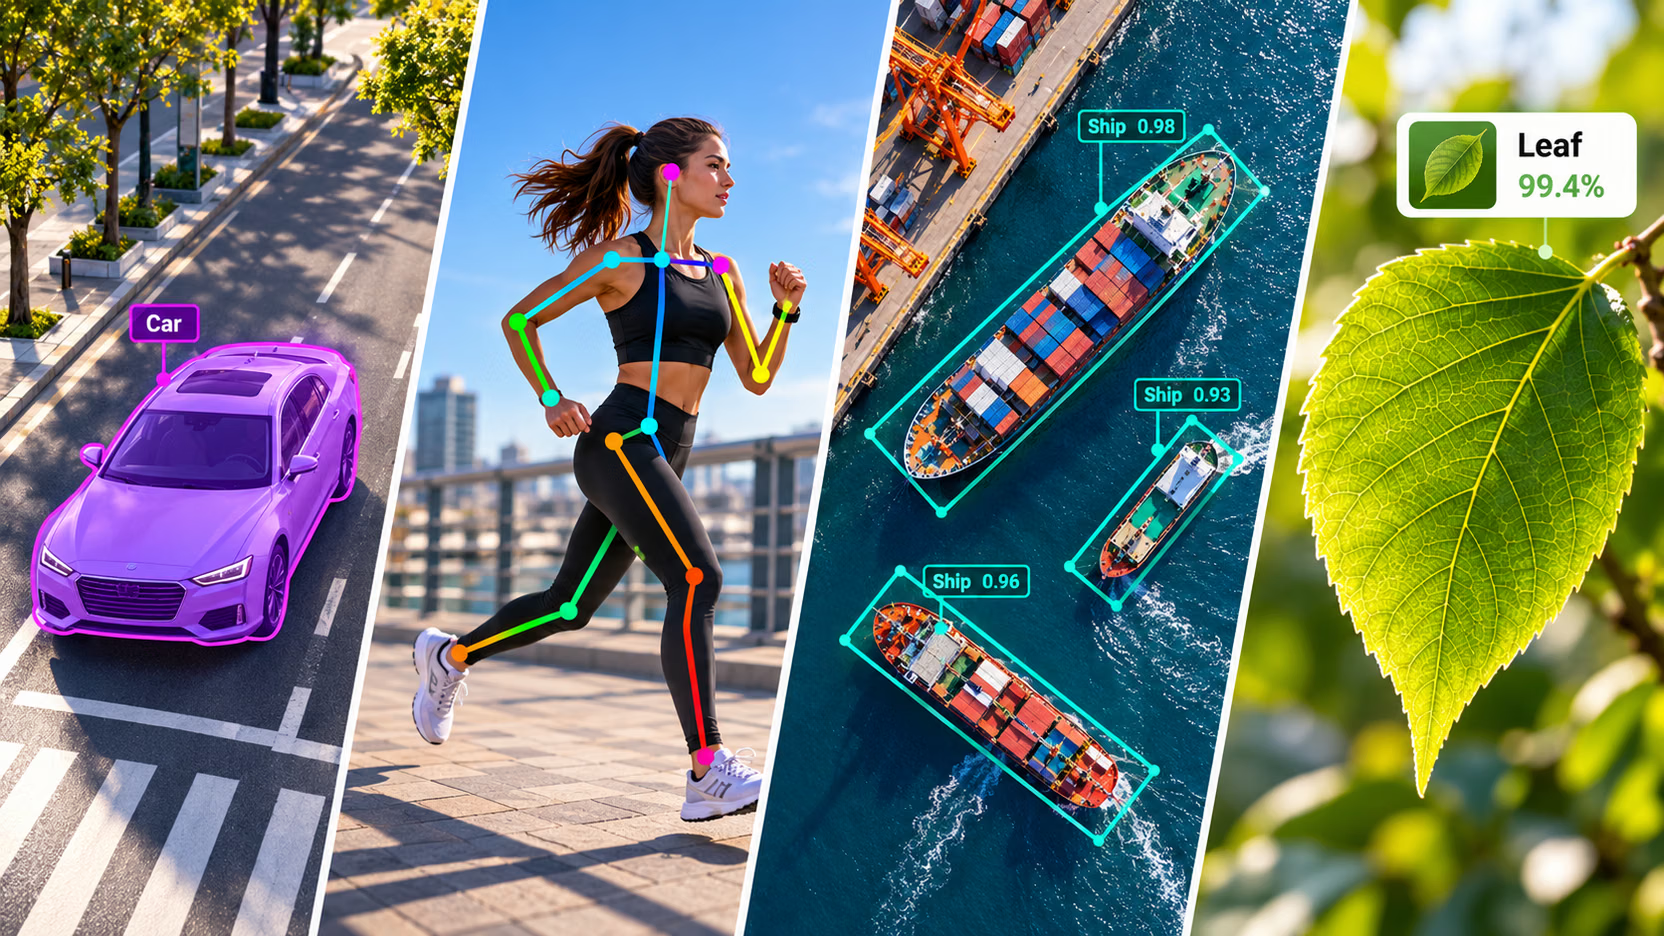
Depois de lançar um detetor, os pedidos seguintes raramente são «mais caixas». São «qual é a dimensão do derrame», «as costas do trabalhador estão curvadas», «em que direção está virado o navio» e «esta peça é refugo». Na fotografia de rua usada ao longo deste curso, a caixa delimitadora do autocarro ocupa 48% do enquadramento, enquanto o autocarro em si ocupa 29%; por isso, calcular a área com base na caixa daria um resultado errado em mais de metade. A tarefa escolhida determina o formato dos rótulos, por isso escolhê-la antes de alguém começar a anotar é a decisão mais económica do projeto; alterá-la mais tarde significa voltar a anotar.
Prático
Uma fotografia, quatro respostas diferentes#

Faz uma pergunta sobre uma fotografia — que parte deste enquadramento é autocarro e a que distância está? — e deixa quatro tarefas Ultralytics YOLO responderem:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraLê linha a linha:
- detect responde a onde. A caixa também inclui a estrada por baixo do autocarro e as quatro pessoas à frente dele, pelo que, como medida de área, é 63% demasiado grande.
- segment responde a que forma. 29,2% é a área real do autocarro na imagem, o valor a usar em qualquer regra de área, cobertura ou sobreposição.
- semantic responde a que píxeis pertencem a cada classe. A área é semelhante à da máscara, mas o modelo classifica o autocarro como
train: atribui às superfícies as classes do conjunto de treino (Cityscapes, lição 4) e nunca distingue um veículo de outro. - depth responde a a que distância. A profundidade mediana dentro da máscara do autocarro é 4,5 m — duas tarefas combinadas para responder a uma pergunta a que nenhuma delas responde isoladamente.
Se o valor apresentado pelo teu produto for uma área, uma proporção de cobertura ou uma sobreposição, uma caixa é a ferramenta errada. Usa uma máscara (segmentação de objetos) ou um mapa de classes (segmentação semântica) para superfícies.
As sete tarefas em resumo#
Computer Vision Foundations explica em detalhe como escolher entre tarefas — consulta novamente As sete tarefas de visão se a escolha não for óbvia. Este é o resumo prático para o resto do curso. Cada linha corresponde a uma tarefa que o pacote ultralytics instalado consegue treinar, validar, executar para fazer previsões e exportar através da mesma API; a visão geral das tarefas é a referência completa.
| Pergunta a que o resultado responde | Tarefa | Pesos YOLO26 | Campo de resultado | Formato dos rótulos | Métrica de aprovação |
|---|---|---|---|---|---|
| Onde está cada objeto? | detect | yolo26n.pt | boxes | classe + caixa | mAP50-95 de caixas |
| Qual é a forma e a área exatas de cada objeto? | segment | yolo26n-seg.pt | masks + boxes | classe + polígono | mAP50-95 de máscaras |
| A que classe pertence cada píxel? | semantic | yolo26n-sem.pt | semantic_mask | Mapa de classes PNG ou polígonos | mIoU |
| Onde estão as articulações ou os pontos de referência? | pose | yolo26n-pose.pt | keypoints + boxes | classe + caixa + pontos-chave | mAP50-95 de pose (OKS) |
| Como está rodado cada objeto? | obb | yolo26n-obb.pt | obb | classe + 4 vértices | mAP50-95 de OBB |
| O que é esta imagem inteira (ou recorte)? | classify | yolo26n-cls.pt | probs | uma pasta por classe | precisão top-1 |
| A que distância da câmara está cada píxel? | depth | yolo26n-depth.pt | depth | mapa de profundidade por imagem (PNG de 16 bits ou NPY) | δ1 (delta1) |
Já colocas a primeira linha em produção. As lições 2 a 8 ensinam as cinco linhas intermédias, e as lições 9 e 10 encadeiam-nas e colocam-nas em produção. A última linha, a estimativa monocular de profundidade, prevê uma distância em metros para cada píxel de uma única imagem. Os rótulos da estimativa monocular de profundidade provêm de sensores de profundidade ou de renderizadores 3D, e não de anotadores, pelo que esta tarefa tem o seu próprio formato de conjunto de dados; este curso inclui a estimativa monocular de profundidade em todos os pontos em que o fluxo de trabalho é partilhado: neste plano, no ciclo de validação e na verificação da exportação da última lição.
Escolhe uma pergunta de cada vez#
Segue as perguntas por ordem e para no primeiro «sim»:
O diagrama cobre os casos mais comuns. Quatro critérios de desempate resolvem a maioria dos restantes:
| Se o pedido… | Escolhe | Porque |
|---|---|---|
| precisa de uma contagem e de uma área («quantos derrames e qual a dimensão de cada um») | segment | a segmentação semântica funde objetos que se tocam numa única região |
| envolve objetos compridos e estreitos, lado a lado e vistos de cima | obb | as caixas alinhadas com os eixos sobrepõem-se e o NMS elimina objetos verdadeiros, mesmo que nunca consultes o ângulo |
| precisa de distinguir frente de trás, ou esquerda de direita | pose | uma OBB fornece um eixo, não um rumo |
| mostra exatamente um item por imagem, por definição (uma estação de inspeção fixa) | classify | os rótulos mais baratos e o modelo mais rápido |
A tarefa fica definida quando crias o conjunto de dados — na Ultralytics Platform, é o campo Task Type da caixa de diálogo New Dataset —, por isso esta escolha tem de ser feita antes do primeiro rótulo:

Uma API, sete campos de resultado#
Todas as tarefas usam a mesma chamada; o modelo obtém a tarefa a partir do ficheiro de pesos. O que muda é o campo do resultado que é preenchido, e é esse campo que o teu código vai ler:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Os resultados de segmentação e pose mantêm boxes, por isso o código de deteção que já tens continua a funcionar com eles. Os resultados de classificação, segmentação semântica e profundidade descrevem a imagem inteira e não têm campos por objeto.
O código de deteção que percorre result.boxes falha com TypeError: 'NoneType' object is not iterable num modelo OBB: result.boxes é None, e as deteções rodadas só existem em result.obb. Adapta o código de deteção a OBB lendo result.obb, em vez de verificar None e obter zero deteções.
Quando um modelo não chega#
A maioria dos sistemas de produção que vão além da deteção segue uma de três estruturas:
- Detetar e depois classificar. O detetor encontra objetos pequenos num enquadramento grande; um classificador de imagens analisa em detalhe cada recorte na resolução original: tipo de capacete, grau de defeito, referência do produto.
- Pose mais rastreamento. Os pontos-chave descrevem uma imagem; um rastreador transforma-os numa série temporal por pessoa, que podes usar para contar repetições ou detetar quedas.
- Segmentar e depois medir. O modelo devolve píxeis; código simples transforma-os em áreas, larguras, rácios de cobertura ou distâncias (com profundidade).
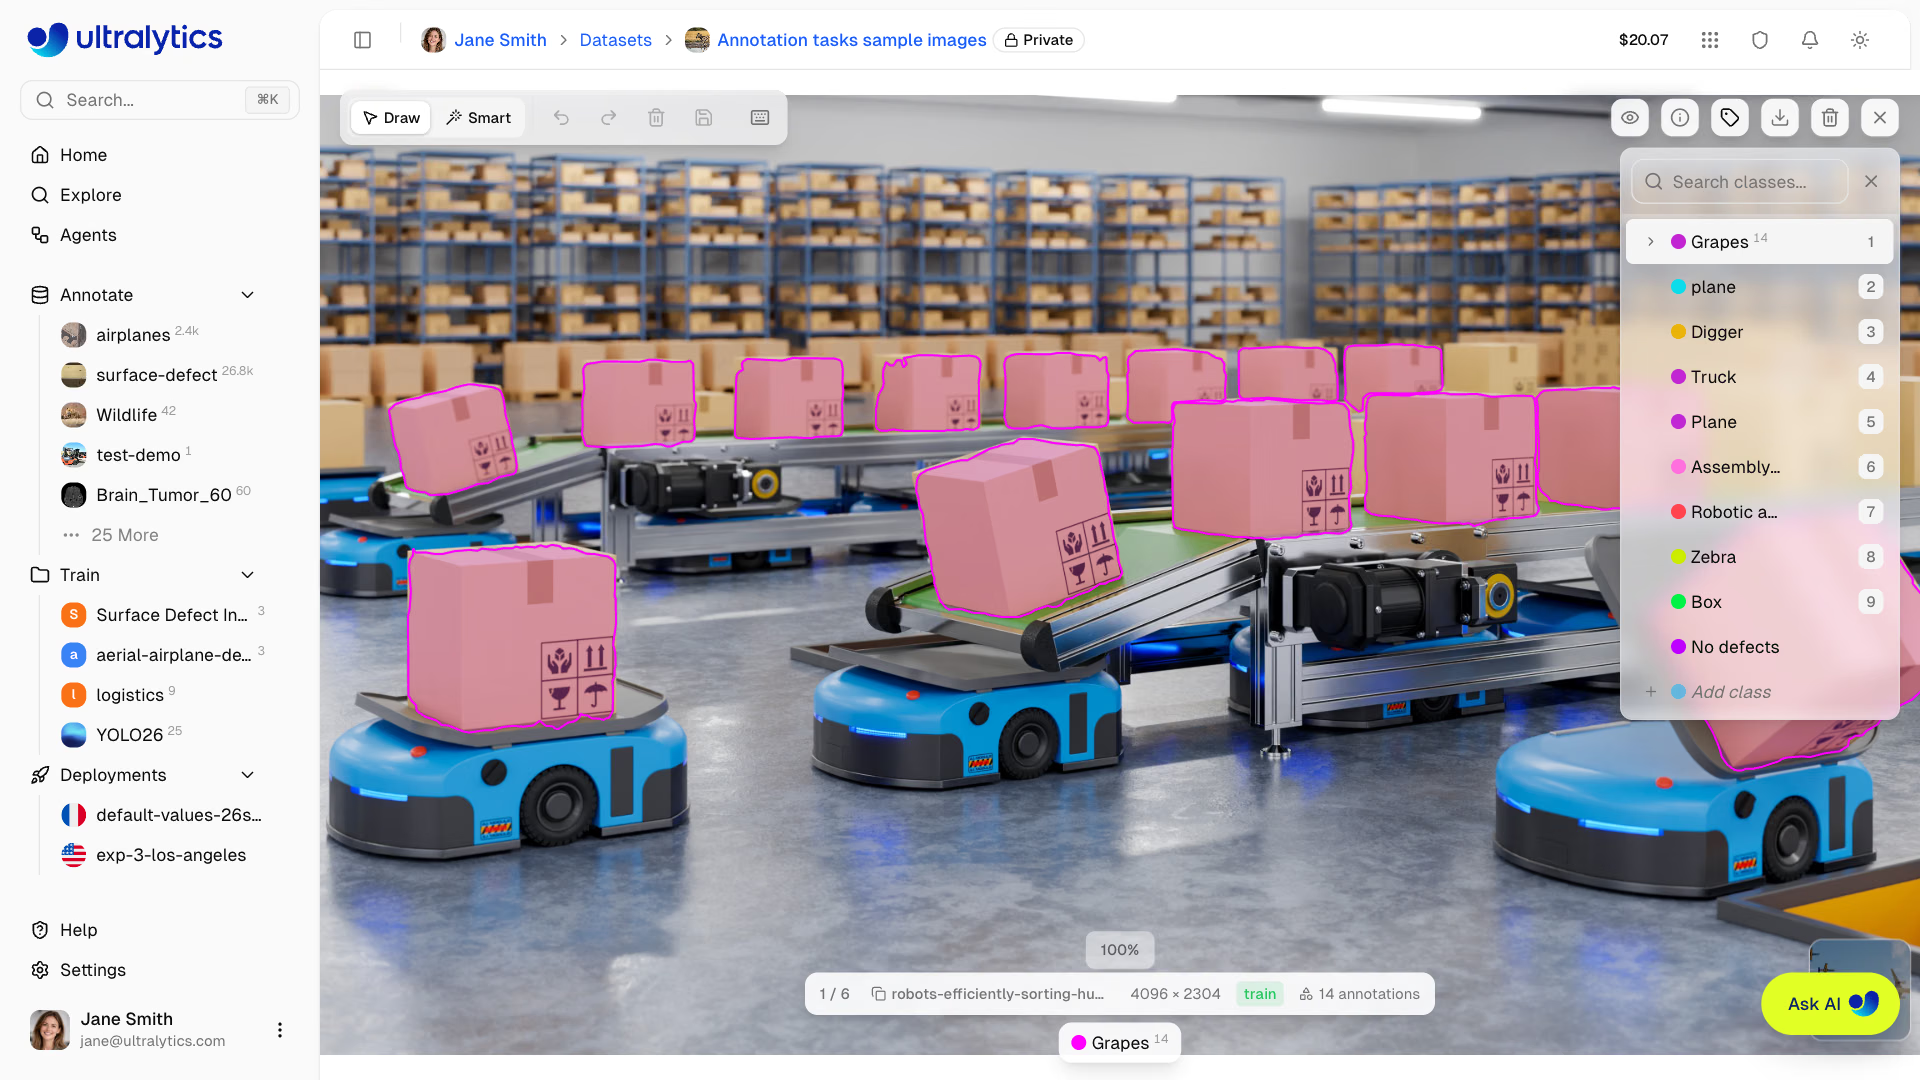
Os rótulos de um pipeline de segmentação e medição são um polígono por objeto, como nestas encomendas em robôs de armazém no editor da Ultralytics Platform:
Um segundo modelo acrescenta latência de inferência, um segundo conjunto de dados para etiquetar e manter e um segundo modelo para monitorizar. Encadeia modelos apenas quando uma tarefa não consegue responder à pergunta — um plano com um modelo que consegues disponibilizar é melhor do que um plano com três modelos que não consegues etiquetar.
Armadilhas#
Sintoma: a equipa etiqueta polígonos porque as máscaras ficam bem nas demonstrações, mas o produto só lê uma contagem. Solução: antes de etiquetar, identifica a linha de código que consome o resultado. Se ninguém usar o contorno, disponibiliza um detetor: as caixas são mais rápidas de etiquetar e de executar.
Sintoma: após um mês de etiquetagem, alguém percebe que o produto precisa de uma orientação e que o conjunto de dados tem etiquetas OBB, que apenas indicam um eixo. Solução: escreve o atributo exato no plano (result.masks.xy, result.keypoints.xy, result.obb.xywhr) e executa tasks.py com os pesos escolhidos antes da primeira etiqueta.
Sintoma: um classificador com 95% de precisão em fotografias nítidas de produtos falha na maioria dos recortes do detetor em produção. Solução: cria o conjunto de dados da segunda etapa a partir dos próprios recortes da primeira etapa, com o desfoque e o enquadramento reais; a lição 9 mostra como.
Mostrar solução
Para o pedido relativo às paletes:
| Linha | Escolha |
|---|---|
| Pergunta | Alguma parte de uma palete ultrapassa a linha da viga da estante? |
| Tarefa | segment — a saliência depende do contorno da palete; a caixa também abrange o espaço por baixo da palete e a carga por cima |
| Pesos | yolo26n-seg.pt, ajustado com imagens das câmaras do armazém |
| Formato dos rótulos | Um polígono por palete |
| Campo de resultado | result.masks.data com retina_masks=True (píxeis para lá da linha da viga) |
| Métrica de aprovação | mAP50-95 de máscaras num conjunto de câmaras excluído do treino |
| Segunda etapa | Nenhuma — a linha da viga é fixa para cada câmera, então é uma configuração, não um modelo |
A regra de saliência pode ser implementada em três linhas de código: desenha a linha da viga uma vez para cada câmera, conta os pixels da máscara no lado errado da linha e emite um alerta quando o total ultrapassa um limite de pixels que calibras com algumas saliências conhecidas. A Lição 3 mostra exatamente esse tipo de teste entre máscara e região.