Avalia e coloca em produção todas as tarefas
Define um critério para cada tarefa com a respetiva métrica na resolução de implantação, valida todas as tarefas num único ciclo e exporta cada uma para ONNX com uma predição verificada.
Cada tarefa tem a sua própria definição de acerto: sobreposição de pixels, semelhança de pontos-chave, IoU de caixas rotacionadas, acerto top-1 ou uma razão de profundidade. As equipas que reutilizam a lista de verificação da deteção acabam por colocar em produção modelos de segmentação avaliados por mAP de caixas e modelos de pose avaliados por caixas que nunca foram o produto. E um modelo que passa no critério ainda pode falhar após a exportação: nesta lição, os mesmos pesos de pose detetam 5 pessoas numa resolução de entrada e 3 noutra, e as distâncias do modelo de profundidade quase duplicam.
Prático
Um critério por tarefa#
| Tarefa | Avaliar com | chave results_dict | Atributo Python | Avaliado por |
|---|---|---|---|---|
| segmentação | mAP50-95 de máscaras | metrics/mAP50-95(M) | metrics.seg.map | IoU de pixels por instância |
| semântica | mIoU (+ IoU por classe) | metrics/mIoU | metrics.miou | IoU de pixels por classe |
| pose | pose mAP50-95 | metrics/mAP50-95(P) | metrics.pose.map | OKS |
| obb | mAP50-95 de OBB | metrics/mAP50-95(B) | metrics.box.map | IoU de caixas rotacionadas |
| classificação | precisão top-1 | metrics/accuracy_top1 | metrics.top1 | classe top correta |
| profundidade | δ1 (+ AbsRel) | metrics/delta1 | metrics.delta1 | proporção de pixels cuja profundidade está dentro de 1,25× da profundidade real |
O guia de métricas de desempenho explica cada valor. As execuções de segmentação e pose também apresentam métricas de caixas; mantém-nas como diagnóstico — uma diferença entre caixas e máscaras aponta para a qualidade dos contornos —, mas elas não são o produto. A análise específica da deteção, como a avaliação de vários limiares e a matriz de confusão, também se aplica a Validar e diagnosticar.
Valida todas as tarefas num único ciclo#
O modo Val aceita os pesos de qualquer tarefa com o conjunto de dados correspondente, por isso um único ciclo produz os valores da tabela de lançamento:
from ultralytics import YOLO

runs = {
    "yolo26n-seg.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)"),
    "yolo26n-sem.pt": ("cityscapes8.yaml", "metrics/mIoU"),
    "yolo26n-pose.pt": ("coco8-pose.yaml", "metrics/mAP50-95(P)"),
    "yolo26n-obb.pt": ("dota8.yaml", "metrics/mAP50-95(B)"),
    "yolo26n-depth.pt": ("depth8.yaml", "metrics/delta1"),
}
for weights, (data, key) in runs.items():
    metrics = YOLO(weights).val(data=data, device="cpu", plots=False, verbose=False)
    print(f"{weights:17s} {key:22s} {metrics.results_dict[key]:.3f}")
yolo26n-seg.pt metrics/mAP50-95(M) 0.538
yolo26n-sem.pt metrics/mIoU 0.610
yolo26n-pose.pt metrics/mAP50-95(P) 0.419
yolo26n-obb.pt metrics/mAP50-95(B) 0.857
yolo26n-depth.pt metrics/delta1 0.377Sem um imgsz explícito, cada modelo é validado na resolução em que foi treinado: 640 para segmentação e pose, 768 para profundidade, 1024 para segmentação semântica e OBB. Estes valores pré-treinados são superiores aos das execuções de treino a 320 pixels realizadas anteriormente no curso — em parte devido ao treino e em parte à resolução. Com quatro imagens de validação, todos os valores aqui servem apenas como teste rápido; por exemplo, a página da tarefa de profundidade apresenta δ1 no conjunto de referência completo NYU. A classificação fica intencionalmente de fora: valida o classificador ajustado com os teus próprios pesos usando as respetivas pastas, como na lição sobre classificação.
Os mesmos pesos obtêm pontuações diferentes em diferentes imgsz. Registre imgsz junto de cada número, valide no tamanho em que fará a implantação e nunca compare números medidos em tamanhos diferentes.
Exporta todas as tarefas#
Cada tarefa é exportada para ONNX com a mesma chamada do modo Export. A tarefa fica guardada nos metadados do modelo, por isso YOLO("model.onnx") aplica o pós-processamento correto. As opções de ambiente de execução, as verificações de paridade e a otimização de TensorRT ou OpenVINO pertencem a Exportar para ONNX (e verificar a paridade); este ciclo verifica se todas as tarefas resistem à conversão de ida e volta:
from ultralytics import YOLO

for weights in ["yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]:
    onnx_path = YOLO(weights).export(format="onnx", imgsz=320)
    onnx_model = YOLO(onnx_path)  # task comes from the ONNX metadata
    result = onnx_model("https://ultralytics.com/images/bus.jpg", imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:9s} {result.verbose()}")
segment 4 persons, 1 bus,
semantic
pose 3 persons,
obb (no detections),
classify minibus 0.38, police_van 0.21, trolleybus 0.05, amphibian 0.05, bullet_train 0.03,
depth depth 4.67-26.91m,Todas as exportações foram recarregadas com a tarefa correta. Três resultados merecem uma segunda análise:
- A pose detetou 3 pessoas a 320 pixels, enquanto a execução de PyTorch a 640 pixels detetou 5.
- A profundidade estimou a cena entre 4.7–26.9 m, enquanto os mesmos pesos à resolução nativa de 768 pixels estimaram entre 2.1–14.9 m.
- OBB não detetou nada numa fotografia de rua — o comportamento correto para um modelo aéreo, não um erro de exportação.
PyTorch em imgsz=320 apresenta os mesmos valores de pose e profundidade que ONNX, portanto nenhum dos dois tem um erro de exportação: a resolução de entrada alterou o resultado. Exporta na resolução imgsz que validaste. Os resultados semânticos não têm uma linha de resumo por objeto, por isso verifica result.semantic_mask.
Faça uma previsão com cada modelo exportado usando uma imagem semelhante àquelas com que foi treinado — cenas de rua para modelos COCO, recortes aéreos para OBB, cenas internas ou de rua na escala correta para profundidade — antes de considerar uma exportação defeituosa ou enviá-la.
Se implementares o teu próprio pós-processamento, estas são as saídas ONNX em bruto em imgsz=320, retiradas do registo de exportação:
| Tarefa | Forma(s) das saídas ONNX | Conteúdo |
|---|---|---|
| segmentação | (1, 116, 2100) e (1, 32, 80, 80) | caixas + 80 pontuações de classe + 32 coeficientes de máscara; protótipos de máscara |
| semântica | (1, 320, 320) | mapa de classes, argmax já calculado no grafo |
| pose | (1, 56, 2100) | caixas + 1 pontuação + 17 × 3 valores de pontos-chave |
| obb | (1, 20, 2100) | caixas + 15 pontuações de classe + 1 ângulo |
| classificação | (1, 1000) | probabilidades de classe |
| profundidade | (1, 1, 320, 320) | profundidade em metros por pixel |
Na Ultralytics Platform, a página do modelo apresenta as métricas específicas da tarefa (mask mAP para um modelo de segmentação) acima de um separador Export que gera os mesmos formatos:

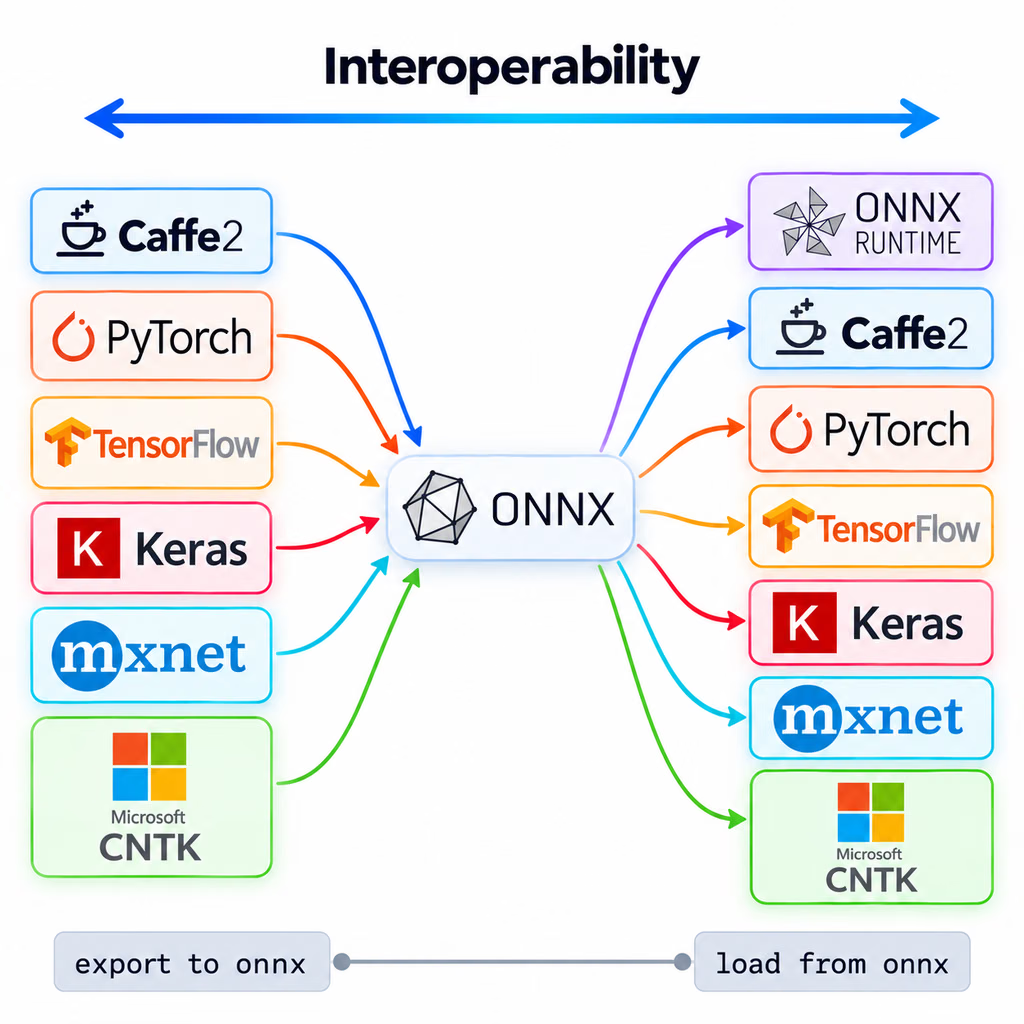
ONNX é o formato de intercâmbio: um único ficheiro exportado é executado no ONNX Runtime ou convertido para outros ambientes de execução.
Lista de verificação para lançamento#
- A métrica de avaliação da tabela acima atinge o objetivo num conjunto de dados reservado, na resolução de implantação
imgsz. - O modelo exportado é recarregado com o
taskesperado e corresponde às predições de PyTorch num conjunto fixo de imagens. - Os caminhos de código por tarefa lidam com resultados vazios:
masks is None, zero pontos-chave, zero OBBs. - Os valores calculados a jusante (áreas, ângulos, distâncias, probabilidades de classe) são registados para que possas acompanhar a sua variação, conforme descrito em Observabilidade e desvio.
Quando o critério não é atingido, «voltar aos dados» costuma significar recorrer a uma de três medidas:
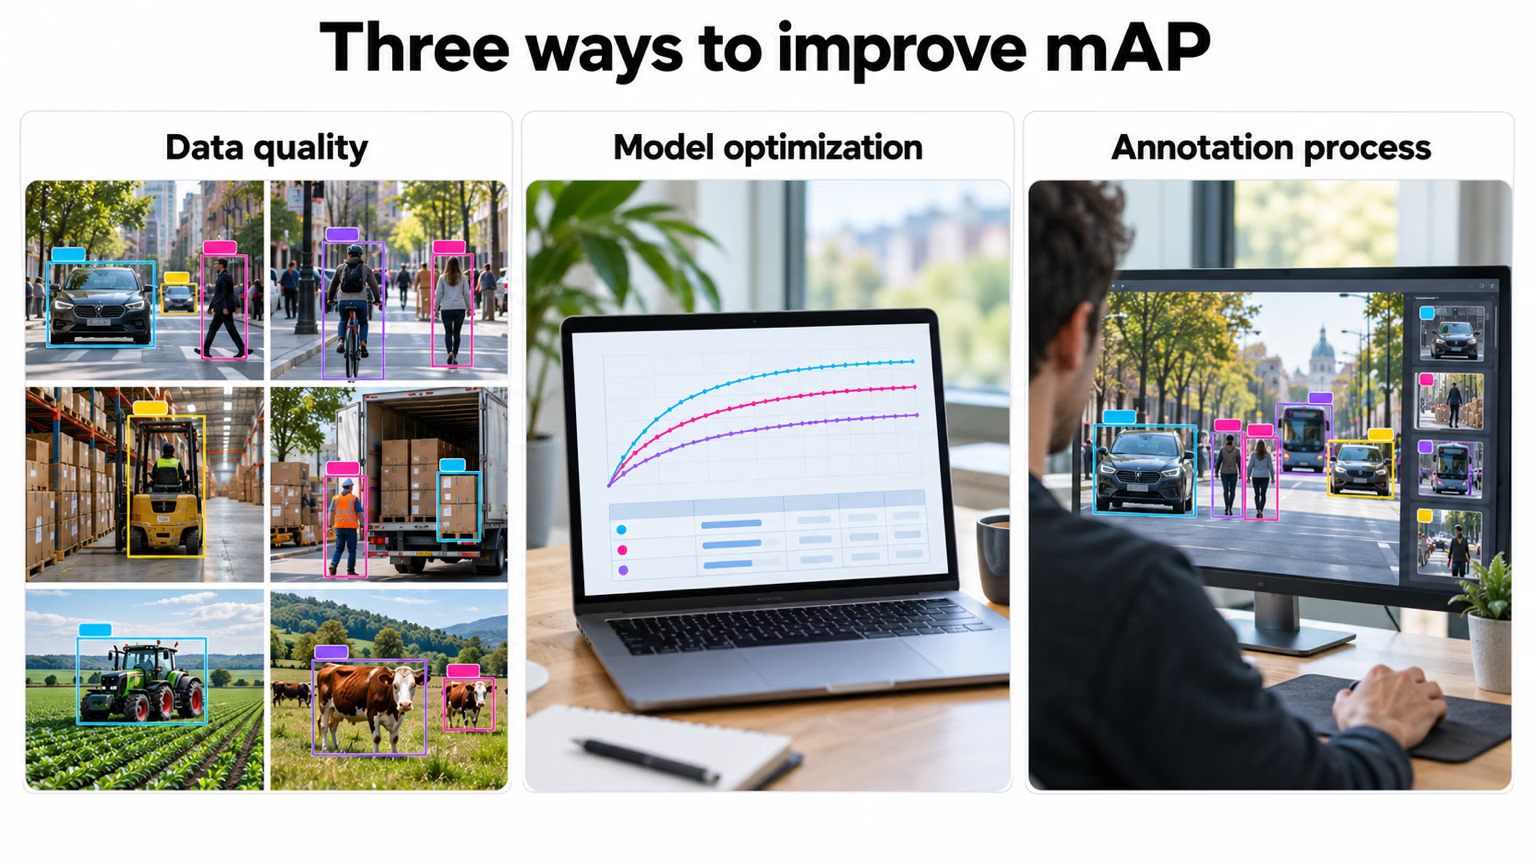
Corrige primeiro a qualidade dos dados e o processo de anotação — as verificações de rótulos das lições 2 e 6 são o ponto de partida mais económico — e só altera o modelo quando os dados estiverem limpos.
Mostrar solução
from ultralytics import YOLO

checks = {
    "runs/segment/train/weights/best.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)", "https://ultralytics.com/images/bus.jpg"),
    "runs/obb/train/weights/best.pt": ("dota8.yaml", "metrics/mAP50-95(B)", "https://ultralytics.com/images/boats.jpg"),
}
for weights, (data, key, image) in checks.items():
    model = YOLO(weights)
    gate = model.val(data=data, imgsz=320, plots=False, verbose=False).results_dict[key]
    onnx_model = YOLO(model.export(format="onnx", imgsz=320))
    result = onnx_model(image, imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:8s} {key} @320 = {gate:.3f} | ONNX: {result.verbose()}")
Ajusta os caminhos runs/... às pastas indicadas pelas tuas execuções de treino (Results saved to ...). Com as execuções de uma época das lições 2 e 7:
segment  metrics/mAP50-95(M) @320 = 0.377 | ONNX: 4 persons, 1 bus,
obb metrics/mAP50-95(B) @320 = 0.832 | ONNX: 185 ships, 3 harbors,| Modelo | Métrica de aprovação | Valor | imgsz | ONNX |
|---|---|---|---|---|
| segmentação | mAP50-95 de máscaras | 0.377 | 320 | recarrega como segment, deteta o autocarro e 4 pessoas |
| obb | mAP50-95 de OBB | 0.832 | 320 | recarrega como obb, deteta 185 navios e 3 portos |
Cada verificação usa uma imagem do respetivo domínio: o modelo OBB recebe a fotografia aérea do porto, não a cena de rua. Ambas as linhas passam na verificação da exportação; nenhum dos modelos está pronto para produção, porque uma época com quatro imagens de validação é um teste rápido, não um critério de aceitação.