Treinar um classificador de imagens
Organize um conjunto de dados em pastas, treine yolo26n-cls.pt em MNIST160, leia probs e a acurácia top-1 e encaminhe para revisão humana as previsões com baixa confiança.
A classificação de imagens responde a uma pergunta por imagem: o que é isto? Ela exige os rótulos mais simples entre todas as tarefas — o nome de uma pasta — e é a mais rápida, o que a torna a segunda etapa padrão após um detector e o primeiro modelo ideal para uma estação de inspeção que vê uma peça por quadro. O conjunto de dados não tem YAML, então a estrutura de pastas é o contrato, e um classificador sempre fornece uma resposta, mesmo para imagens que não se parecem com nada que já tenha visto. Decidir quando não confiar nele é metade do trabalho.
Prático
A estrutura de pastas do conjunto de dados#
Os conjuntos de dados de classificação são diretórios, não arquivos YAML. Aponte data= para a pasta raiz:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
O que o carregador faz com ela, de acordo com o código-fonte instalado e o guia de conjuntos de dados de classificação:
| Situação | Comportamento |
|---|---|
| Índices das classes | nomes de pastas em train/, em ordem alfabética → dent=0, good=1, scratch=2 |
| Pasta de validação | val/, depois validation/, depois valid/; usa test/ como alternativa, com um aviso |
Sem a pasta train/, apenas pastas de classes | divide automaticamente em 80/20 entre train/ e val/ |
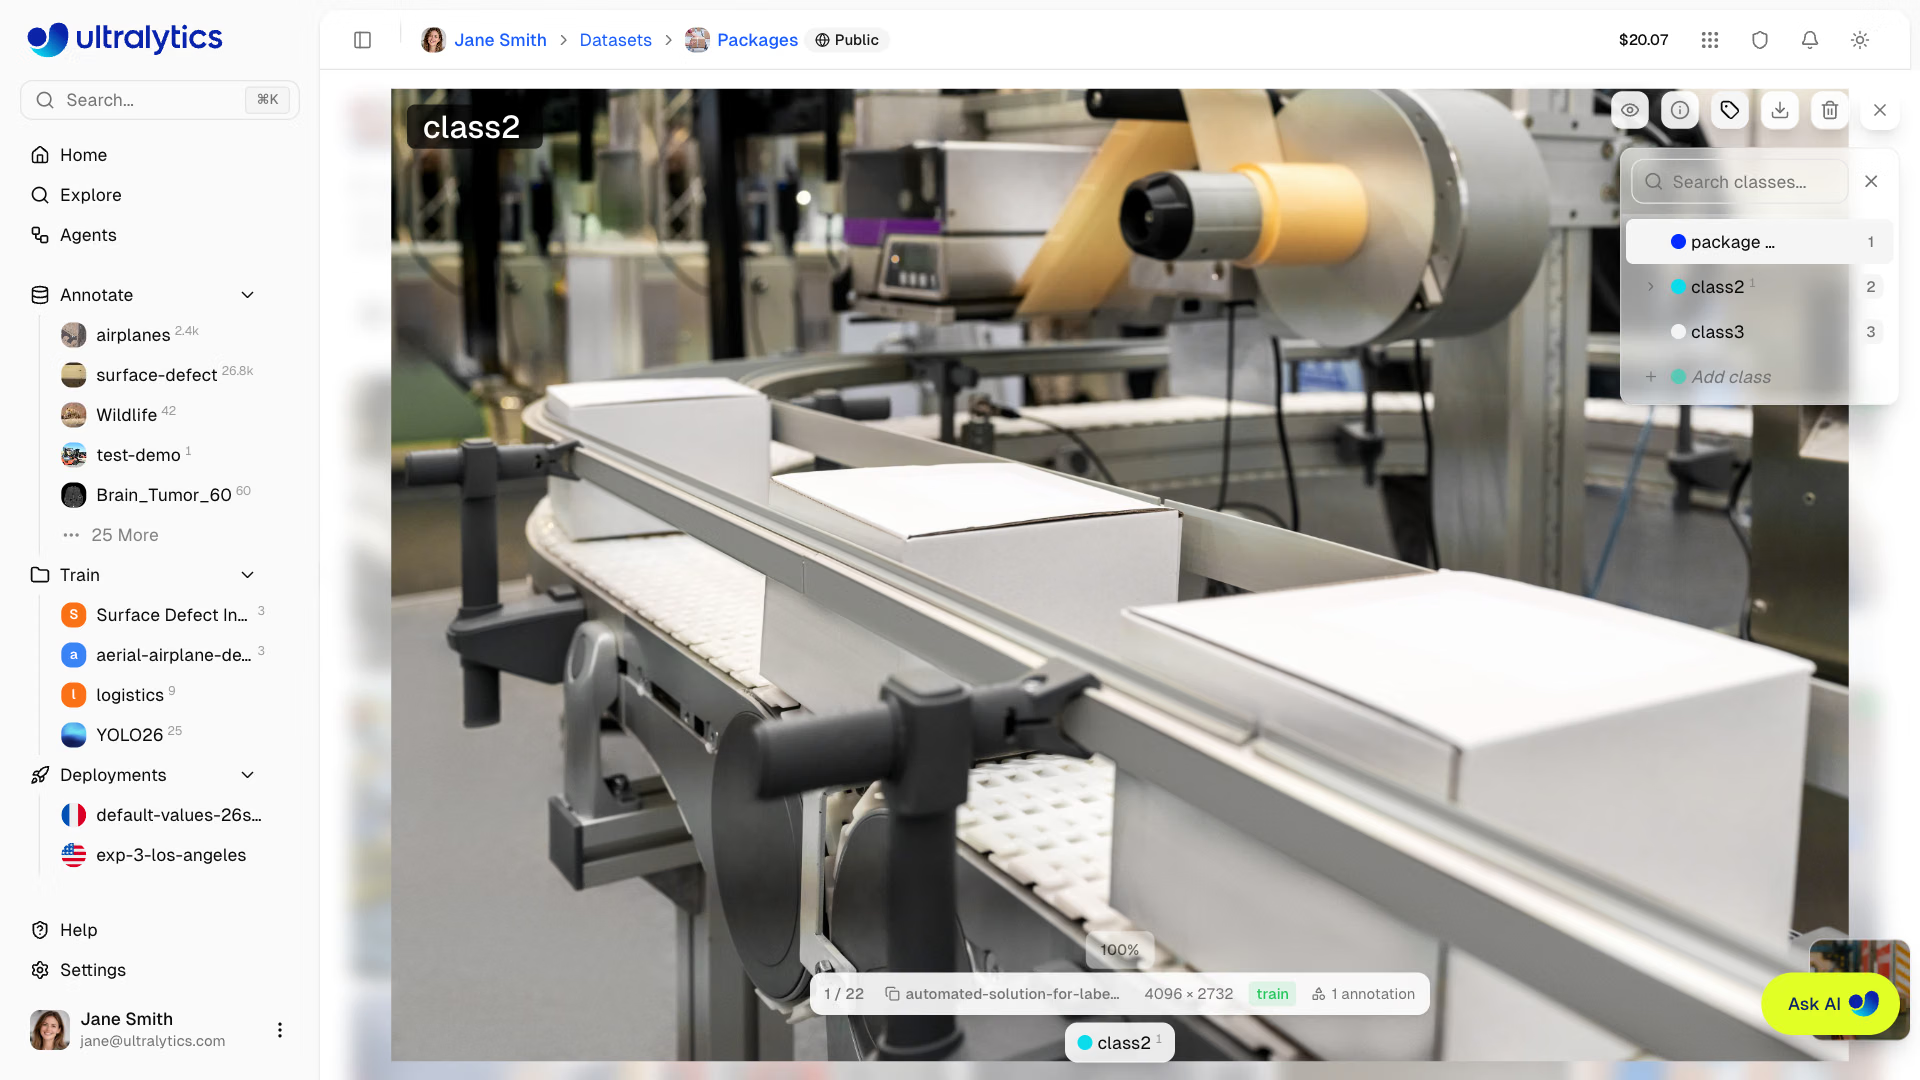
Na Ultralytics Platform, um conjunto de dados de classificação contém um rótulo por imagem, em vez de formas:
Sintoma: após adicionar uma classe, uma integração antiga relata partes good como dent. Causa: adicionar uma pasta chamada bent faz com que ela seja ordenada primeiro e desloque todos os índices seguintes. Solução: sempre mapeie índices para nomes com model.names (ou result.names); nunca fixe um índice no código.
Treinar com MNIST160#
MNIST160 contém 160 dígitos manuscritos, 80 em train/ e 80 em test/, cada conjunto dividido em dez pastas de dígitos — pequeno o bastante para um teste rápido na CPU. Não há uma pasta val/, então observe o aviso do carregador e a utilização de test/ como alternativa:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Uma época mal altera a nova cabeça de dez classes. Na nossa execução, epochs=10 alcançou top-1 de 0.55 e top-5 de 0.95 em cerca de dez segundos na CPU de um laptop — o ciclo funciona; só precisa de um cronograma de treinamento. O guia da tarefa Classify lista os tamanhos pré-treinados.
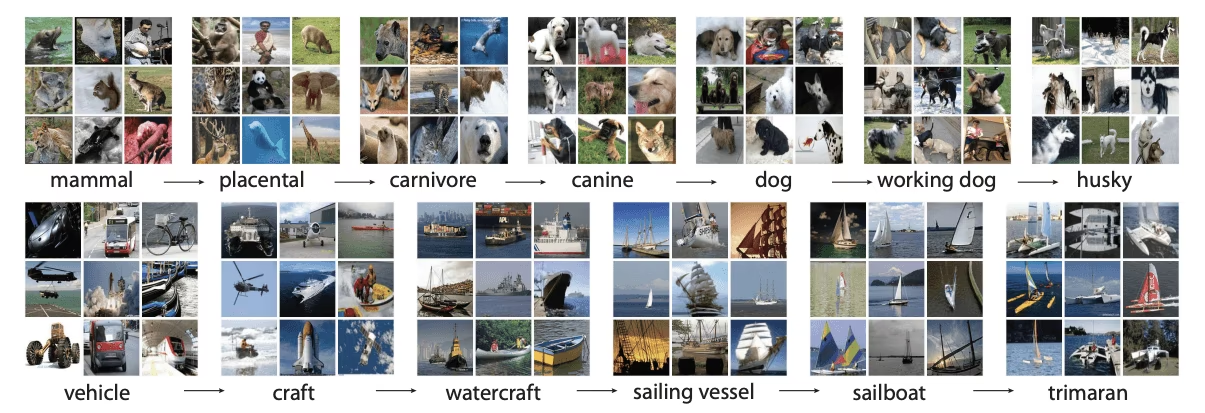
Top-1 é a proporção de imagens cuja classe com maior probabilidade está correta. Top-5 conta como acerto se a classe correta estiver entre as cinco mais prováveis. Top-5 é informativo para o ImageNet de 1.000 classes, cujas classes vão das mais abrangentes às muito específicas; com cinco classes ou menos, o valor é sempre 1.0, e com dez é generoso. Use a acurácia top-1 e uma matriz de confusão por classe como critérios.
Ler as probabilidades no código#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 é um índice, probs.top5 é uma lista de índices e probs.data é o vetor completo de probabilidades. Observe a confiança top-1: 0.52 é só um pouco mais do que jogar uma moeda para decidir entre minibus e police_van. É esse valor que você usa para encaminhar as previsões.
Encaminhar previsões incertas para uma pessoa#
Um classificador em produção raramente precisa acertar todas as imagens; precisa acertar as imagens que classifica sem ajuda. Este script treina o modelo por 10 épocas e, em seguida, mede o efeito de diferentes limites de confiança nas 80 imagens de dígitos reservadas para teste:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Cada linha representa uma troca: aumentar o limite torna as previsões aceitas mais precisas e encaminha mais imagens para uma pessoa. Com 0.6, este modelo decide sozinho apenas 10 dos 80 dígitos — ainda não está pronto para automatizar nada, e a solução é treinar mais, não escolher um limite mais engenhoso. Gere a mesma tabela novamente após cada rodada de treinamento: ela mostra tanto a acurácia que você terá quanto o volume exato de trabalho de revisão que cada limite gera.
Escolha o menor limiar cuja precisão nas imagens aceitas atenda ao seu requisito, medida em dados separados para teste. Em seguida, verifique se sua equipe consegue lidar com o volume de revisões gerado; caso contrário, melhore o modelo.
Armadilhas#
Sintoma: uma estação vazia, uma peça incorreta ou uma mão sobre a lente recebe um rótulo de classe com alta confiança. Causa: as probabilidades de softmax sempre somam 1, então o classificador sempre escolhe uma de suas classes. Solução: adicione uma pasta other/ contendo exatamente essas imagens e encaminhe para revisão as previsões com top1conf baixo.
Sintoma: um modelo pré-treinado obtém uma pontuação próxima de zero no seu conjunto de dados antes de qualquer treinamento. Causa: yolo26n-cls.pt prevê 1.000 índices ImageNet, e suas pastas reutilizam os índices 0–9 com significados diferentes: no MNIST160, a pasta 0 é o índice 0, que a cabeça pré-treinada identifica como tench. Medimos top-1 de 0.000 dessa forma. Solução: primeiro, ajuste fino e, em seguida, valide.
Sintoma: top-1 próximo de 1.0 na validação, mas muito menor em produção. Causa: fotos quase duplicadas da mesma peça em train/ e val/. Solução: divida por peça ou por sessão, como em Dividir o conjunto de dados corretamente.
Os classificadores são pré-treinados em imgsz=224, não em 640. Para objetos pequenos em um quadro grande, é melhor detectar e depois classificar (próxima lição) do que usar um imgsz maior.
Mostrar solução
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Nossas execuções: 1 época → top-1 0.162, top-5 0.463; 10 épocas → top-1 0.550, top-5 0.950. Com cinco classes, a resposta correta sempre está entre as cinco primeiras, então top-5 é 1.0 por definição e não informa nada.
Para atingir 75% de acurácia nas imagens aceitas, route.py indica 0.6 (80% nas 10 imagens aceitas), o que encaminha 70 dos 80 dígitos para revisão. Essa é a resposta honesta: o limite atende ao requisito de acurácia, mas o modelo ainda não é útil. Treine por mais tempo e gere novamente a tabela antes de escolher um limite para uso real.