Segmentação semântica: rotular cada pixel
Prevê um mapa de classes por pixel com yolo26n-sem.pt, converte-o em valores de cobertura, cria conjuntos de dados de mapas de classes PNG e interpreta mIoU sem te deixares enganar pela precisão por pixel.
Algumas perguntas não envolvem objetos para contar: que parte da calçada está bloqueada, que parte de um campo tem ervas daninhas, onde termina a via transitável. A segmentação semântica responde com um ID de classe por pixel. No entanto, a sua métrica principal é fácil de interpretar mal: o modelo que treinas nesta lição atinge 91% de precisão por pixel sem detetar uma única pessoa.
Prático
Instância ou semântica?#
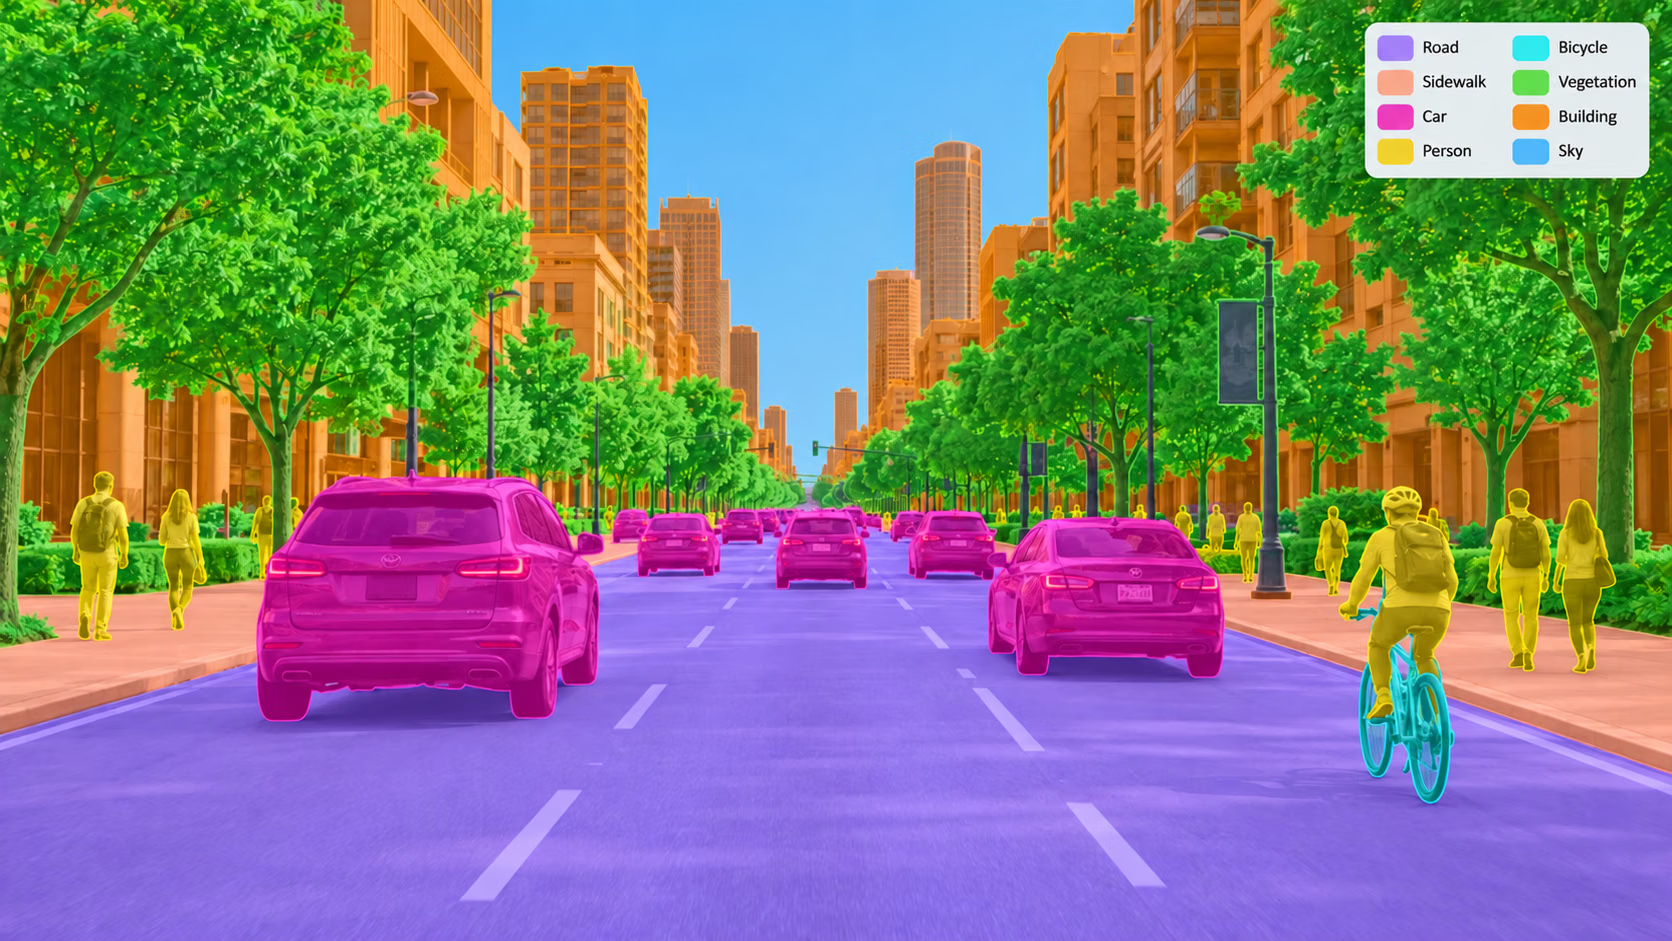
Segmentação de instâncias (segment) | Segmentação semântica (semantic) | |
|---|---|---|
| Saída | uma máscara por objeto, mais uma caixa | um ID de classe por pixel |
| Conta objetos | sim | não — dois carros encostados formam uma única região de «carro» |
| Lida com «coisas» (estrada, céu, relva) | mal — não há instâncias naturais | sim |
| Rótulos | polígonos | mapas de classes PNG ou polígonos |
| Métrica de aprovação | mAP50-95 de máscaras | mIoU |
| Pesos pré-treinados | yolo26n-seg.pt (COCO, 80 classes) | yolo26n-sem.pt (Cityscapes, 19 classes) |
Se a pergunta a jusante incluir "quantos", usa segmentação de instâncias. Se for "quanto" ou "onde", a segmentação semântica é mais simples de etiquetar e interpretar. A página da tarefa de segmentação semântica inclui a tabela de modelos.
Faz uma previsão de mapa de classes#
result.semantic_mask.data é um tensor H × W no tamanho original da imagem; cada valor é um ID de classe e 255 significa ignorar. result.summary() converte-o em proporções de pixels por classe:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Observa a última linha. Cityscapes tem uma classe bus, mas o modelo classifica o ônibus como train. O modelo aprendeu com imagens gravadas a partir de carros, sobretudo em ruas alemãs, e um ônibus fotografado de perto a partir da calçada está fora dessa distribuição. Os modelos semânticos herdam o ponto de vista e as definições de classe do conjunto de treino — o seu viés de conjunto de dados — de forma mais rígida do que os detetores; por isso, ajusta o modelo com imagens da tua câmera antes de confiar no mapa.
Converte o mapa de classes numa resposta#
Um mapa de classes transforma-se num valor de produto com simples comparações de tensores. Eis «que parte da área em que um pedestre caminharia corresponde à estrada ou à calçada, e que parte corresponde a pessoas»:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personTrês hábitos tornam estes valores fiáveis:
- Consulta os IDs pelo nome em
result.names, nunca por um número fixo; um modelo treinado com as tuas próprias classes atribui-lhes números diferentes. - Limita a análise à região relevante. As proporções do quadro inteiro incluem céu e edifícios; primeiro, recorta o mapa de classes (ou multiplica-o por uma máscara de região).
- Abre a sobreposição.
semantic_overlay.jpgmostra num relance se a «estrada» contabilizada pelo valor é realmente estrada.
O formato do conjunto de dados#
Os conjuntos de dados semânticos associam cada imagem a uma imagem de máscara de canal único, cujos valores de pixel são IDs de classe. O guia de conjuntos de dados semânticos é a referência; a estrutura espelha images/ ficheiro a ficheiro:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
O YAML acrescenta masks_dir e, quando os IDs armazenados nas tuas máscaras diferem dos IDs de treino, um bloco label_mapping:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
As máscaras Cityscapes armazenam IDs de rótulo brutos de -1 a 33; o mapeamento mantém 19 deles e atribui os restantes a ignore_label, armazenado como 255. Os pixels definidos como 255 são excluídos tanto da função de perda como das métricas — usa o mesmo valor para as regiões sobre as quais os teus anotadores não conseguiram chegar a uma decisão.
Se já tens rótulos de polígonos e não tens masks_dir, o carregador rasteriza os polígonos por ti e atribui a classe background aos pixels não cobertos.
A compressão com perdas mistura valores de píxeis vizinhos, transformando a fronteira entre a classe 7 e a classe 8 numa mistura de valores 7, 8 e IDs inexistentes. Guarda todas as máscaras como PNG ou TIFF.
Treina e interpreta mIoU#
O Cityscapes8 tem 8 imagens de cenas urbanas: 4 para treino e 4 para validação, o suficiente para um teste rápido no CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Linhas por classe omitidas.) A precisão por pixel indica 91%; mIoU indica 42%; as linhas por classe mostram que o modelo não detetou uma única pessoa. As três afirmações são verdadeiras. A estrada, os edifícios e a vegetação ocupam a maioria dos pixels — só a estrada ocupa 78,529 de 192,315 —, por isso um modelo que os classifique bem alcança uma precisão por pixel elevada, mesmo sem detetar nenhuma das classes pequenas. mIoU calcula a média da IoU por classe com pesos iguais, por isso cada classe não detetada reduz o valor.

Define limiares tanto para mIoU como para o IoU das classes em que o teu produto atua. Uma funcionalidade de segurança para peões com IoU de pessoa igual a 0 falha, independentemente do que indicar a precisão por píxel.
Mostrar solução
Na nossa execução: mIoU 0.415, precisão por pixel 0.906 e IoU igual a 0 para parede, pessoa, ciclista, motocicleta e bicicleta, além de todas as classes sem pixels nas quatro imagens de validação.
A precisão por pixel é superior porque conta pixels, e a estrada, os edifícios, a vegetação e o céu compõem a maior parte de cada imagem Cityscapes. mIoU atribui o mesmo peso a cada classe, por isso cinco classes pequenas não detetadas reduzem a média, apesar de ocuparem apenas algumas centenas de pixels. Para um produto que age sobre pessoas, este modelo falha o critério de aprovação apenas pela IoU da classe pessoa.