Rotular e treinar a segmentação de instâncias
Escreve rótulos poligonais, verifica-os em código, treina yolo26n-seg.pt em COCO8-seg e diagnostica um modelo com base na diferença entre as métricas de caixas e máscaras.
A segmentação de instâncias dá a cada objeto o seu próprio contorno, algo de que precisas quando a área, a sobreposição ou um limite determina a decisão. Os polígonos são os rótulos mais dispendiosos que a maioria das equipas compra, e uma linha malformada não interrompe o treino — treina silenciosamente com a forma errada. Nesta lição, vais acertar o formato da linha, verificar um conjunto de rótulos em código e treinar um primeiro modelo para veres o que a rotulagem extra proporciona: uma segunda métrica que avalia contornos, não apenas posições.
Prático
A linha de rótulo do polígono#
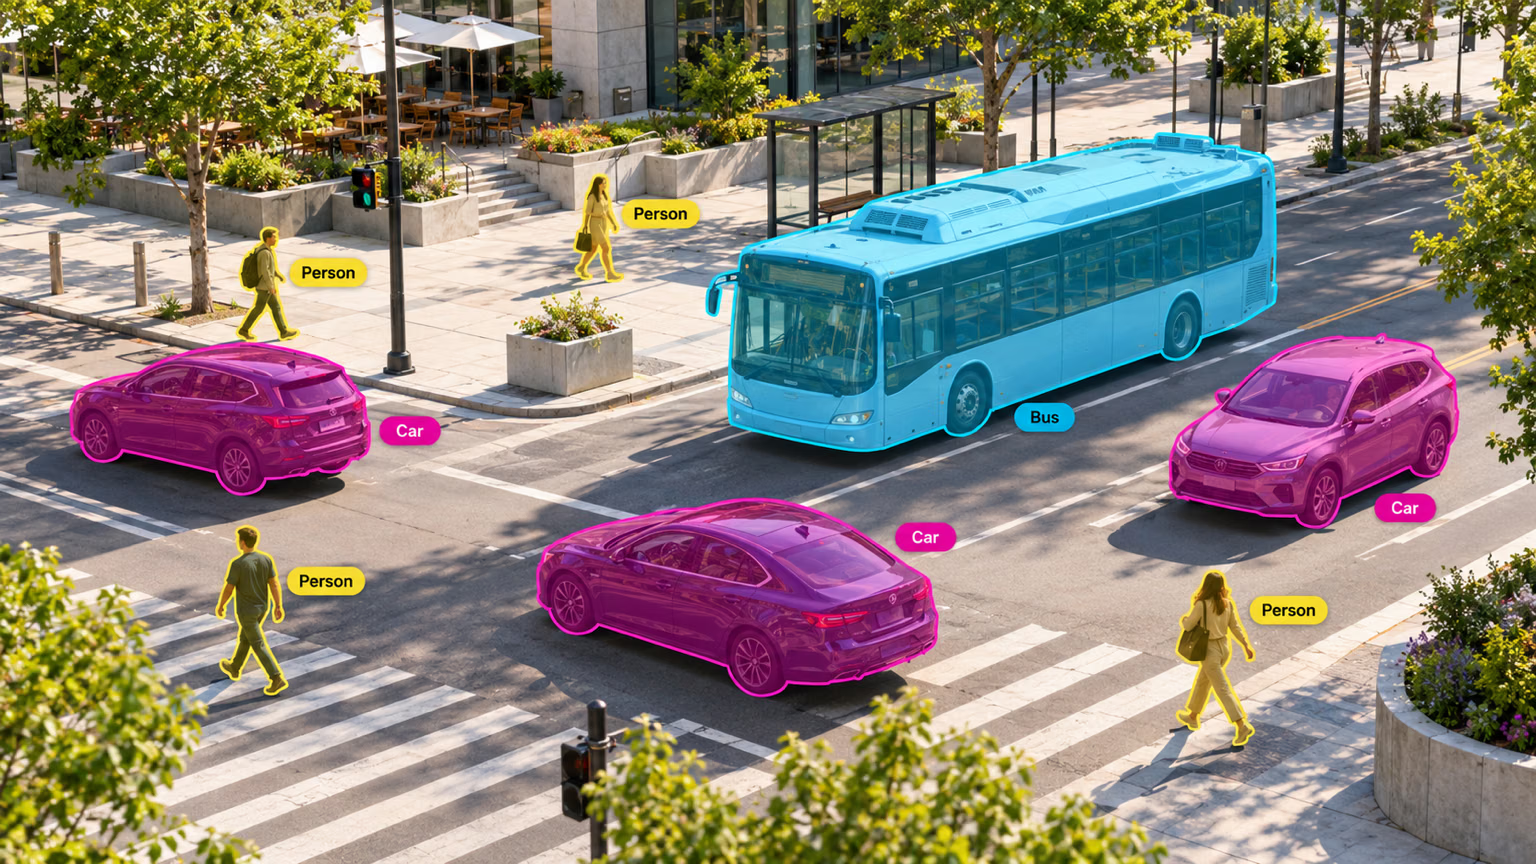
Um ficheiro de rótulos de segmentação tem uma linha por objeto, tal como um rótulo de deteção, mas, em vez de uma caixa, lista o contorno do objeto como pares de vértices normalizados. Uma linha real de COCO8-seg, abreviada:
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| Posição | Linha de deteção | Linha de segmentação |
|---|---|---|
| 1 | índice da classe (45 é bowl) | índice da classe |
| 2–5 | x_center y_center width height | os dois primeiros vértices, x1 y1 x2 y2 |
| 6+ | — | mais vértices, tantos quantos forem necessários para o contorno |
| Unidades | normalizado de 0 a 1 | normalizado de 0 a 1 (x do píxel ÷ largura da imagem, y do píxel ÷ altura da imagem) |
Três regras são fundamentais: pelo menos três vértices por objeto, coordenadas divididas pelo tamanho da imagem e uma linha por instância, mesmo quando dois objetos da mesma classe se tocam. O guia de conjuntos de dados de segmentação contém a especificação completa.
Os polígonos são um superconjunto de etiquetas de caixas. A mesma pasta de etiquetas treina yolo26n.pt (o Ultralytics calcula cada caixa a partir do respetivo polígono) e yolo26n-sem.pt (rasteriza os polígonos em mapas de classes) — treinámos ambos com coco8-seg.yaml. Se o plano mudar depois da etiquetagem, o orçamento não se perde.
Verifica os rótulos antes de treinar#
Uma linha com um número ímpar de valores, uma coordenada escrita em píxeis ou um contorno traçado em torno do objeto errado não interrompe o treino. Este verificador lê o conjunto de dados com o próprio carregador da Ultralytics, rejeita linhas malformadas e apresenta a área de cada polígono junto à caixa que a Ultralytics vai derivar dele:
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38As áreas são frações da imagem, por isso a primeira taça ocupa 39% da fotografia. Preenchimento é a área do polígono dividida pela área da caixa, e é essa a coluna que deves analisar:
- A maioria dos objetos compactos (taças, laranjas, brócolos) fica entre 0,6 e 0,7.
- O valor 0,31 da girafa é genuíno: as pernas e o pescoço compridos deixam vazia a maior parte da caixa — é por isso que este objeto precisa de uma máscara.
- O valor 0,15 da terceira taça é a linha que um revisor deve abrir. Só se vê uma borda fina da taça à volta da comida, por isso o contorno é uma faixa estreita dentro de uma caixa grande. Neste caso, está correto; nos teus dados, um preenchimento tão baixo pode muito bem indicar que o contorno foi traçado em torno do objeto errado.
Corrige todas as linhas BAD antes do treino. Depois, ordena por preenchimento e abre numa ferramenta de anotação as linhas com os valores mais baixos, correspondentes a alguns por cento de cada classe: um preenchimento baixo indica um objeto fino ou ocluído (mantém) ou um contorno incorreto (corrige).
Obtém polígonos sem traçar cada contorno#
Traçar contornos à mão é a parte dispendiosa da rotulagem de dados. Verifica que atalho se aplica antes de alguém começar:
| Já tens | Ferramenta |
|---|---|
| JSON COCO com segmentação | convert_coco(labels_dir, use_segments=True) de ultralytics.data.converter |
| Máscaras PNG (valor do píxel = índice da classe + 1, 0 = fundo) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes) — objetos da mesma classe que se tocam são convertidos num único polígono, por isso separa-os durante a revisão |
| Apenas rótulos de caixas | yolo_bbox2segment(im_dir) — fornece cada caixa como indicação ao SAM para gerar um polígono |
| Ainda nada | Anotação inteligente e rotulagem em lote — clica uma vez e revê o polígono |
Na Ultralytics Platform, o modo Smart executa o SAM: um clique positivo no objeto e um clique negativo no que deve ser excluído geram uma máscara que depois revês.
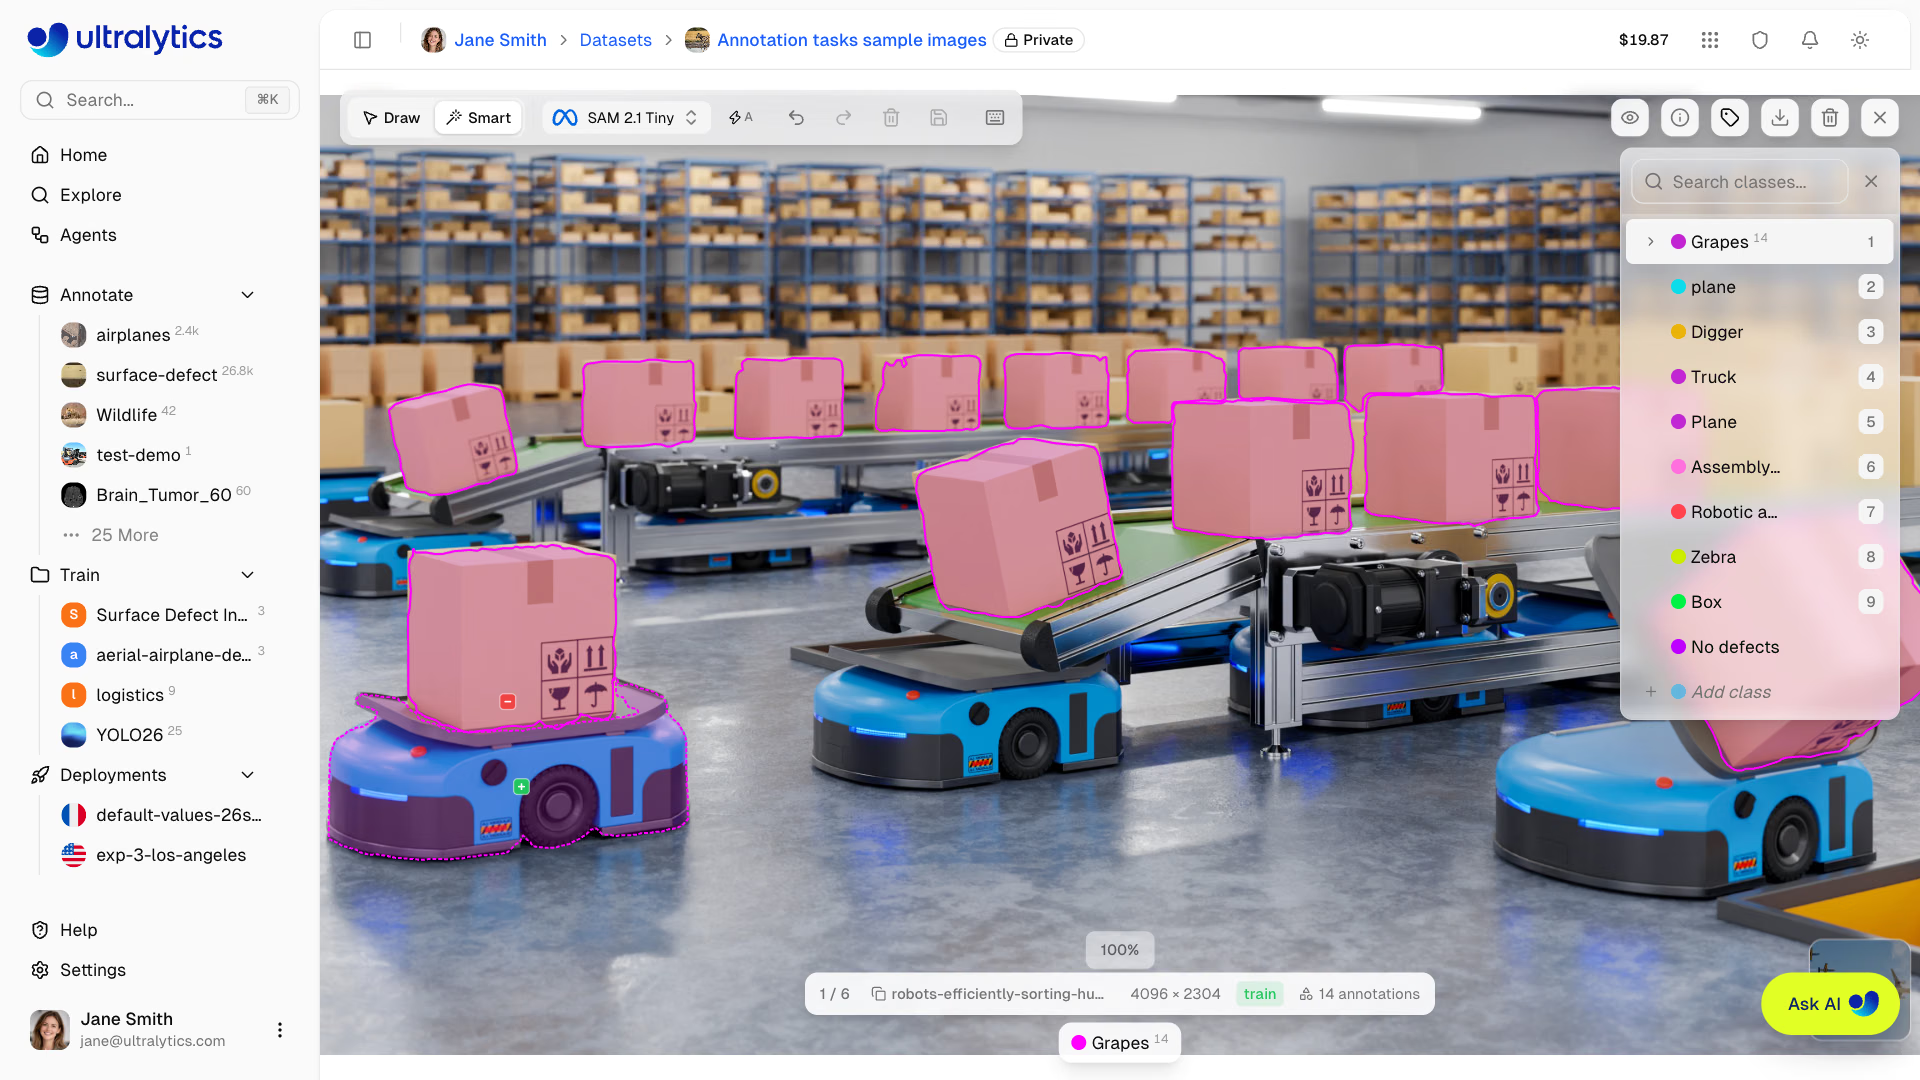
Uma máscara que se estende ao fundo treina o modelo a fazer o mesmo. Revê os polígonos gerados por máquina de acordo com os critérios de qualidade em Caixas vs. Máscaras e, depois, volta a executar a verificação de etiquetas acima.
Treina com COCO8-seg#
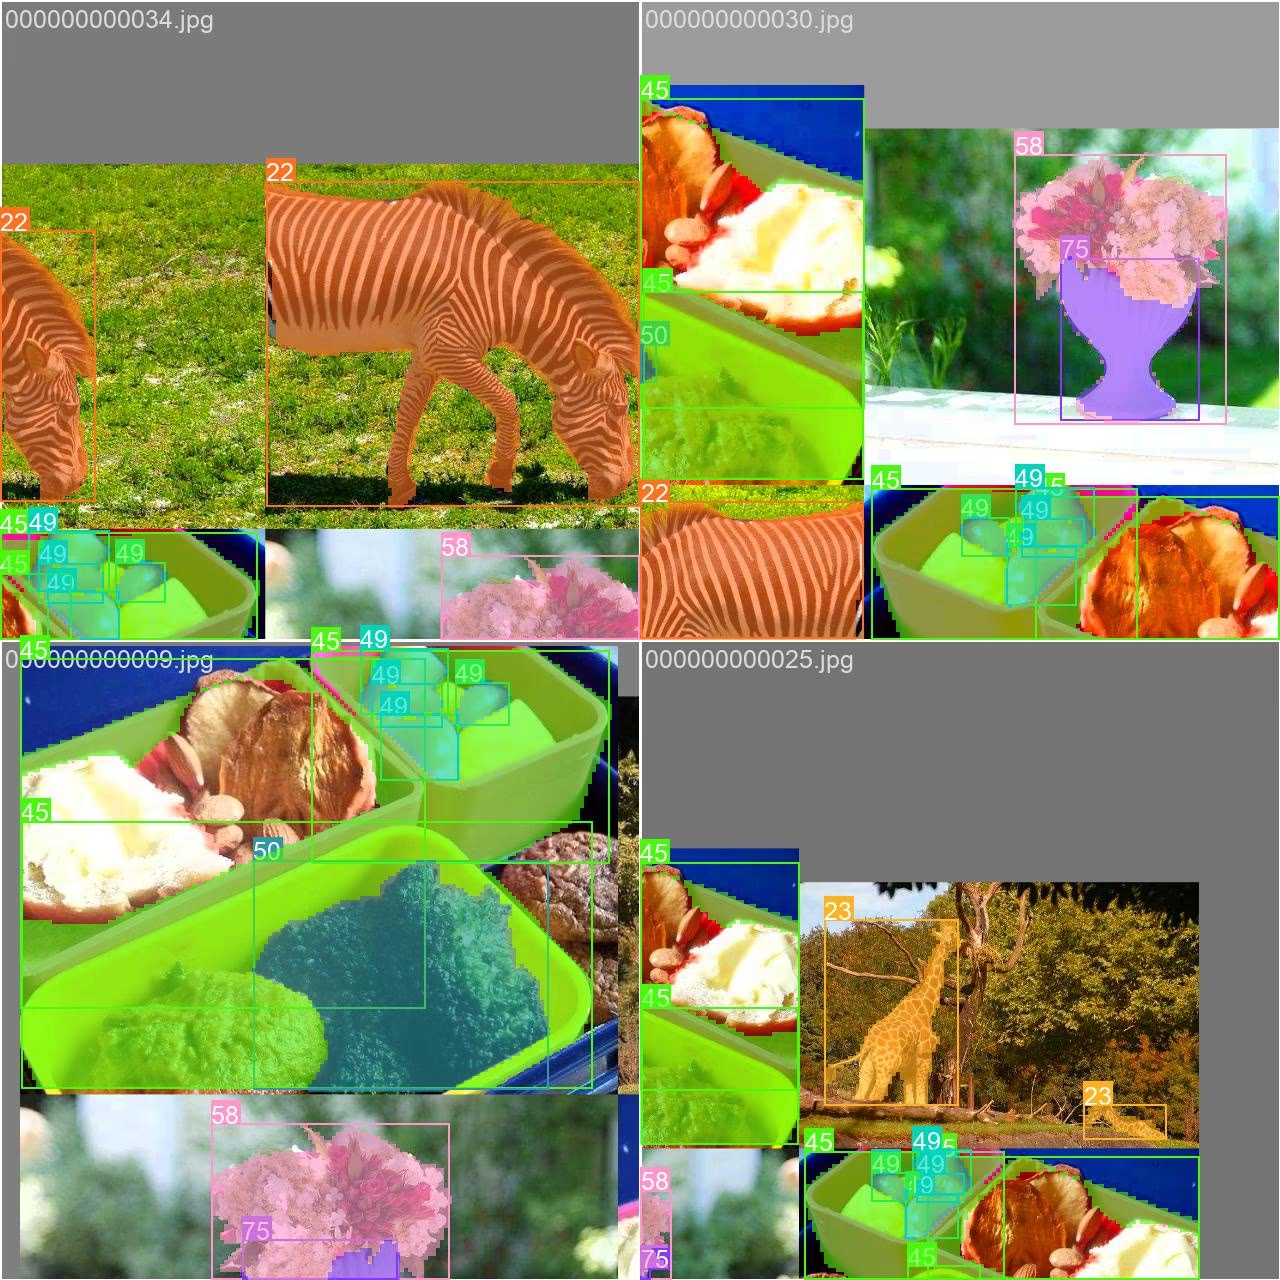
O treino segue o fluxo de trabalho de deteção, mas com um modelo -seg e um conjunto de dados de segmentação. Uma época em imgsz=320 num CPU de portátil demora segundos, o suficiente para comprovar todo o fluxo:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377Quatro imagens de validação tornam estes números pouco fiáveis; o importante é a execução terminar e gravar weights/best.pt em runs/segment/. Para dados reais, segue o guia da tarefa Segment e treina com o plano completo numa GPU.
Analisa as métricas de caixas e máscaras lado a lado#
A tabela de validação tem dois blocos. Box avalia cada caixa prevista em relação à caixa implícita no rótulo; Mask avalia os píxeis previstos em relação ao polígono rotulado. Ambos usam o mesmo mecanismo de mAP; só muda o IoU.
O mAP50-95 das máscaras é quase sempre inferior ao das caixas, porque o IoU dos píxeis é mais rigoroso: uma caixa deslocada alguns píxeis continua a sobrepor-se bastante, enquanto uma máscara que não inclui um braço ou que se estende para a estrada perde IoU rapidamente nos limiares de 0,75–0,95. A linha horse mostra o caso mais extremo — mAP50-95 das caixas de 0,564 e das máscaras de 0,199. O modelo encontrou os dois cavalos e delimitou-os bem com caixas; não contornou as pernas nem as caudas. Usa a diferença para decidir o que corrigir:
- Ambos baixos: o problema está em encontrar os objetos, não em contorná-los. Primeiro, acrescenta dados das condições que não foram detetadas.
- Caixas boas, máscaras muito piores: o modelo encontra os objetos, mas não os contorna bem. Executa a verificação dos rótulos, experimenta um modelo maior ou treina e valida com um valor
imgszmais elevado. - As máscaras melhoram enquanto as caixas estagnam: não há problema — para um produto de segmentação, o mAP50-95 das máscaras é o critério de lançamento.
overlap_mask=True combina máscaras de instâncias numa só imagem durante o treino, e mask_ratio=4 reduz a resolução das máscaras de treino. Nenhum dos dois altera a resolução das máscaras previstas — isso é controlado por retina_masks, na lição seguinte. Mantém ambos nos valores predefinidos, a menos que tenhas medido uma razão para os alterar.
Mostrar solução
Para verificar todas as divisões, substitui a pasta no ciclo por Path(data["path"], "labels").rglob("*.txt"). Depois, treina:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}")   # 0.377 in our run
A diferença de 0,1 é esperada: o IoU das máscaras penaliza cada píxel do contorno, enquanto o IoU das caixas penaliza apenas os quatro lados. Na nossa execução, a maior diferença é da classe horse (caixa 0,564, máscara 0,199). O mAP das caixas é bom e o das máscaras é muito inferior, por isso o gráfico aponta para a qualidade dos contornos: verifica primeiro esses polígonos e, depois, experimenta um modelo maior ou um valor imgsz mais elevado.