Tối ưu chi phí và độ trễ
Profile toàn bộ pipeline, lần lượt điều chỉnh những yếu tố thực sự cải thiện độ trễ và chi phí, rồi dừng khi đạt ngân sách.
Các nhóm mất nhiều tuần để giảm vài mili giây cho model trong khi nút thắt thực sự lại là thao tác ghi database hoặc bộ giải mã RTSP. Chỉ có một vài yếu tố then chốt và chúng được đo lường rõ ràng: YOLO26s mất nhiều thời gian hơn YOLO26n 2.2 lần trên CPU để tăng thêm 7.7 điểm mAP, còn chạy detection trên mỗi frame cách quãng một frame giúp giảm một nửa khối lượng công việc. Bài học này hướng dẫn bạn profile trước, điều chỉnh yếu tố có tác động lớn nhất và phù hợp, rồi dừng ở mức ngân sách đã đặt ra từ trước.
Thực hành
Trước tiên, đo toàn bộ pipeline#
Mỗi đối tượng Results chia thời gian xử lý thành các giai đoạn:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameỞ đây, inference chiếm 95% thời gian của model, vì vậy các biện pháp tối ưu model sẽ có tác dụng. Đo thời gian giải mã và các sink của riêng bạn theo cách tương tự (đặt time.perf_counter() xung quanh từng phần), sau đó áp dụng quy tắc tương ứng với kết quả đo:
| Kết quả đo | Ưu tiên khắc phục |
|---|---|
| Giải mã RTSP mất 60 ms, inference mất 5 ms | Giải mã bằng phần cứng, giảm độ phân giải luồng hoặc tăng số luồng decoder |
| Inference mất 30 ms, hậu xử lý Python mất 100 ms | Vector hóa bằng NumPy hoặc chuyển tác vụ sang một worker process |
| Inference mất 5 ms, ghi database mất 200 ms | Ghi theo batch hoặc xử lý bất đồng bộ |
| Inference là nút thắt chính | Bảng xếp hạng các biện pháp bên dưới |
Bảng xếp hạng các biện pháp tối ưu#
Thử lần lượt từ trên xuống và dừng khi đạt ngân sách:
| Điều chỉnh | Mức tăng tốc điển hình | Mức đánh đổi độ chính xác điển hình |
|---|---|---|
| Model nhỏ hơn (m → s, s → n) | 1.5–2.5× | Giảm 4.5–7.7 điểm mAP trên COCO; mức giảm ít hơn ở các tác vụ chuyên biệt |
imgsz nhỏ hơn (640 → 480) | khoảng 1.8× | Ảnh hưởng trước tiên đến vật thể nhỏ và ở xa |
| Runtime nhanh hơn, FP16 | khoảng 1.5× trên GPU | Thường không ảnh hưởng; hãy xác minh tính tương đương |
| INT8 có calibration | tăng thêm 1.2× trên GPU; lên đến 2.9× trên CPU | 1 điểm (YOLO26n) đến 4–6 điểm (model lớn hơn); QAT khôi phục phần lớn mức giảm |
Ít frame hơn (vid_stride=N) | lên đến N× | Có thể bỏ lỡ vật thể di chuyển nhanh và sự kiện ngắn |
| Batch lớn hơn (server) | Thông lượng cao hơn, không phải độ trễ thấp hơn | Không có |
Các con số được lấy từ các bảng benchmark YOLO26, TensorRT và OpenVINO, cùng các phép đo bên dưới; kết quả của bạn sẽ khác, vì vậy hãy tự đo.
Model nhỏ hơn#
Bảng benchmark YOLO26 trên COCO:
| Model | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
Trên CPU, mỗi lần giảm một cỡ giúp tăng tốc 2.2–2.5×. Chênh lệch độ chính xác trên COCO là trường hợp xấu nhất: detector 3 lớp dùng trong kho với vật thể lớn thường mất ít độ chính xác hơn nhiều khi giảm từ m xuống n so với detector tổng quát 80 lớp, vì vậy model nhỏ hơn luôn đáng để thử nghiệm trên tập val của riêng bạn.
Đầu vào nhỏ hơn#
Tính toán tăng gần tương ứng với số pixel, vì vậy imgsz=480 chỉ cần khoảng 56% khối lượng xử lý so với 640. Số liệu đo trên CPU của laptop thử nghiệm, dùng ONNX Runtime với batch 1 (trung vị của 25 lần chạy trên bus.jpg):
| Model | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Quy tắc ra quyết định: nếu vật thể quan trọng nhỏ nhất vẫn chiếm khoảng 10 pixel trở lên ở kích thước mới, hãy thử; nếu vật thể nhỏ hoặc ở xa (drone, hàng hóa trên kệ cách xa camera), hãy giữ độ phân giải và giảm kích thước model thay thế.
Ít frame hơn#
Nếu inference giới hạn tốc độ khung hình và cảnh chuyển động chậm, hãy chạy detection trên mỗi frame thứ N bằng vid_stride=N và để tracker kết nối các khoảng trống:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsXử lý một nửa số frame tốn khoảng một nửa thời gian, và tracker duy trì được 30 trong số 32 định danh. Ở vid_stride=3, tracker mất 4 định danh; đó là dấu hiệu nên dừng thử nghiệm với cảnh có tốc độ di chuyển như người đi bộ này.
Giảm chi phí cloud#
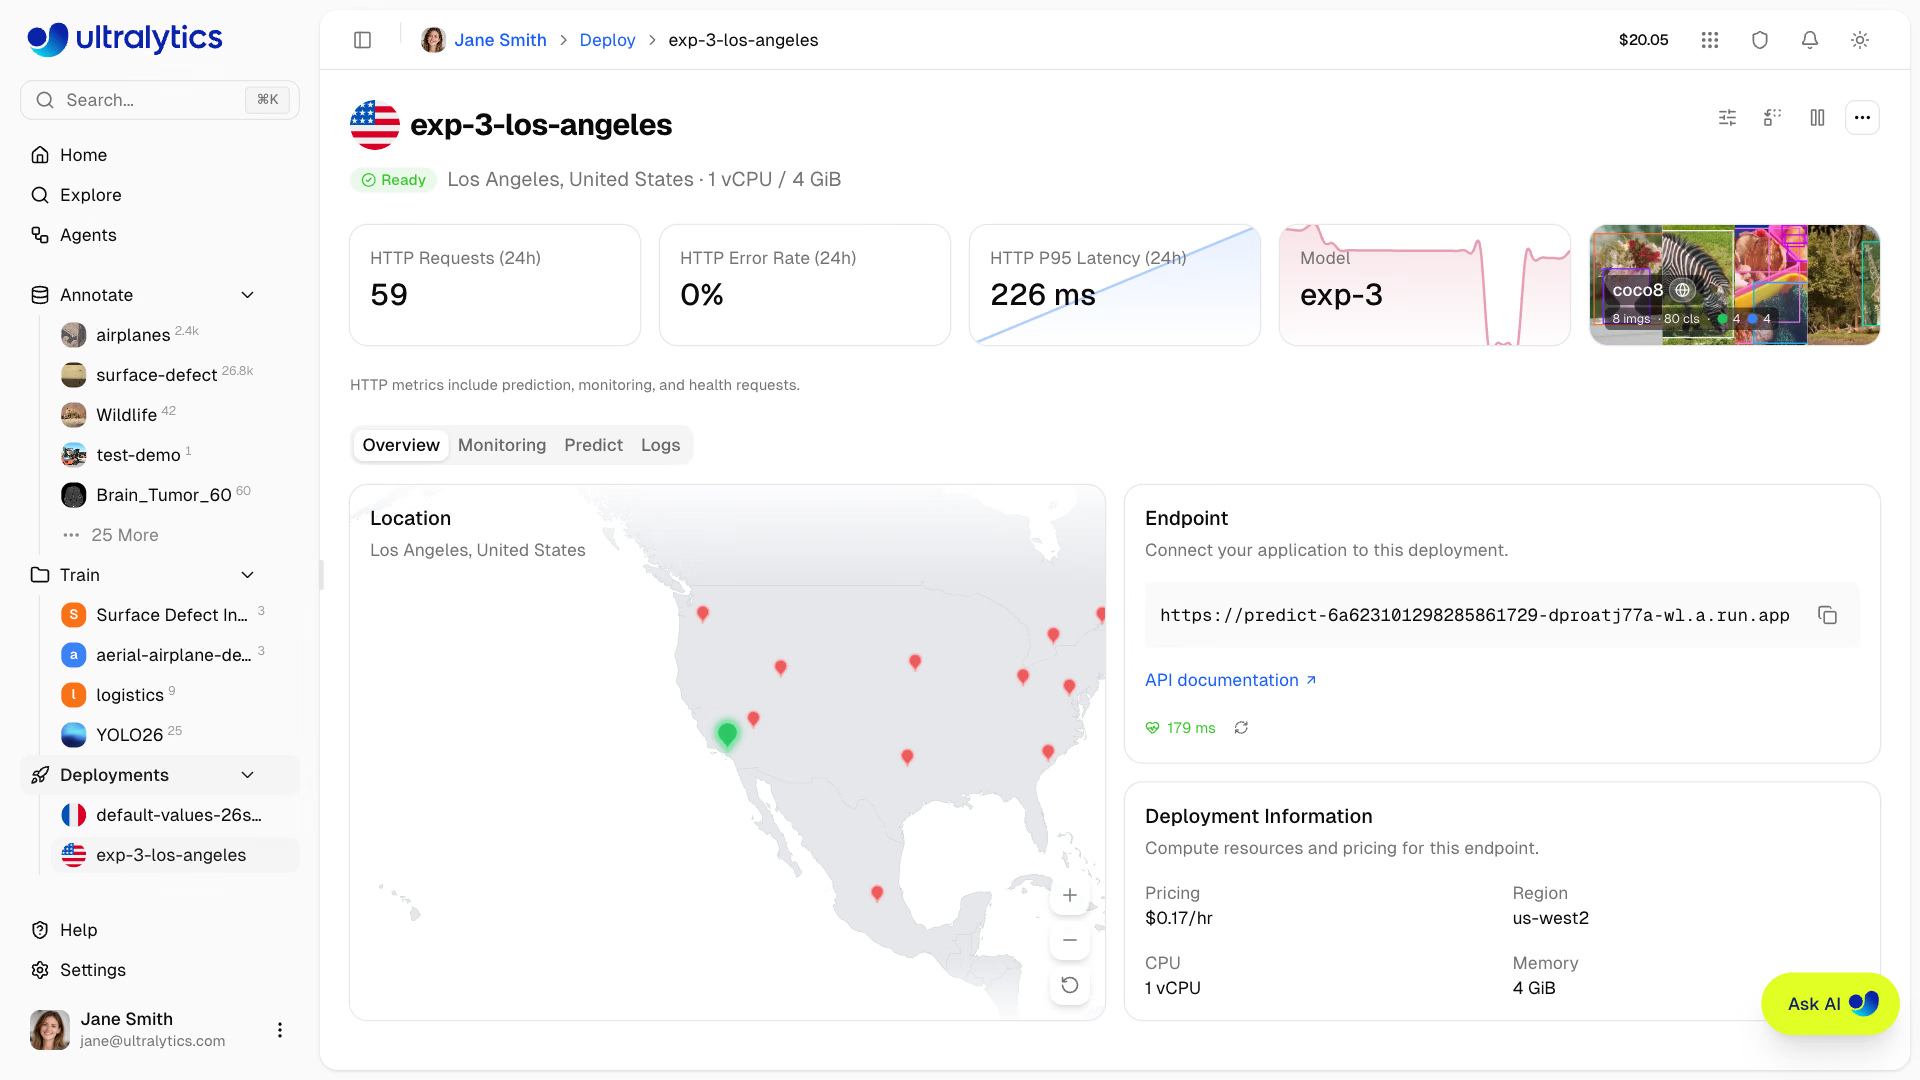
Chi phí bằng số giờ chạy instance chia cho khối lượng công việc hữu ích. Thẻ như hình này có hai con số bạn cần: chi phí mỗi giờ (0,17 USD cho 1 vCPU và 4 GiB ở đây) và khối lượng công việc xử lý được (59 yêu cầu trong 24 giờ với P95 là 226 ms, tức endpoint hầu như không hoạt động). Tiếp theo:
- Tăng mức sử dụng. GPU có mức sử dụng 30% đang lãng phí 70% chi phí. Hãy gom các luồng thành batch (bài học trước) hoặc phục vụ inference qua Triton Inference Server.
- Chọn quy mô phù hợp. Benchmark trên GPU nhỏ hơn hoặc CPU với OpenVINO trước khi cho rằng bạn cần GPU lớn.
- Dùng capacity theo hình thức spot hoặc có thể thu hồi cho các tác vụ batch. Xử lý lại video lưu trữ có thể chấp nhận gián đoạn; luồng trực tiếp thì không.
Các lỗi thường gặp#
Triệu chứng: hai tuần tinh chỉnh giúp tiết kiệm 10 ms nhưng hệ thống vẫn chậm. Cách khắc phục: trước tiên, lập hồ sơ hiệu năng toàn bộ pipeline và tối ưu giai đoạn chiếm nhiều thời gian nhất, bất kể đó là giai đoạn nào.
Triệu chứng: if i % 2: continue bên trong vòng lặp kết quả không giúp tiết kiệm gì. Cách khắc phục: model đã chạy trên frame đó; hãy bỏ qua frame ngay tại nguồn bằng vid_stride.
Triệu chứng: thông lượng tăng nhưng mỗi frame đến muộn hơn. Cách khắc phục: batch lớn hơn tăng thông lượng trên mỗi đô la, chứ không giảm độ trễ trên mỗi frame; hãy dùng batch cho nhiều luồng hoặc tác vụ offline, không phải cho một camera thời gian thực.
Khi đã khai thác hết các đòn bẩy từ model, dữ liệu tốt hơn là lựa chọn tiếp theo. Dataset phù hợp với production giúp model nhỏ hơn đạt độ chính xác mà trước đây cần model lớn hơn: giảm chi phí mà không mất độ chính xác.
Hiển thị lời giải
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Mỗi hàng bỏ qua năm lần chạy đầu để warm-up và báo cáo trung vị của các lần còn lại. Chọn hàng đầu tiên đáp ứng ngân sách độ trễ với mức giảm mAP nằm trong giới hạn bạn đặt ra. Ví dụ về ngân sách: "hai ngày, giảm tối đa 1 điểm mAP, 20 FPS trên máy tại cửa hàng." Nếu yolo26s ở 640 không đạt 50 ms mỗi frame còn yolo26n ở 640 đáp ứng yêu cầu trong giới hạn 1 điểm trên tập val của bạn, hãy dừng ở đó; đừng dành ngày thứ hai để thử 480.