Tối ưu hóa với TensorRT
Tạo engine TensorRT FP16, quyết định liệu INT8 có đáng để đánh đổi độ chính xác hay không, rồi kiểm tra engine trước khi triển khai.
Trên GPU NVIDIA, engine TensorRT FP16 thường là cách tăng tốc rẻ nhất mà bạn có thể đạt được: nhanh hơn khoảng 1,5× trong benchmark A100 của Ultralytics mà không làm thay đổi mAP. INT8 tăng tốc hơn nữa, nhưng INT8 hậu huấn luyện làm YOLO26s đến YOLO26m mất 4 đến 6 điểm mAP trên COCO. Bài học này giúp bạn biết mình đang thực hiện bước nào và đo lường trước khi người dùng làm điều đó.
Thực hành
Mã trong bài học này cần GPU NVIDIA đã cài TensorRT. Mọi tham số được trình bày đều có trong tài liệu chế độ Export dành cho format=engine.
FP16 là bước đầu an toàn#
GPU NVIDIA từ Volta trở đi có tensor core FP16, và model phát hiện hiếm khi cần FP32 khi inference. Hãy bắt đầu ở đây:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # hoặc runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Engine FP16, workspace của builder tối đa 4 GiB
workspace giới hạn dung lượng bộ nhớ GPU mà TensorRT có thể dùng trong quá trình tạo engine; để trống nếu muốn TensorRT tự quyết định. Trang tích hợp TensorRT công bố kết quả này trên A100 (YOLOv8n, 640 px):
| Precision | Predict, batch 8 (ms) | mAP50-95 trên COCO val |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
Model này cũ hơn YOLO26, nhưng quy luật đánh đổi vẫn đúng: FP16 nhanh hơn khoảng 1,5× mà không mất gì; INT8 tăng thêm 1,2× nhưng mất 4 điểm. Nếu FP16 đáp ứng ngân sách, hãy triển khai.
Không có GPU NVIDIA tại chỗ? Tab Export của Ultralytics Platform tạo engine trên GPU đám mây mà bạn chọn, với cùng các tùy chọn về kích thước hình ảnh, độ chính xác, batch, dynamic, NMS và workspace:

Chọn dòng GPU mà bạn sẽ triển khai: engine trong ảnh chụp màn hình được tạo trên RTX 5090 và chỉ chạy được trên dòng GPU đó.
INT8 cần dữ liệu hiệu chuẩn#
INT8 lượng tử hóa các activation của từng layer thành 256 mức. Để chọn các dải giá trị này, exporter chạy các hình ảnh hiệu chuẩn qua model và ghi lại các activation quan sát được, vì vậy hình ảnh phải giống dữ liệu thực tế:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # # Hình ảnh hiệu chuẩn lấy từ phần val của dataset này; dùng my_dataset/data.yaml
    fraction=1.0,  # # Tỷ lệ (hoặc số lượng) hình ảnh sẽ dùng
    batch=8,  # # Batch hiệu chuẩn lớn hơn giúp các dải giá trị ổn định hơn
    dynamic=True,  # # Với batch=8, engine chấp nhận batch từ 1 đến 8
    workspace=4,
)
Chi phí độ chính xác của INT8 tùy thuộc vào model. Tài liệu chế độ Export đã đo các engine TensorRT YOLO26 trên COCO val (mAP50-95):
| Model | Engine FP32 | INT8, đã hiệu chuẩn (PTQ) | INT8 sau huấn luyện có nhận biết lượng tử hóa (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
Chỉ riêng hiệu chuẩn đã khiến YOLO26n mất 1 điểm, còn các model lớn hơn mất 4–6 điểm. QAT tinh chỉnh model bằng quantize=8 trong train để trọng số chịu được INT8; checkpoint chứa sẵn các dải giá trị riêng, bản export INT8 không cần dữ liệu hiệu chuẩn và đạt kết quả chênh FP32 chỉ 1–2 điểm. Quyết định như sau:
Kiểm tra engine trước khi triển khai#
Mọi engine đều phải vượt qua cùng các bước kiểm tra trên GPU triển khai:
| Bước kiểm tra | Tiêu chí kiểm tra |
|---|---|
| mAP50-95 trên tập val của bạn | Chênh FP32 không quá 0,5 điểm với FP16; nằm trong ngân sách đã ghi rõ của bạn với INT8 |
| AP theo từng lớp | Không lớp nào giảm quá khoảng 1 điểm (các lớp nhỏ thường biến động nhiều nhất) |
| Độ trễ p95 | Dưới ngân sách ở batch size dùng trong thực tế |
| Ngưỡng vận hành | conf được chọn lại từ đường cong F1 của chính engine |
| Tính xác định | Cùng một hình ảnh chạy hai lần cho ra chính xác cùng các bounding box |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
Nguồn gốc của mức tăng tốc#
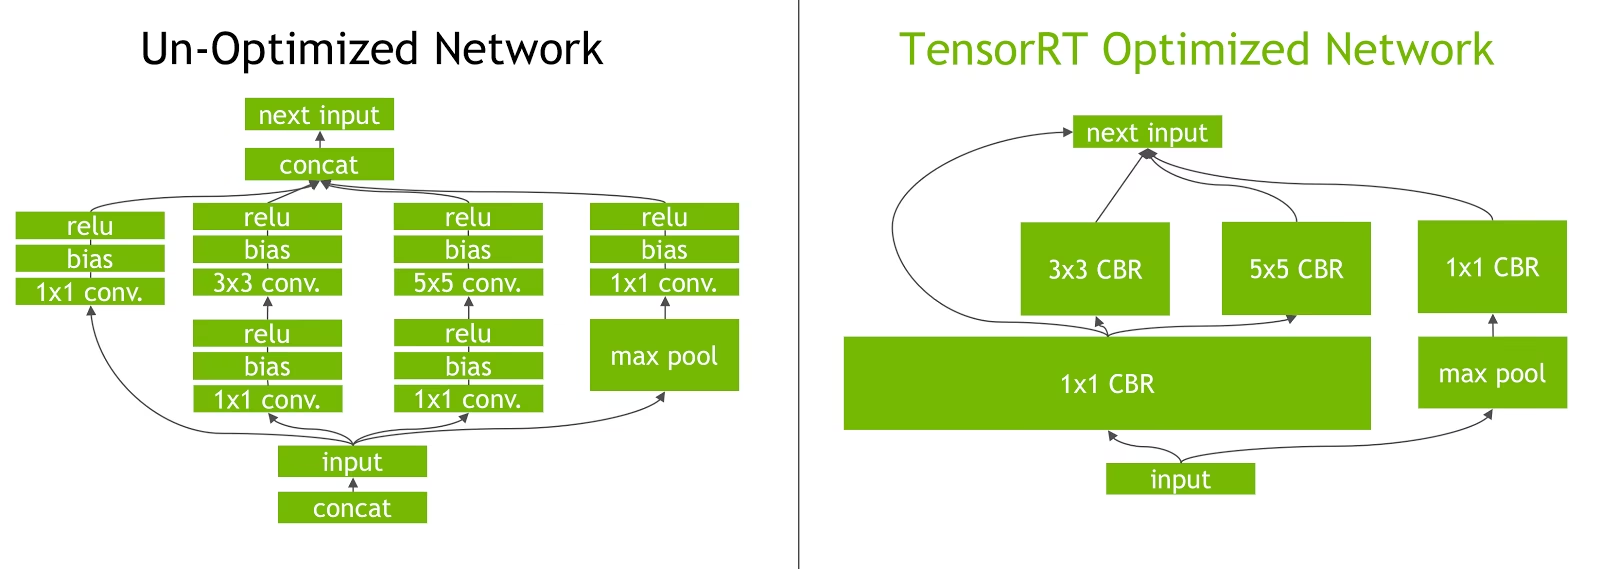
TensorRT hợp nhất convolution, bias và ReLU thành một kernel (các khối "CBR" ở bên phải) và loại bỏ các bước concat, nhờ đó GPU khởi chạy ít kernel hơn nhiều và di chuyển ít dữ liệu hơn. Trong YOLO26, điều này tăng tốc các chuỗi conv-BN-activation trên toàn mạng, khối attention (PSA) trong backbone và nhiều thao tác nhỏ trong detection head. Nếu engine vẫn chậm, hãy phân tích bằng trtexec hoặc NVIDIA Nsight: thường một layer chiếm từ 30% thời gian trở lên.
Các lỗi thường gặp#
Triệu chứng: INT8 làm giảm 1 điểm trên COCO nhưng giảm 6 điểm trên camera của bạn. Cách khắc phục: hiệu chỉnh bằng một phần dữ liệu giữ lại từ tập validation của bạn; NVIDIA khuyến nghị ít nhất 500 ảnh đại diện. Kết quả hiệu chỉnh cũng khác nhau giữa các thiết bị, vì vậy hãy hiệu chỉnh trên GPU sẽ dùng để triển khai.
Triệu chứng: recall giảm sau khi chuyển sang INT8 mà vẫn giữ nguyên conf. Cách khắc phục: INT8 có thể làm dịch chuyển giá trị confidence; hãy chọn lại conf dựa trên đường cong F1 riêng của engine INT8.
Triệu chứng: engine không giải tuần tự được hoặc chạy chậm hơn dự kiến trên máy triển khai. Cách khắc phục: build trên dòng GPU triển khai với runtime TensorRT và CUDA tương thích, đồng thời phân phối .onnx để các thiết bị có thể build lại. Nếu hiệu chỉnh gặp lỗi trong quá trình build, hãy tăng workspace hoặc giảm imgsz hay batch.
Trên Jetson, DeepStream chạy các engine tạo ra trong pipeline video tăng tốc phần cứng; tại trung tâm dữ liệu, Triton Inference Server cung cấp dịch vụ inference cho các engine đó.
Hiển thị lời giải
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Một báo cáo đạt yêu cầu ghi: chênh lệch dưới 0,5 điểm, p95 dưới ngân sách, quyết định triển khai FP16. Nếu p95 không đạt, hãy export INT8 bằng YAML hiệu chuẩn của bạn, chạy lại hai lệnh tương tự và chỉ triển khai INT8 nếu mức chênh lệch vẫn nằm trong ngân sách đã ghi trước khi bắt đầu; nếu không, hãy thử QAT hoặc model nhỏ hơn.