Suy luận đa luồng
Chạy nhiều camera qua một model bằng suy luận theo batch, hàng đợi có giới hạn và số liệu frame bị mất được đo lường.
Một hệ thống xử lý kịp một camera có thể chậm trễ hàng phút khi tăng lên bốn camera mà không có lỗi nào xảy ra: kết quả chỉ đến muộn dần cho đến khi hết bộ nhớ. Trên CPU laptop được dùng ở đây, một luồng 30 FPS được xử lý kịp, bốn luồng mất một nửa số frame, còn tám luồng mất hơn hai phần ba. Bài học này xây dựng pipeline để đo con số đó, vì đây là cách xác định cấu hình phần cứng.
Thực hành
Thời gian được phân bổ ở đâu#
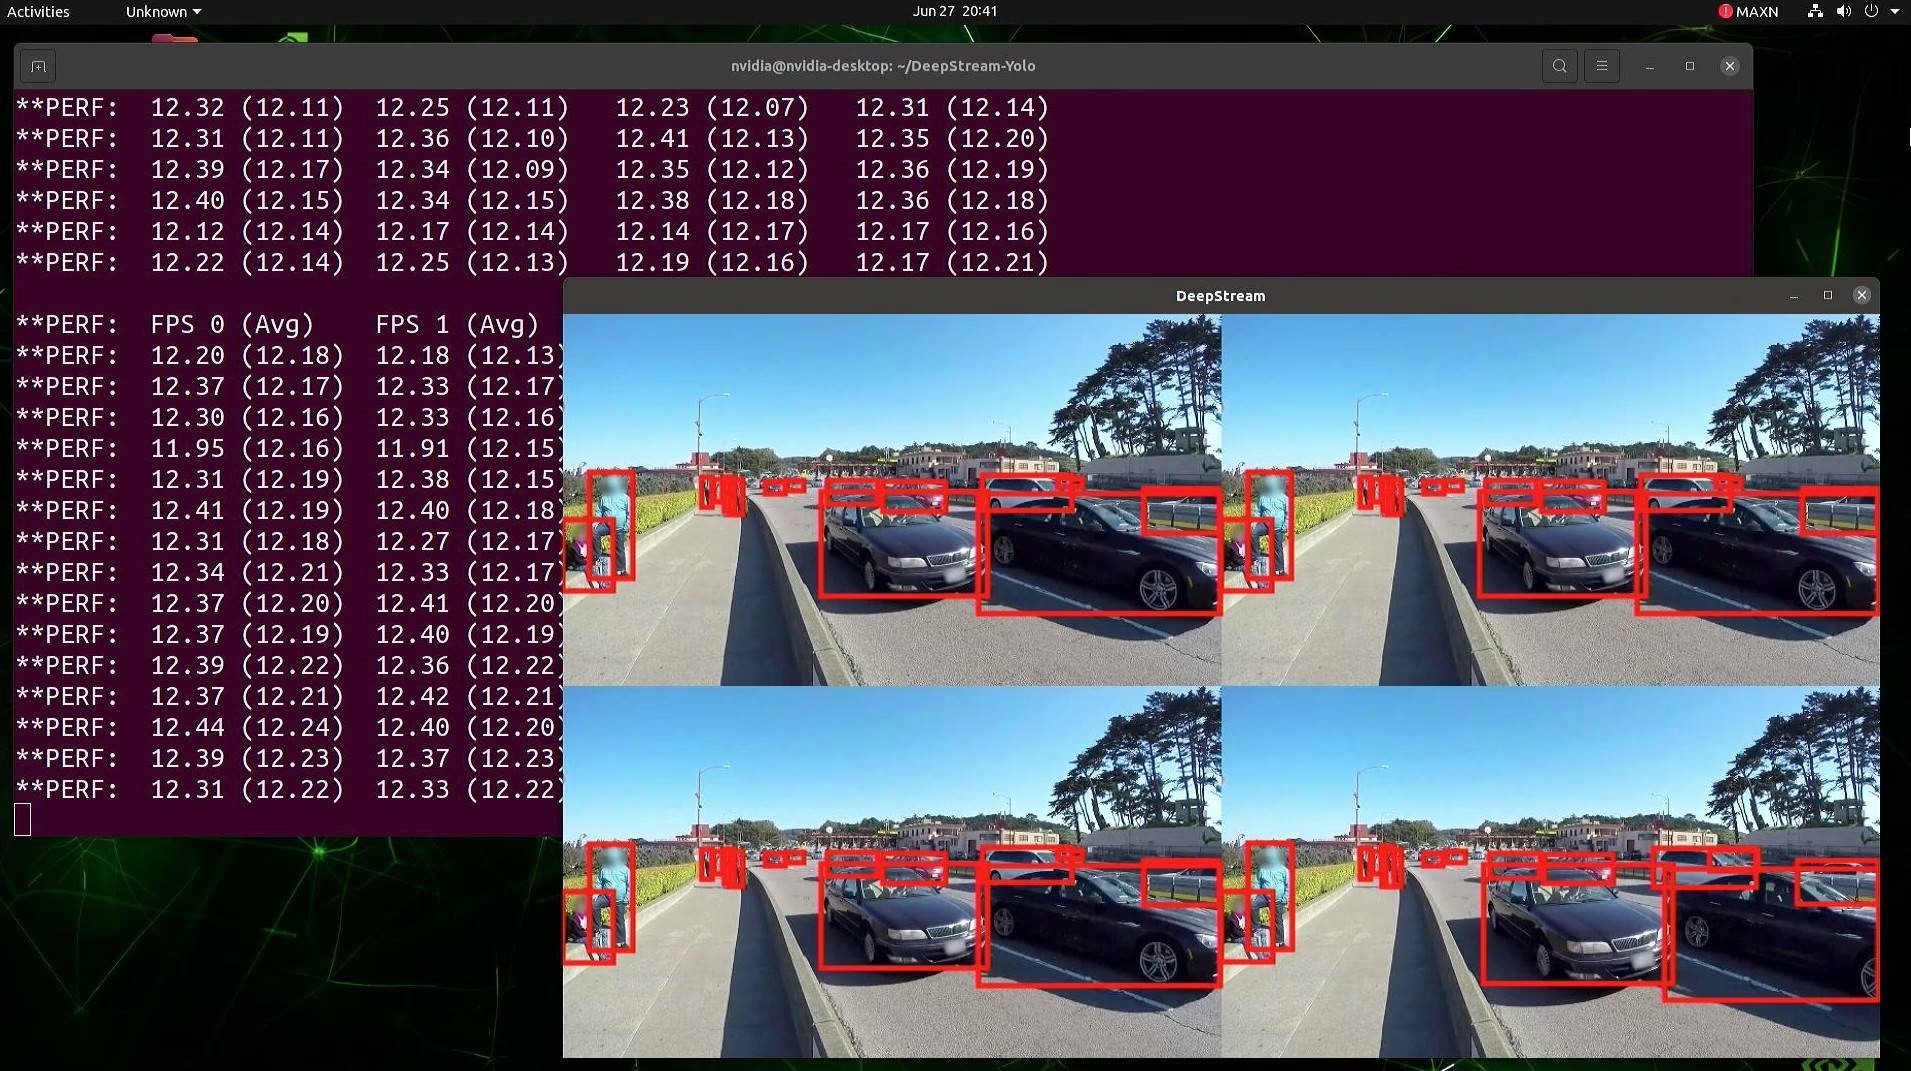
Mỗi frame đi qua bốn giai đoạn:
| Giai đoạn | Chi phí điển hình | Chạy trên |
|---|---|---|
| Giải mã (RTSP hoặc file → mảng) | 5–20 ms mỗi frame 1080p | CPU |
| Tiền xử lý (letterbox, chuẩn hóa) | khoảng 1 ms | CPU |
| Suy luận | vài ms (GPU) đến vài chục ms (CPU) | Bộ tăng tốc |
| Hậu xử lý, tracking, đầu ra | vài ms, lâu hơn với cơ sở dữ liệu chậm | CPU |
Chạy lần lượt từng giai đoạn cho từng camera trong một thread khiến bộ tăng tốc ở trạng thái chờ trong khi frame được giải mã. Giải pháp là tách riêng các giai đoạn, như pipeline DeepStream ở trên thực hiện: bốn luồng dùng chung một thiết bị, mỗi luồng báo cáo FPS riêng (khoảng 12 ở đây). Cấu trúc tương tự trong Python:
Tích hợp sẵn: file .streams#
Ultralytics tự động batch nhiều nguồn cho bạn. Đặt mỗi nguồn trên một dòng trong file .streams rồi truyền file đó vào chế độ Predict hoặc Track. Mỗi luồng có reader thread và tracker riêng, đồng thời mỗi vòng lặp chạy một lượt forward theo batch trên tất cả luồng:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # production: một URL rtsp:// trên mỗi dòng

model = YOLO("yolo26n.pt")  # dùng bản export đã tối ưu trong production
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path cho biết kết quả này đến từ luồng nào
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Cả hai luồng đều tạo ra 62 kết quả vì quá trình lặp dừng khi luồng ngắn nhất kết thúc (clip sân bay có 150 frame). stream_buffer=True xử lý mọi frame, phù hợp với file video đã ghi; với camera trực tiếp, hãy giữ mặc định False để model chậm bỏ qua các frame cũ thay vì ngày càng tụt lại. Kết hợp với bản export TensorRT hoặc OpenVINO để đạt thông lượng tốt nhất cho từng luồng.
Tùy chỉnh: Producer-Consumer với bộ đếm frame bị mất#
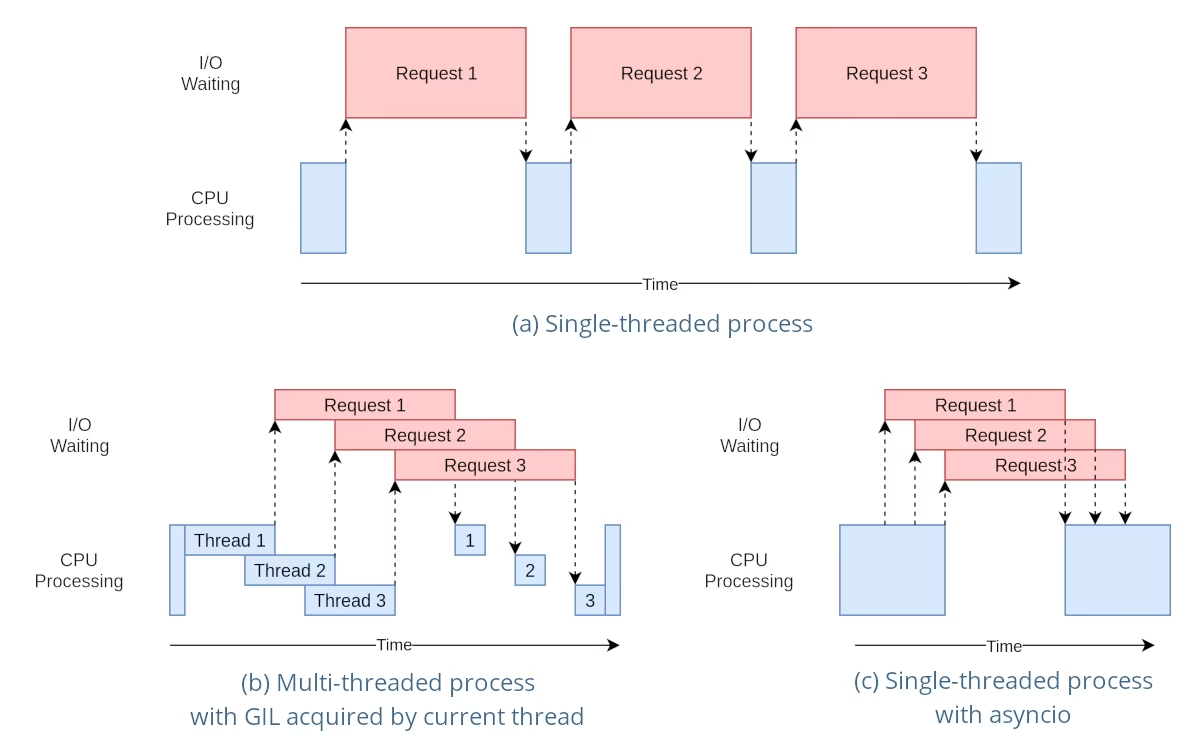
Sơ đồ cho thấy vì sao thread phù hợp với pipeline này. Giải mã chủ yếu là chờ (các thanh I/O màu hồng), còn OpenCV và PyTorch giải phóng GIL của Python trong khi xử lý, nên các thread giải mã có thể chồng lấp hiệu quả (khung b). Hậu xử lý Python nặng thì không thể chồng lấp; hãy chuyển phần đó sang các process riêng.
Khi cần đầu ra riêng, logic theo từng camera hoặc chỉ số frame bị mất tường minh, hãy tự xây dựng pipeline. Các thread giải mã không bao giờ truy cập model; một vòng lặp consumer duy nhất sở hữu model, đồng thời giúp bạn tuân thủ các quy tắc suy luận an toàn luồng:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Hai clip có lần lượt 62 và 150 frame, và mọi frame đều được xử lý hoặc bị mất (56 + 6 = 62, 131 + 19 = 150), vì vậy bộ đếm tính đủ tất cả frame. Có 25 trong số 212 frame bị mất: CPU của laptop này không thể chạy yolo26n bằng PyTorch trên hai luồng 30 FPS. Lặp lại các clip để mô phỏng nhiều camera hơn trong một lượt kiểm tra:
| Số luồng (mỗi luồng 30 FPS) | Số frame bị mất |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Lập kế hoạch năng lực dựa trên số liệu đo#
Số luồng trên mỗi thiết bị ≈ thông lượng duy trì (số frame model xử lý mỗi giây ở batch size của bạn) ÷ FPS yêu cầu trên mỗi luồng. Đo thông lượng bằng bản export đã tối ưu từ các bài học trước trên phần cứng thực tế, duy trì 20–30% dự phòng cho các đợt tăng tải và phát cảnh báo khi số frame bị mất lớn hơn không. Độ phân giải cao hơn làm tăng chi phí gần tương ứng với số pixel: 1280×1280 cần khoảng 4× năng lực tính toán so với 640×640. Với các hệ thống quy mô lớn, Triton Inference Server và DeepStream trên Jetson là những nền tảng production phù hợp.
Các lỗi thường gặp#
Triệu chứng: model.track(["cam1.mp4", "cam2.mp4"]) coi danh sách là một batch ảnh, không phải các luồng. Cách khắc phục: ghi các nguồn vào tệp .streams, mỗi nguồn một dòng.
Triệu chứng: mỗi tệp chỉ trả về một hoặc hai frame. Cách khắc phục: stream_buffer=False loại bỏ các frame cũ, còn trình đọc tệp chạy nhanh hơn model; đặt stream_buffer=True cho tệp và giữ giá trị mặc định cho camera trực tiếp.
Triệu chứng: thỉnh thoảng có kết quả sai hoặc lẫn lộn khi hệ thống tải cao. Cách khắc phục: không bao giờ gọi cùng một instance YOLO đồng thời từ nhiều luồng. Hãy để một consumer sở hữu instance đó như trên, hoặc tạo model bên trong mỗi luồng suy luận.
Triệu chứng: độ trễ tăng lên theo từng phút và bộ nhớ tăng cho đến khi tiến trình bị dừng. Cách khắc phục: dùng hàng đợi có giới hạn, loại bỏ phần tử khi hàng đợi đầy và đếm số frame bị loại bỏ. Hệ thống thời gian thực nên bỏ frame khi quá tải thay vì để độ trễ tăng.
Hiển thị lời giải
Thêm các dòng sau vào producer_consumer.py, ngay sau dòng SOURCES, để biến số luồng thành đối số dòng lệnh:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # số camera được mô phỏng
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Sau đó tăng dần số lượng:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Kết quả trên máy này là một luồng: bắt đầu mất frame khi chạy hai luồng. Để xử lý bốn camera, hãy export sang runtime nhanh hơn (bài học 3 và 4), giảm imgsz hoặc chuyển sang bộ tăng tốc, rồi chạy lại phép kiểm tra.