OpenVINO trên CPU
Export các model OpenVINO FP32, FP16 và INT8, xác thực từng model, và chỉ giữ INT8 khi model thực sự có lợi trên CPU của bạn.
CPU Intel mà bạn đã có thường có thể thay thế một instance GPU: trong các benchmark của Ultralytics, YOLO26m giảm từ 192 ms với PyTorch xuống 36 ms với OpenVINO INT8 trên CPU Core Ultra của laptop. Tuy nhiên, mức cải thiện tùy thuộc vào chip; trên laptop ARM dùng để thử nghiệm khóa học này, bản export INT8 được hiệu chuẩn bằng bốn hình ảnh làm mất 3 điểm mAP. Bạn sẽ học cách đo lường để xác định trường hợp của mình trước khi triển khai.
Thực hành
OpenVINO mang lại điều gì#
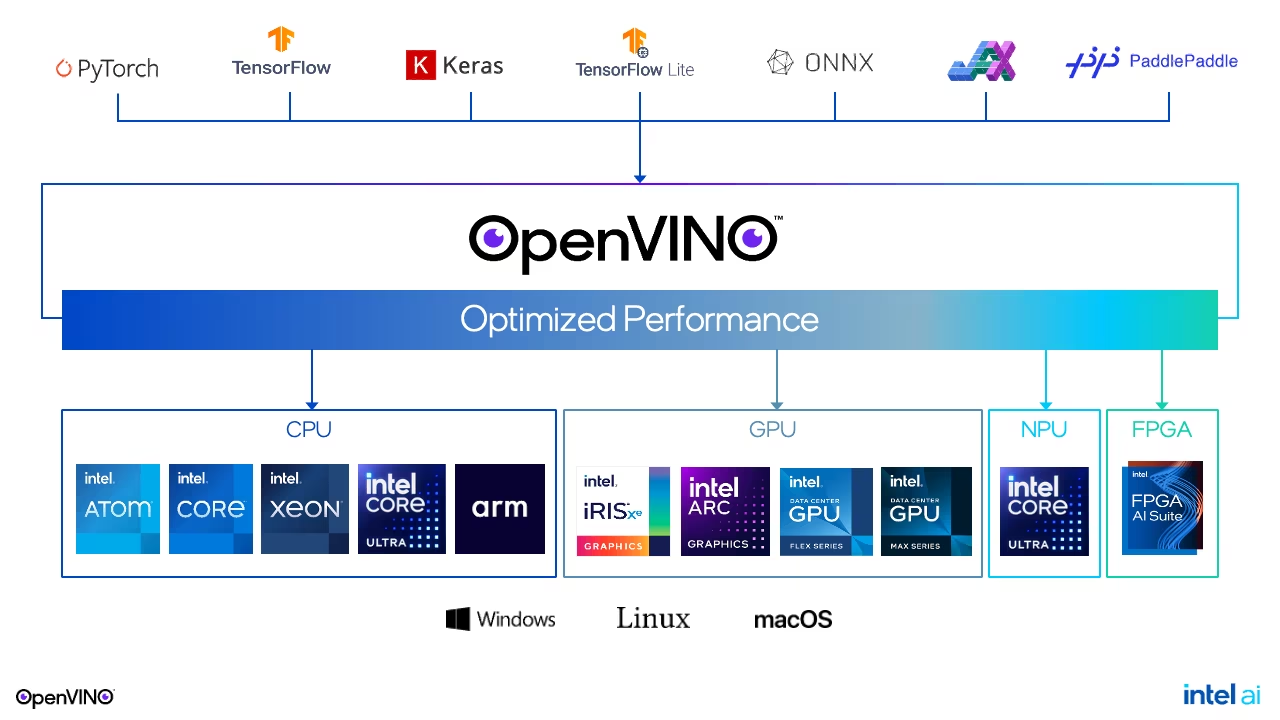
OpenVINO nhận model từ PyTorch và ONNX, rồi chạy trên CPU Intel, GPU tích hợp và GPU rời, cũng như NPU thông qua một API. Kernel CPU của OpenVINO nhắm đến các tập lệnh Intel (AVX2, AVX-512, AMX), còn quy trình INT8 đã hoàn thiện. Hãy chú ý ô ARM trong cột CPU: OpenVINO cũng chạy trên ARM, nhưng kernel được tối ưu cho Intel, vì vậy hãy đo lường trước khi dựa vào OpenVINO trên ARM.
Benchmark được công bố trên CPU Intel Core Ultra 7 155H (COCO128):
| Model | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 FP32 → INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Bảng này cho thấy ba quy tắc:
- Chỉ riêng OpenVINO FP32 đã giảm gần một nửa độ trễ của PyTorch trên CPU Intel. Hãy bắt đầu bằng bước này.
- INT8 càng có lợi khi model lớn hơn: 1,2× với
n, 2,9× vớim, đổi lại mất 1,2–1,7 điểm mAP. Vớin, INT8 hiếm khi đáng để đánh đổi độ chính xác. - Hãy thử GPU tích hợp trước khi mua phần cứng: iGPU Arc (
device="intel:gpu") của cùng chip chạy YOLO26n FP32 trong 9.13 ms và YOLO26m trong 34.47 ms.
So sánh các precision trên CPU của bạn#
Export từng precision, xác thực ngay sau đó, rồi mới export precision tiếp theo:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Ý nghĩa của từng dòng:
- FP32 và FP16 đạt điểm số như nhau, còn FP16 chỉ chiếm một nửa dung lượng (5.1 so với 9.6 MB), nhưng cả hai đều được ghi vào cùng một thư mục. Nếu bạn export cả hai trước rồi mới xác thực, bạn đã đo FP16 hai lần.
- INT8 có dung lượng 3.2 MB và mất 3.2 điểm, vì model được hiệu chuẩn bằng bốn hình ảnh của COCO8. Cảnh báo cũng nêu rõ điều đó: hiệu chuẩn thực tế cần hàng trăm hình ảnh gần giống dữ liệu sản xuất từ YAML của riêng bạn (
fractiongiới hạn số hình ảnh được dùng). - Không có bước nào trong số này đo tốc độ. Để đo tốc độ, hãy dùng benchmark bên dưới.
Để chạy model đã export trên một thiết bị Intel cụ thể:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # hoặc intel:gpu, intel:npu
Triển khai toàn bộ thư mục: yolo26n.xml (đồ thị), yolo26n.bin (trọng số) và metadata.yaml. intel:gpu và intel:npu cần phần cứng Intel.
Đo thời gian và so sánh với ONNX Runtime#
Độ chính xác đã được xác định; tốc độ phụ thuộc vào thiết bị đích và tải thực tế mà thiết bị phải xử lý. Chạy pick_runtime.py từ bài học đầu tiên với CANDIDATES = ("onnx", "openvino"). Trên laptop thử nghiệm Apple silicon, khi CPU được chia sẻ với các tác vụ khác:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO có median tốt hơn nhưng tail latency kém hơn nhiều. Wrapper Ultralytics biên dịch OpenVINO với gợi ý LATENCY (log ghi Using OpenVINO LATENCY mode for batch=1 inference on CPU), khiến mỗi yêu cầu được phân bổ trên các core CPU; khi các tác vụ khác tranh chấp những core này, các yêu cầu chậm nhất bị ảnh hưởng nhiều nhất. Trên máy Intel chuyên dụng, kết quả thường giống như số liệu công bố ở trên, nhưng chỉ p95 của chính bạn mới cho biết chắc chắn.
Quy tắc quyết định:
Các lỗi thường gặp#
Triệu chứng: bản export FP16 có kích thước bằng một nửa nhưng tốc độ không đổi. Cách khắc phục: trên hầu hết CPU, plugin tự chọn độ chính xác tính toán; dùng FP16 để giảm kích thước tải xuống, và dùng INT8 hoặc iGPU để tăng tốc.
Triệu chứng: FP32 và FP16 báo các con số giống hệt nhau vì thực chất chúng là cùng một tệp. Cách khắc phục: bản export FP32 và FP16 dùng chung thư mục *_openvino_model/; hãy validation (hoặc đổi tên thư mục) ngay sau mỗi lần export.
Triệu chứng: tốc độ trung bình có vẻ ổn nhưng frame vẫn bị rớt vào những lúc tải cao. Cách khắc phục: đo thời gian suy luận khi hệ thống đang chạy tải production và đánh giá theo p95, không phải giá trị trung bình. Với nhiều luồng trên một server, hãy biên dịch bằng gợi ý THROUGHPUT bằng cách tải .xml trực tiếp qua runtime OpenVINO, như hướng dẫn chế độ độ trễ và thông lượng.
Trên macOS và Windows, validation khởi chạy các tiến trình worker nhập lại script của bạn. Nếu thiếu if __name__ == "__main__":, lần chạy thử cho bài học này đã lặp lại các lần export trong những worker đó, gây lãng phí vài phút và tranh chấp CPU mà bài kiểm tra đang cố đo.
Hiển thị lời giải
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Một ví dụ quyết định dựa trên các số liệu Core Ultra 7 155H ở trên:
| Tùy chọn | mAP50-95 | Quy mô | ms mỗi ảnh |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Triển khai OpenVINO FP32 trên GPU tích hợp: đây là tùy chọn nhanh nhất mà không làm giảm độ chính xác, trong khi INT8 trên CPU phải đánh đổi 1.2 điểm để tiết kiệm 2 ms. Với một triển khai YOLO26m, lựa chọn sẽ chuyển sang CPU INT8 (nhanh hơn 2.9× với mức giảm 1.7 điểm), nếu mức giảm đó nằm trong ngân sách cho phép.