Points clés personnalisés et métriques OKS
Conçois un schéma de points clés pour des objets non humains, rédige et vérifie le YAML du jeu de données, puis définis les sigmas OKS selon la précision avec laquelle chaque point peut être placé.
La pose ne concerne pas uniquement les personnes. Les extrémités des fourches d’un chariot élévateur, les coins d’une étiquette de colis, le museau et la queue d’un animal — tout objet doté de points stables et nommables peut constituer un jeu de données de pose. Le schéma que tu rédiges le premier jour est définitif : chaque étiquette, chaque paire de retournement et chaque métrique en dépend, et le modifier par la suite signifie tout réannoter. Cette leçon permet de définir correctement le schéma avant que qui que ce soit n’annote un millier d’images et montre exactement comment la métrique l’évaluera.
Pratique
Concevoir le schéma de points clés#
Les bons points clés partagent trois propriétés : sans ambiguïté (deux personnes chargées de l’annotation placent le point au même endroit), stables (le point existe dans chaque pose prise par l’objet) et utiles (un calcul en aval les exploite). Prenons un chariot élévateur vu par une caméra au plafond, pour lequel la question produit est « les fourches sont-elles relevées pendant que le chariot se déplace ? » :
| Indice | Point clé | Raison d’être | Point miroir |
|---|---|---|---|
| 0 | left_fork_tip | étendue et direction des fourches | 1 |
| 1 | right_fork_tip | étendue et direction des fourches | 0 |
| 2 | mast_top | hauteur des fourches par rapport au mât | 2 (lui-même) |
| 3 | mast_base | point de référence sur le châssis | 3 (lui-même) |
Chaque point est justifié par sa contribution au calcul : les extrémités des fourches indiquent la direction et les deux points du mât indiquent la hauteur. Évalue chaque point candidat selon les mêmes critères :
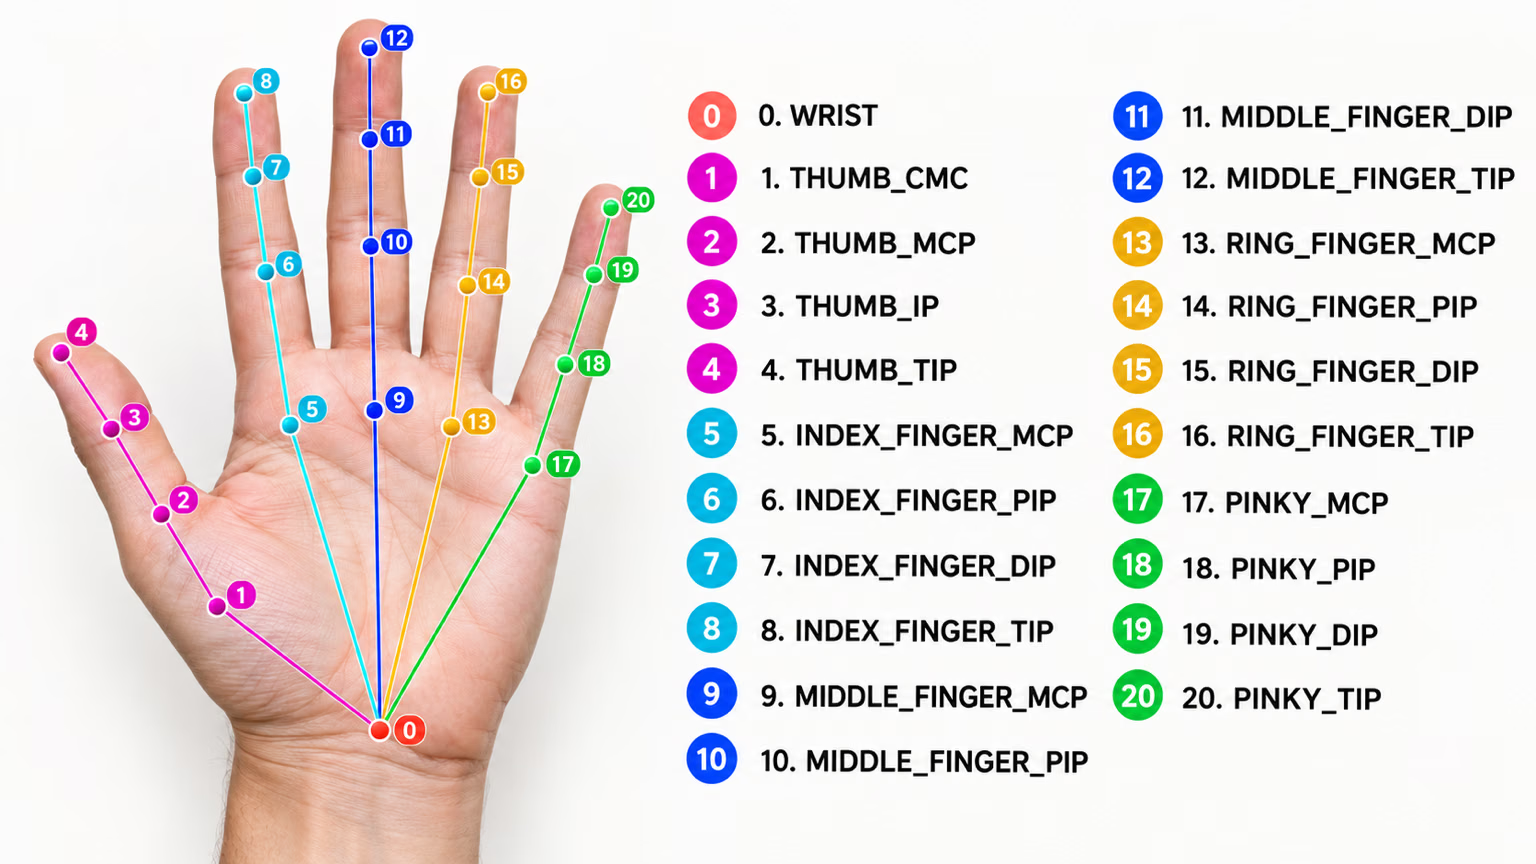
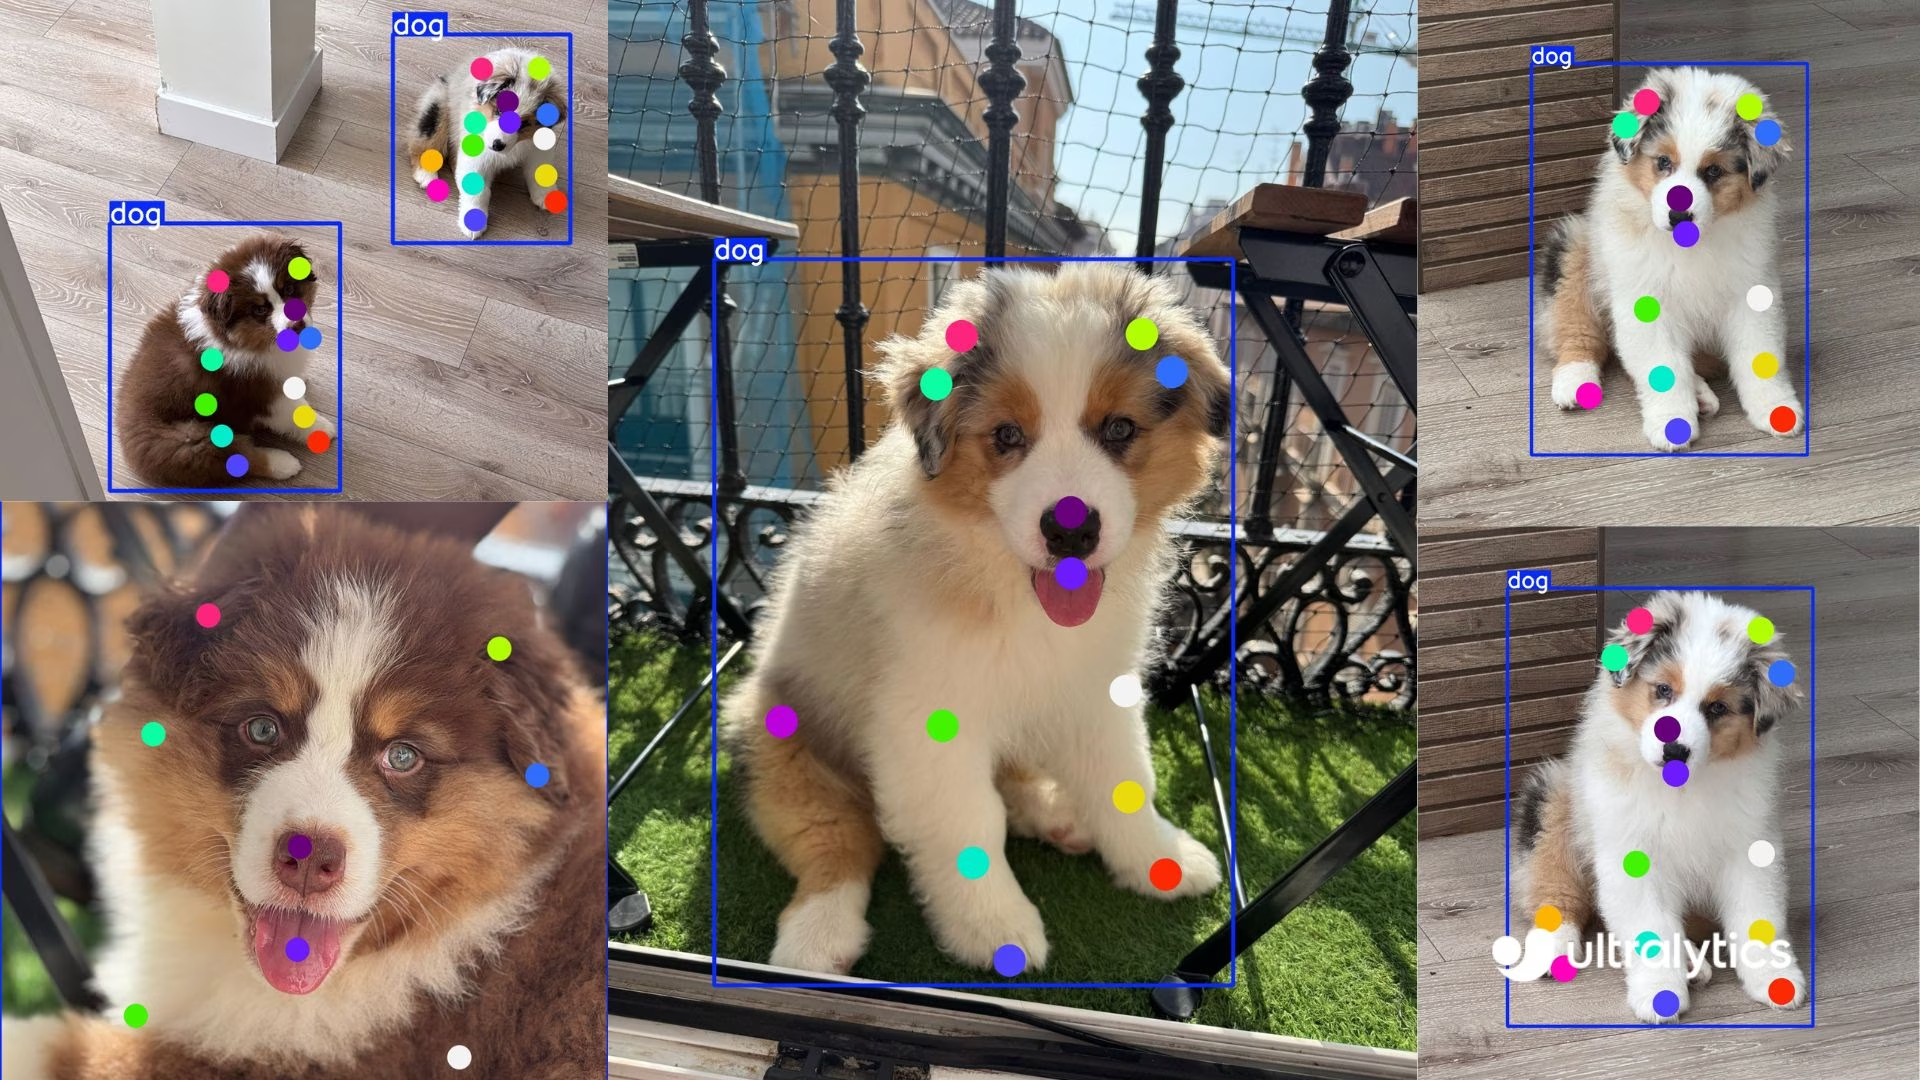
Résiste à la tentation d’ajouter des points « au cas où » : chacun augmente le temps d’annotation de chaque instance, et les points que personne n’exploite ne font qu’ajouter du bruit à la métrique. Les jeux de données publics illustrent l’éventail : Tiger-Pose utilise 12 points sans visibilité, Dog-Pose en utilise 24 et Hand Keypoints en utilise 21 :
Rédiger le YAML du jeu de données#
path: forklift-pose
train: images/train
val: images/val

kpt_shape: [4, 3] # 4 keypoints, each x, y, visibility
flip_idx: [1, 0, 2, 3] # fork tips swap, mast points stay
kpt_oks_sigmas: [0.05, 0.05, 0.08, 0.08] # tips are sharp, mast ends are fuzzier

names:
  0: forklift

kpt_names:
  0:
    - left_fork_tip
    - right_fork_tip
    - mast_top
- mast_basekpt_namesdocumente l’ordre des points pour les personnes et les outils, classe par classe.flip_idxdoit être auto-inverse : appliqué deux fois, il renvoie chaque indice à lui-même.kpt_oks_sigmasest facultatif et pondère à la fois la perte des points clés pendant l’entraînement et l’OKS pendant la validation ; s’il est présent, il doit contenir une valeur positive par point clé, faute de quoi l’exécution s’arrête avec unValueError.
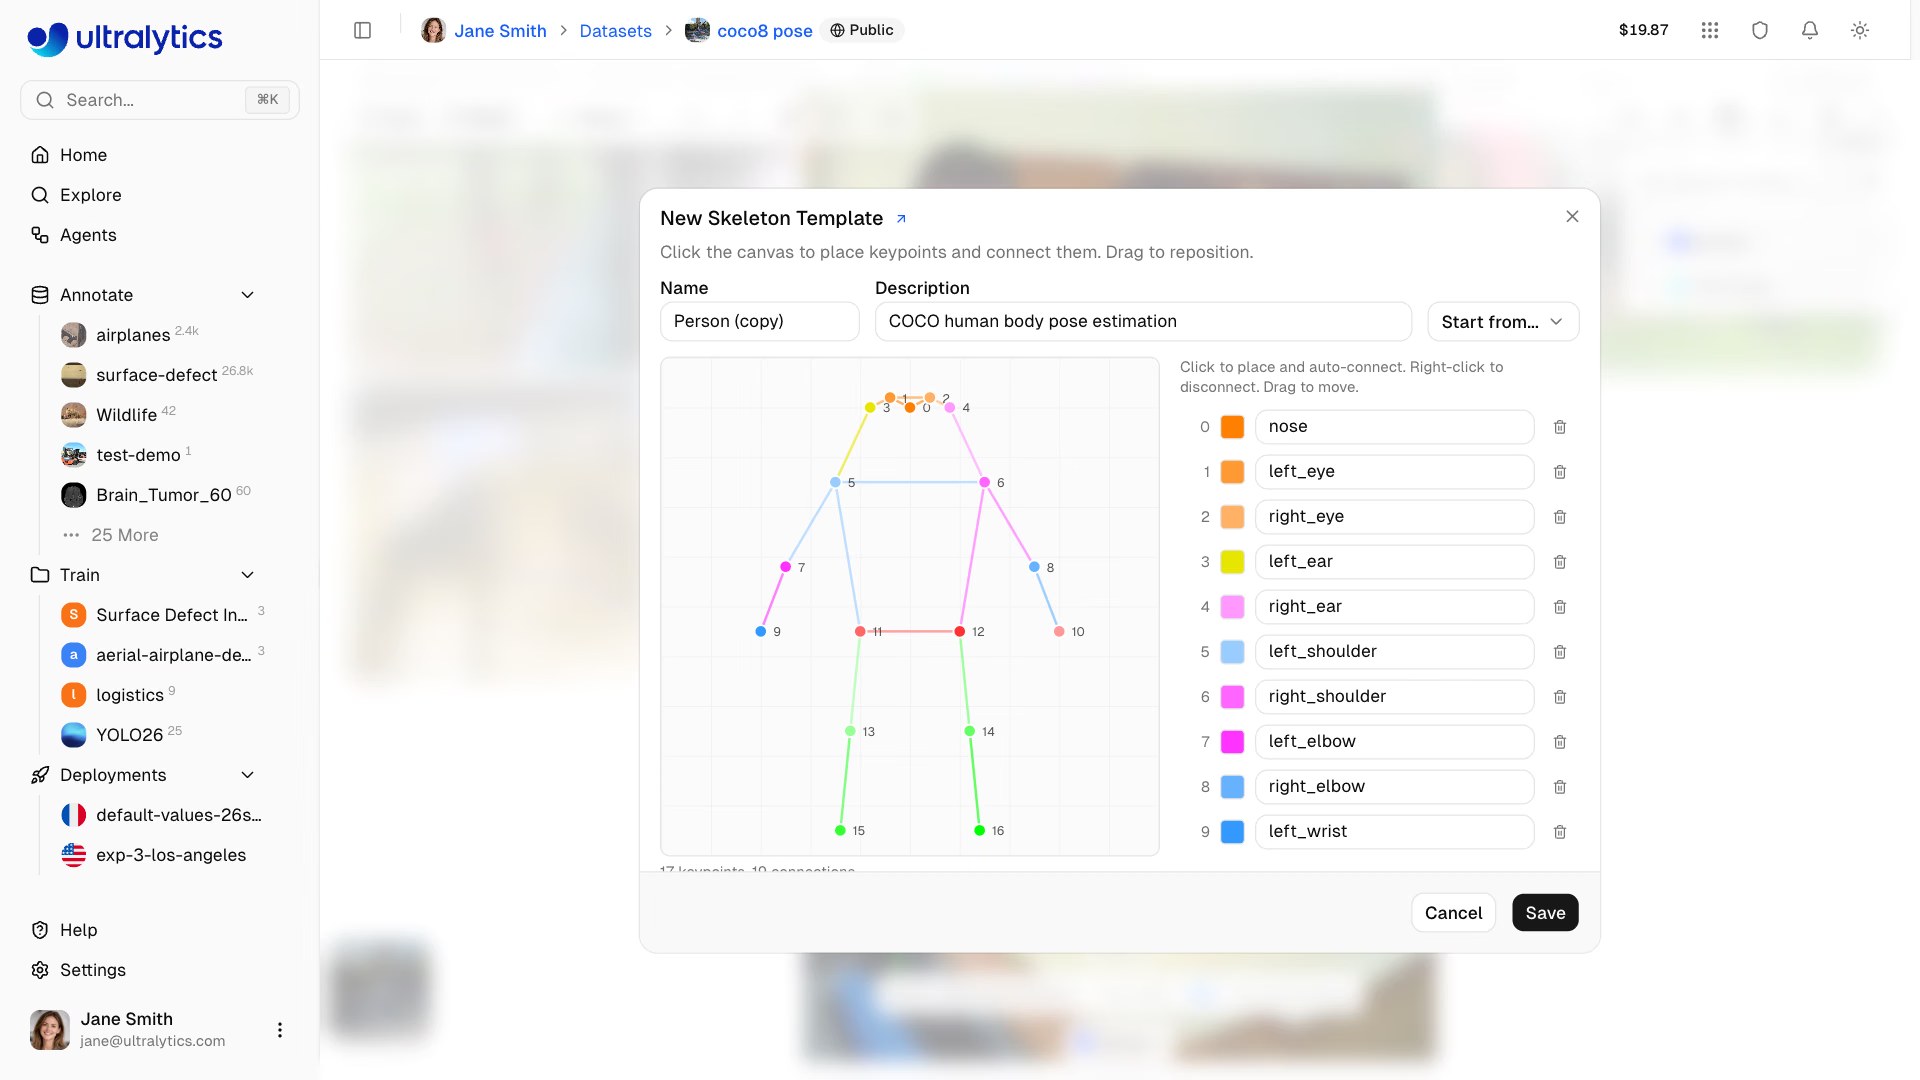
Sur Ultralytics Platform, le même schéma est un modèle de squelette. Un nouveau modèle peut partir d’un modèle existant (Partir de…) ; tu renommes et supprimes alors des points au lieu de placer chaque point clé manuellement — conserve l’ordre des indices de ton tableau de schéma :
Vérifier les étiquettes avant l’entraînement#
Les jeux de données de pose échouent discrètement : une ligne à laquelle il manque un point clé décale toutes les valeurs suivantes, et une visibilité de 3 provenant d’un exporteur défectueux est interprétée comme n’importe quel autre nombre. Ce vérificateur charge le YAML avec le chargeur propre à Ultralytics et valide chaque ligne. Il fonctionne tel quel sur COCO8-pose ; remplace le chemin par celui de ton YAML :
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-pose.yaml")  # resolves paths, downloads if needed
k, dims = data["kpt_shape"]
flip = data.get("flip_idx", [])
assert not flip or sorted(flip) == list(range(k)), "flip_idx must list every keypoint index once"
assert all(flip[flip[i]] == i for i in range(len(flip))), "flip_idx must undo itself: pairs swap, center points stay"

expected = 5 + k * dims  # class + 4 box values + k keypoints of `dims` values
bad = 0
for label in Path(data["path"], "labels").rglob("*.txt"):
    for n, row in enumerate(label.read_text().splitlines(), 1):
        values = row.split()
        if len(values) != expected:
            bad += 1
            print(f"{label.name}:{n} has {len(values)} values, expected {expected}")
        elif dims == 3 and not {float(v) for v in values[7::3]} <= {0, 1, 2}:
            bad += 1
            print(f"{label.name}:{n} has a visibility flag outside 0/1/2")
print(f"kpt_shape={data['kpt_shape']}, flip_idx ok, {bad} bad rows")
kpt_shape=[17, 3], flip_idx ok, 0 bad rowsvalues[7::3] commence au premier indicateur de visibilité (classe, quatre valeurs de boîte, puis x y v) et prélève ensuite une valeur sur trois.
Comment l’OKS évalue un point clé#
La mAP de pose remplace l’IoU des boîtes par la similarité des points clés d’objet (OKS). Pour chaque point clé annoté, l’OKS transforme la distance en pixels entre la prédiction et l’annotation en un score de 0 à 1, ajusté selon la taille de l’objet et le sigma de ce point clé, puis calcule la moyenne sur les points clés annotés. La mAP50-95 de pose calcule la moyenne de la précision aux seuils d’OKS de 0.50 à 0.95, exactement comme la mAP des boîtes aux seuils d’IoU ; le guide des métriques de performance présente le mécanisme commun.
Pour comprendre les sigmas, le plus simple est de les mesurer. Ce script évalue la même prédiction de chariot élévateur avec deux sigmas, à l’aide de la fonction kpt_iou appelée par le validateur de pose :
import torch

from ultralytics.utils.metrics import kpt_iou

# One labeled forklift, 4 keypoints (x, y, visibility) in pixels, inside a 200 x 120 px box
label = torch.tensor([[[40.0, 30, 2], [40, 90, 2], [170, 20, 2], [170, 100, 2]]])
area = torch.tensor([200 * 120 * 0.53])  # Ultralytics scales box area by 0.53 to approximate object area

for offset in (2, 5, 10, 20):
    pred = label.clone()
    pred[..., 0] += offset  # every predicted keypoint lands `offset` pixels to the right
    sharp = kpt_iou(label, pred, area, sigma=[0.025] * 4).item()
    loose = kpt_iou(label, pred, area, sigma=[0.10] * 4).item()
    print(f"{offset:2d} px off: OKS {sharp:.2f} with sigma 0.025, {loose:.2f} with sigma 0.10")
2 px off: OKS 0.94 with sigma 0.025, 1.00 with sigma 0.10
5 px off: OKS 0.67 with sigma 0.025, 0.98 with sigma 0.10
10 px off: OKS 0.21 with sigma 0.025, 0.91 with sigma 0.10
20 px off: OKS 0.00 with sigma 0.025, 0.67 with sigma 0.10Pour un chariot élévateur de 200 × 120 pixels, une prédiction décalée de 10 pixels échoue au seuil OKS de 0.50 avec un sigma de 0.025 et réussit tous les seuils jusqu’à 0.90 avec un sigma de 0.10. Même modèle, même erreur, mAP de pose très différente.
| Sigma | Effet | Utilisation |
|---|---|---|
| Petit (≈ 0.025–0.05) | quelques pixels d’écart suffisent déjà à faire baisser le score | points précis : yeux, extrémités des fourches, coins |
| Grand (≈ 0.08–0.10) | tolérance élevée | points flous : hanches, milieu d’un mât |
| Par défaut | Sigmas COCO pour kpt_shape: [17, 3] ; sinon, 1/K pour chaque point | commence par là, puis mesure |
Les sigmas doivent refléter la régularité avec laquelle les personnes chargées de l’annotation placent chaque point. Mesure-la : demande à deux personnes d’annoter les mêmes 50 images, puis compare les distances pour chaque point clé. Les points sur lesquels elles ne sont pas d’accord méritent des sigmas plus élevés ; sinon, la métrique pénalise le modèle pour le bruit humain.
Modifier kpt_oks_sigmas change la mAP de pose sans changer le modèle, comme le montre le tableau ci-dessus. Définis les sigmas avant d'établir ta première référence, consigne-les avec chaque résultat et ne compare jamais des exécutions validées avec des valeurs différentes.
Afficher la solution
Exemple d’un colis sur un convoyeur, vu de dessus, pour lequel la question est « l’étiquette est-elle face vers le haut et dans quelle direction est-elle tournée ? » :
| Indice | Point clé | Utilité | Point miroir | Sigma |
|---|---|---|---|---|
| 0 | label_top_left | orientation de l’étiquette | 1 | 0.04 |
| 1 | label_top_right | orientation de l’étiquette | 0 | 0.04 |
| 2 | label_bottom_right | orientation de l’étiquette | 3 | 0.04 |
| 3 | label_bottom_left | orientation de l’étiquette | 2 | 0.04 |
kpt_shape: [4, 3]
flip_idx: [1, 0, 3, 2]
kpt_oks_sigmas: [0.04, 0.04, 0.04, 0.04]
flip_idx réussit le contrôle d’auto-inversion : 0 → 1 → 0 et 2 → 3 → 2. Une étiquette retournée échange la gauche et la droite, mais conserve le haut et le bas : le coin supérieur gauche est donc associé au coin supérieur droit, et non au coin inférieur droit.
Pour déterminer la tolérance, définis sigma=[0.04] * 4 dans oks.py et prolonge la liste des décalages ; la boîte de l’étiquette fixe l’échelle, alors utilise une boîte de la taille d’une étiquette de colis typique dans tes images. Le décalage auquel l’OKS passe pour la première fois sous 0.5 correspond à l’erreur maximale que la précision de tes annotations permet au modèle.