Annoter et entraîner la segmentation d'instances
Crée des annotations polygonales, vérifie-les dans le code, entraîne yolo26n-seg.pt sur COCO8-seg et diagnostique un modèle à partir de l’écart entre ses métriques de boîtes et de masques.
La segmentation d'instances donne à chaque objet son propre contour, ce dont tu as besoin lorsque la décision dépend de la superficie, du chevauchement ou d'une limite. Les polygones sont les annotations les plus coûteuses que la plupart des équipes achètent, et une ligne mal formée ne fait pas planter l'entraînement : elle entraîne discrètement le modèle sur une forme incorrecte. Cette leçon présente le bon format de ligne, vérifie un jeu d'annotations dans le code et entraîne un premier modèle pour que tu puisses voir ce qu'apportent ces annotations supplémentaires : une deuxième métrique qui évalue les contours, et pas seulement les positions.
Pratique
La ligne d'annotation d'un polygone#
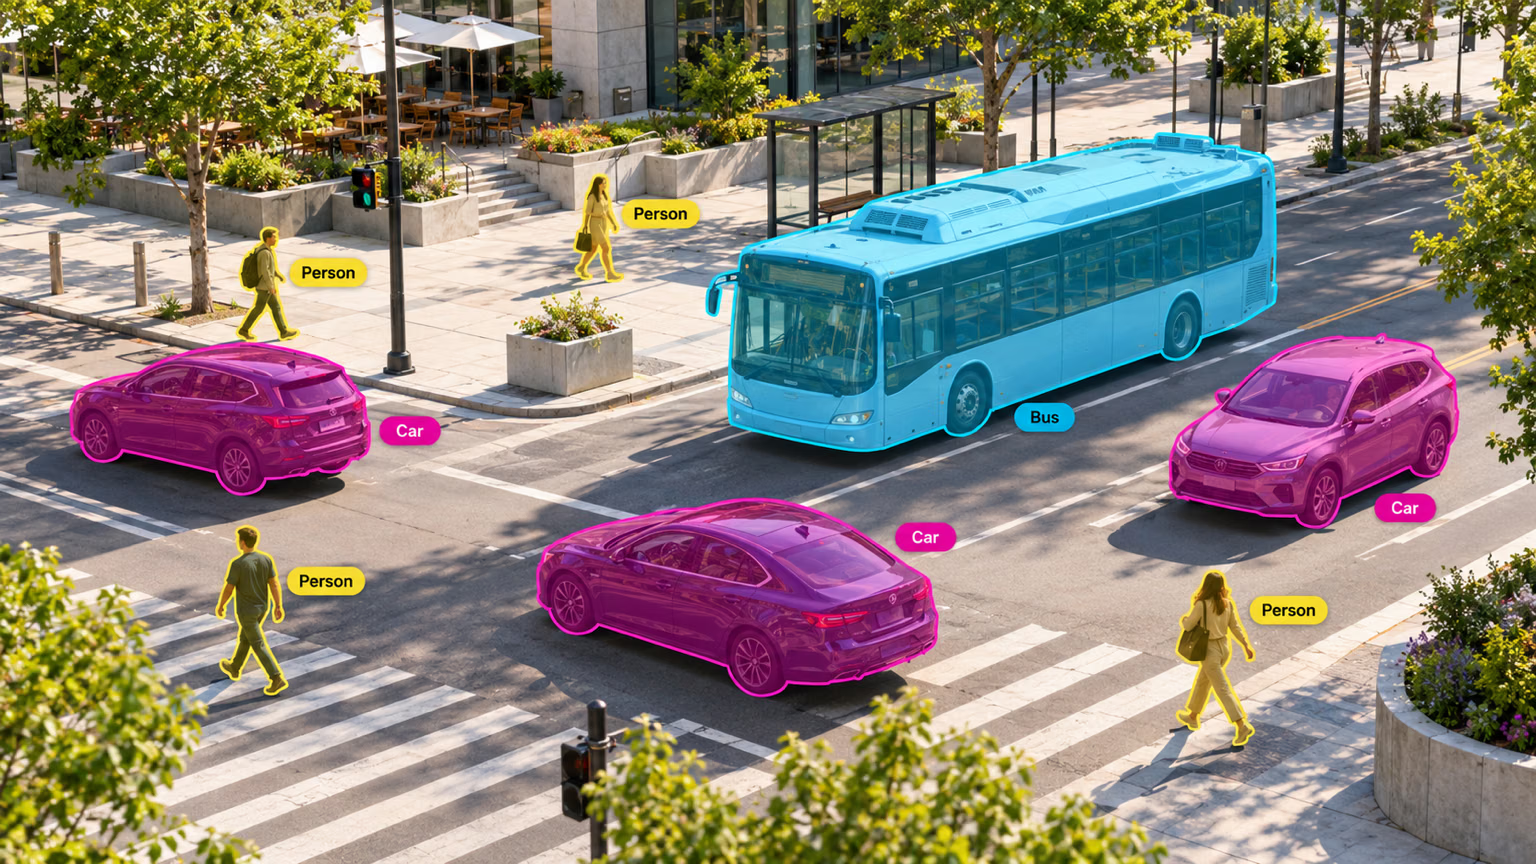
Un fichier d'annotations de segmentation contient une ligne par objet, comme un fichier d'annotations de détection, mais au lieu d'une boîte, il répertorie le contour de l'objet sous forme de paires de sommets normalisées. Voici une ligne réelle de COCO8-seg, raccourcie :
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| Position | Ligne de détection | Ligne de segmentation |
|---|---|---|
| 1 | indice de classe (45 correspond à bowl) | indice de classe |
| 2–5 | x_center y_center width height | les deux premiers sommets, x1 y1 x2 y2 |
| 6+ | — | d'autres sommets, autant que nécessaire pour le contour |
| Unités | normalisées de 0 à 1 | normalisées de 0 à 1 (x du pixel ÷ largeur de l'image, y du pixel ÷ hauteur de l'image) |
Trois règles sont essentielles : au moins trois sommets par objet, des coordonnées divisées par la taille de l'image et une ligne par instance, même lorsque deux objets de la même classe se touchent. Le guide des jeux de données de segmentation contient la spécification complète.
Les polygones sont un surensemble des étiquettes de boîtes. Le même dossier d'étiquettes entraîne yolo26n.pt (Ultralytics déduit chaque boîte de son polygone) et yolo26n-sem.pt (il rastérise les polygones pour créer des cartes de classes) — nous avons entraîné les deux avec coco8-seg.yaml. Si le plan change après l'étiquetage, le budget n'est pas perdu.
Vérifie les annotations avant l'entraînement#
Une ligne avec un nombre impair de valeurs, une coordonnée exprimée en pixels ou un contour tracé autour du mauvais objet n'interrompra pas l'entraînement. Ce vérificateur charge le jeu de données avec le chargeur propre à Ultralytics, rejette les lignes mal formées et affiche la superficie de chaque polygone à côté de la boîte qu'Ultralytics en déduira :
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38Les superficies sont exprimées en fractions de l'image : le premier bol couvre donc 39 % de sa photo. Le remplissage correspond à la superficie du polygone divisée par celle de la boîte ; c'est la colonne à examiner :
- La plupart des objets compacts (bols, oranges, brocolis) se situent autour de 0,6–0,7.
- La valeur de 0,31 pour la girafe est bien réelle : ses longues pattes et son cou laissent une grande partie de sa boîte vide, ce qui explique pourquoi cet objet a besoin d'un masque.
- La valeur de 0,15 pour le troisième bol correspond à la ligne qu'un réviseur devrait examiner. Seul un fin rebord de ce bol est visible autour des aliments ; son contour forme donc une bande étroite à l'intérieur d'une grande boîte. C'est correct dans ce cas ; dans tes données, un remplissage aussi faible indique tout aussi souvent un contour tracé autour du mauvais objet.
Corrige chaque ligne BAD avant l'entraînement. Trie ensuite par taux de remplissage et ouvre, dans un outil d'annotation, les quelques pour cent de lignes au taux le plus faible pour chaque classe : un faible taux de remplissage indique soit un objet fin ou occulté (à conserver), soit un tracé incorrect (à corriger).
Obtiens des polygones sans tracer chaque bord#
Le tracé manuel des contours est la partie coûteuse de l'annotation des données. Vérifie quelle solution s'applique avant de commencer :
| Tu as déjà | Outil |
|---|---|
| JSON COCO avec segmentation | convert_coco(labels_dir, use_segments=True) de ultralytics.data.converter |
| Masques PNG (valeur du pixel = indice de classe + 1, 0 = arrière-plan) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes) — les objets qui se touchent et appartiennent à une même classe forment un seul polygone ; il faut donc les séparer lors de la vérification |
| Annotations de boîtes uniquement | yolo_bbox2segment(im_dir) — envoie chaque boîte à SAM pour générer un polygone |
| Rien pour le moment | Annotation intelligente et annotation par lots — clique une fois, puis vérifie le polygone |
Sur Ultralytics Platform, le mode Smart exécute SAM : un clic positif sur l'objet et un clic négatif sur ce qu'il faut exclure génèrent un masque que tu peux ensuite vérifier.
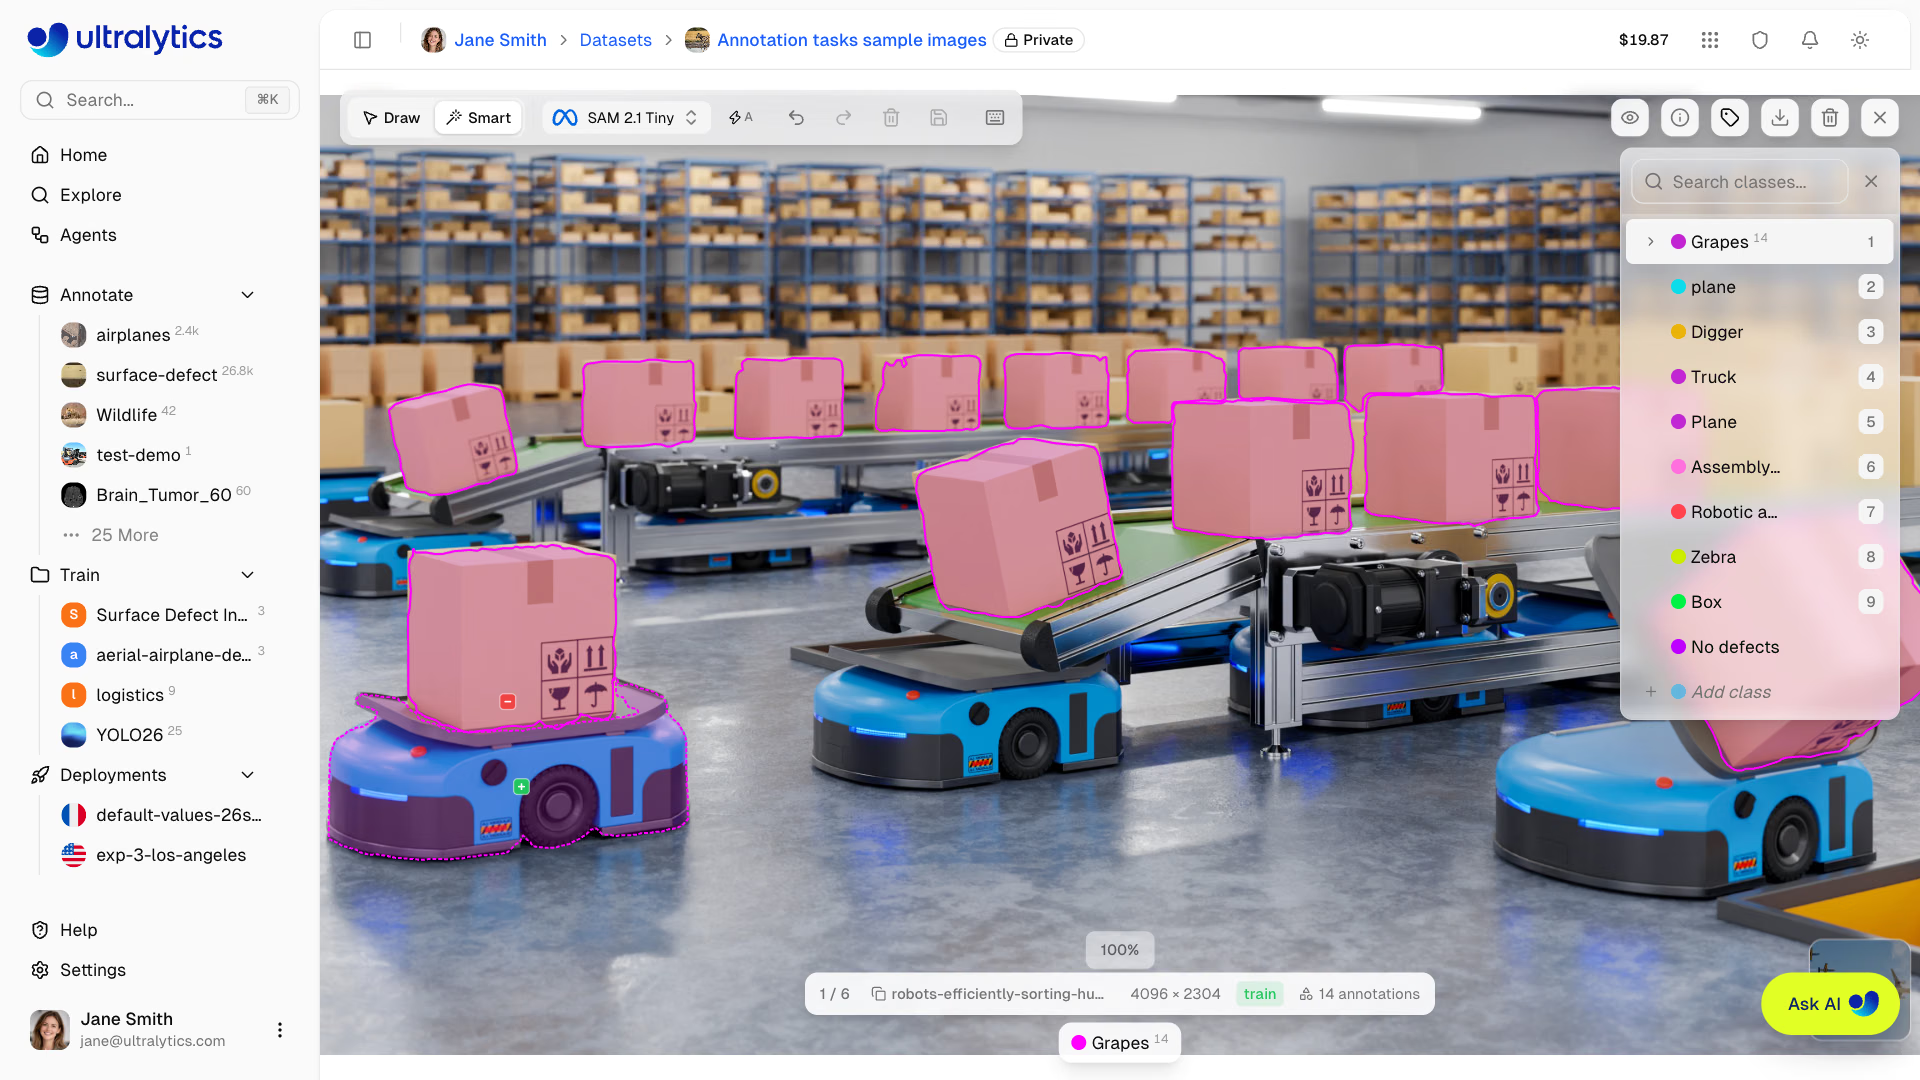
Un masque qui déborde sur l'arrière-plan entraîne le modèle à faire de même. Vérifie les polygones générés par la machine en fonction des critères de qualité de la leçon Boîtes ou masques, puis relance la vérification des étiquettes ci-dessus.
Entraîne le modèle sur COCO8-seg#
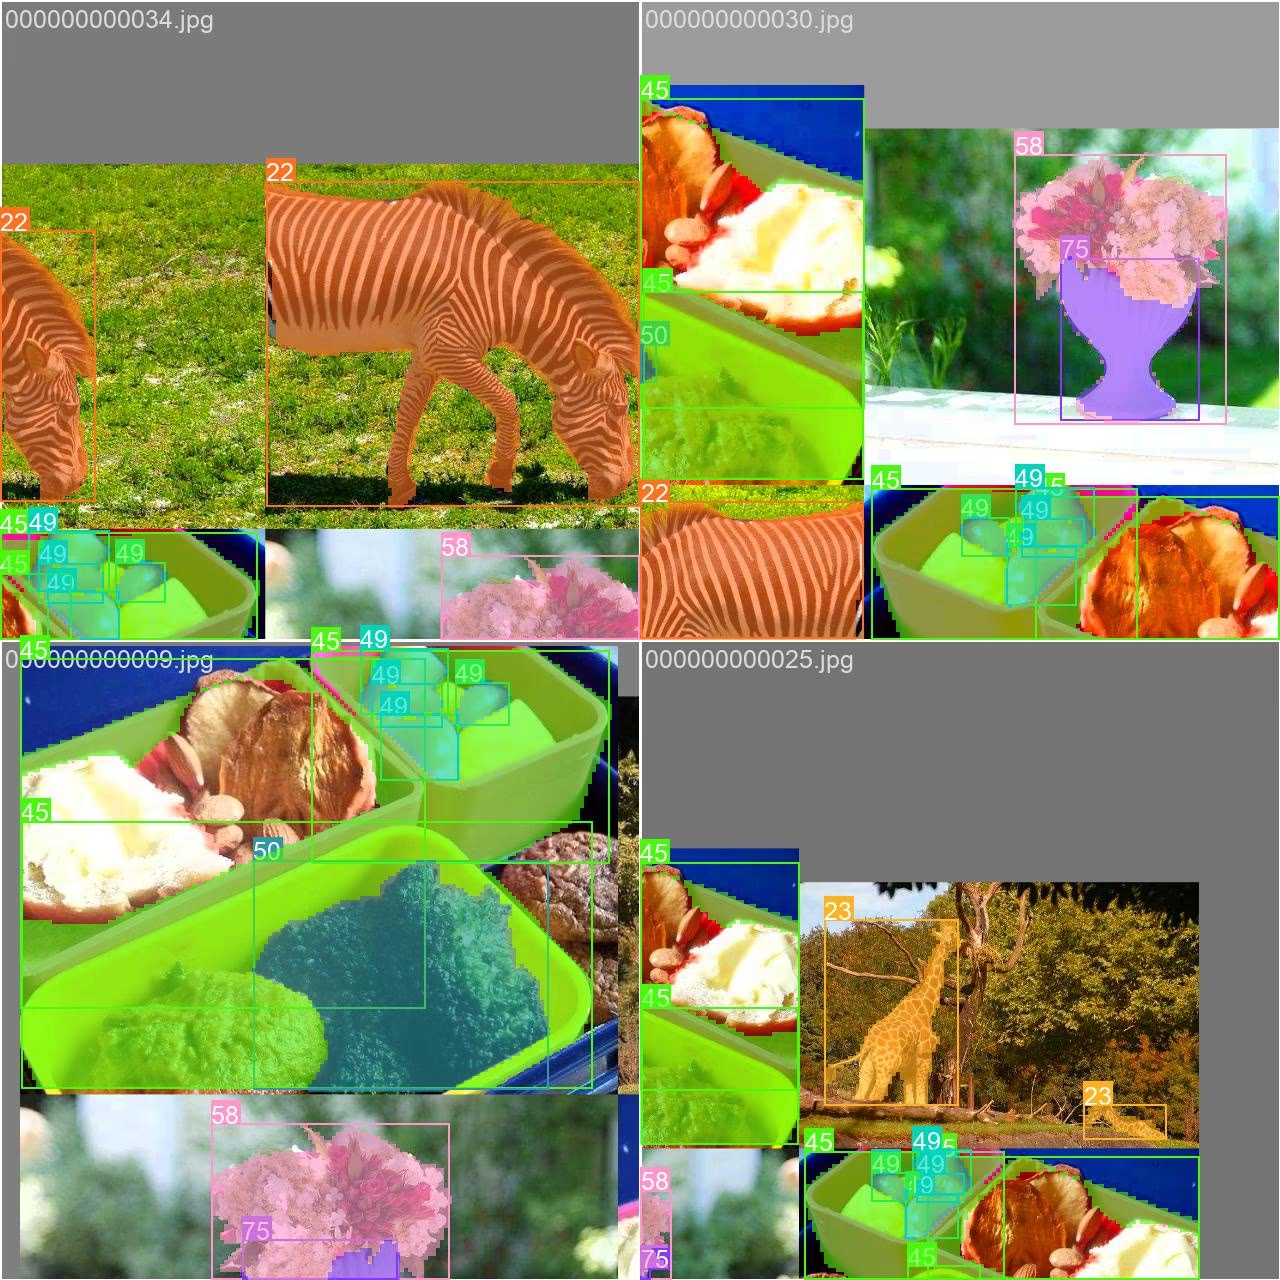
L'entraînement suit le processus de détection, avec un modèle -seg et un jeu de données de segmentation. Une époque avec imgsz=320 sur le CPU d'un ordinateur portable ne prend que quelques secondes, ce qui suffit pour valider l'ensemble du pipeline :
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377Avec quatre images de validation, ces chiffres ne sont pas significatifs ; l'important, c'est que l'exécution aboutisse et écrive weights/best.pt dans runs/segment/. Pour des données réelles, suis le guide de la tâche Segment et entraîne le modèle pendant tout le nombre d'époques prévu sur un GPU.
Lis côte à côte les métriques des boîtes et des masques#
Le tableau de validation comporte deux blocs. Box évalue chaque boîte prédite par rapport à la boîte déduite de l'annotation ; Mask compare les pixels prédits au polygone annoté. Les deux utilisent le même mécanisme de mAP ; seul l'IoU change.
La mAP50-95 des masques est presque toujours inférieure à celle des boîtes, car l'IoU des pixels est plus stricte : une boîte décalée de quelques pixels se chevauche encore largement, tandis qu'un masque qui omet un bras ou déborde sur la route perd rapidement de l'IoU aux seuils de 0,75–0,95. La ligne horse illustre ce phénomène à l'extrême : mAP50-95 des boîtes de 0.564, contre 0.199 pour les masques. Le modèle a détecté les deux chevaux et a bien encadré leurs boîtes ; il n'a pas tracé leurs pattes ni leurs queues. Utilise l'écart pour décider quoi corriger :
- Les deux sont faibles : le problème concerne la détection des objets, pas leur contour. Commence par ajouter des données correspondant aux cas manqués.
- La boîte est bonne, mais le masque est bien moins bon : le modèle détecte les objets, mais dessine mal leurs contours. Vérifie les annotations, essaie un modèle plus grand ou entraîne et valide avec une valeur
imgszsupérieure. - Le masque s'améliore alors que la boîte stagne : c'est normal ; pour un produit de segmentation, la mAP50-95 des masques est le critère de mise en production.
overlap_mask=True fusionne les masques d'instances dans une seule image pendant l'entraînement, et mask_ratio=4 réduit la résolution des masques d'entraînement. Aucun des deux ne modifie la résolution des masques prédits — ce réglage est retina_masks, dans la leçon suivante. Conserve les valeurs par défaut des deux paramètres, sauf si des mesures justifient leur modification.
Afficher la solution
Pour vérifier chaque partition, remplace le dossier de la boucle par Path(data["path"], "labels").rglob("*.txt"). Entraîne ensuite le modèle :
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}")   # 0.377 in our run
Un écart de 0.1 est attendu : l'IoU des masques pénalise chaque pixel du contour, tandis que l'IoU des boîtes ne pénalise que leurs quatre bords. Lors de notre exécution, horse est la classe présentant le plus grand écart (boîtes : 0.564, masques : 0.199). La mAP des boîtes est bonne, mais celle des masques est bien plus faible ; l'arbre de décision indique donc que la qualité des contours est en cause : vérifie d'abord ces polygones, puis essaie un modèle plus grand ou une valeur imgsz supérieure.