Entraîner un classificateur d’images
Organise un jeu de données dans des dossiers, entraîne yolo26n-cls.pt sur MNIST160, lis les probabilités et la précision top-1, puis envoie les prédictions à faible confiance à une personne pour vérification.
La classification d’images répond à une question par image : qu’est-ce que c’est ? Elle nécessite les annotations les moins coûteuses de toutes les tâches — un nom de dossier — et s’exécute le plus rapidement, ce qui en fait le deuxième étage par défaut après un détecteur et le premier modèle à choisir pour un poste d’inspection qui voit une pièce par image. Son jeu de données ne comporte pas de fichier YAML : la structure des dossiers fait donc office de contrat. Un classificateur donne toujours une réponse, même pour des images qui ne ressemblent à rien de ce qu’il a déjà vu. Savoir quand ne pas lui faire confiance représente la moitié du travail.
Pratique
Structure des dossiers du jeu de données#
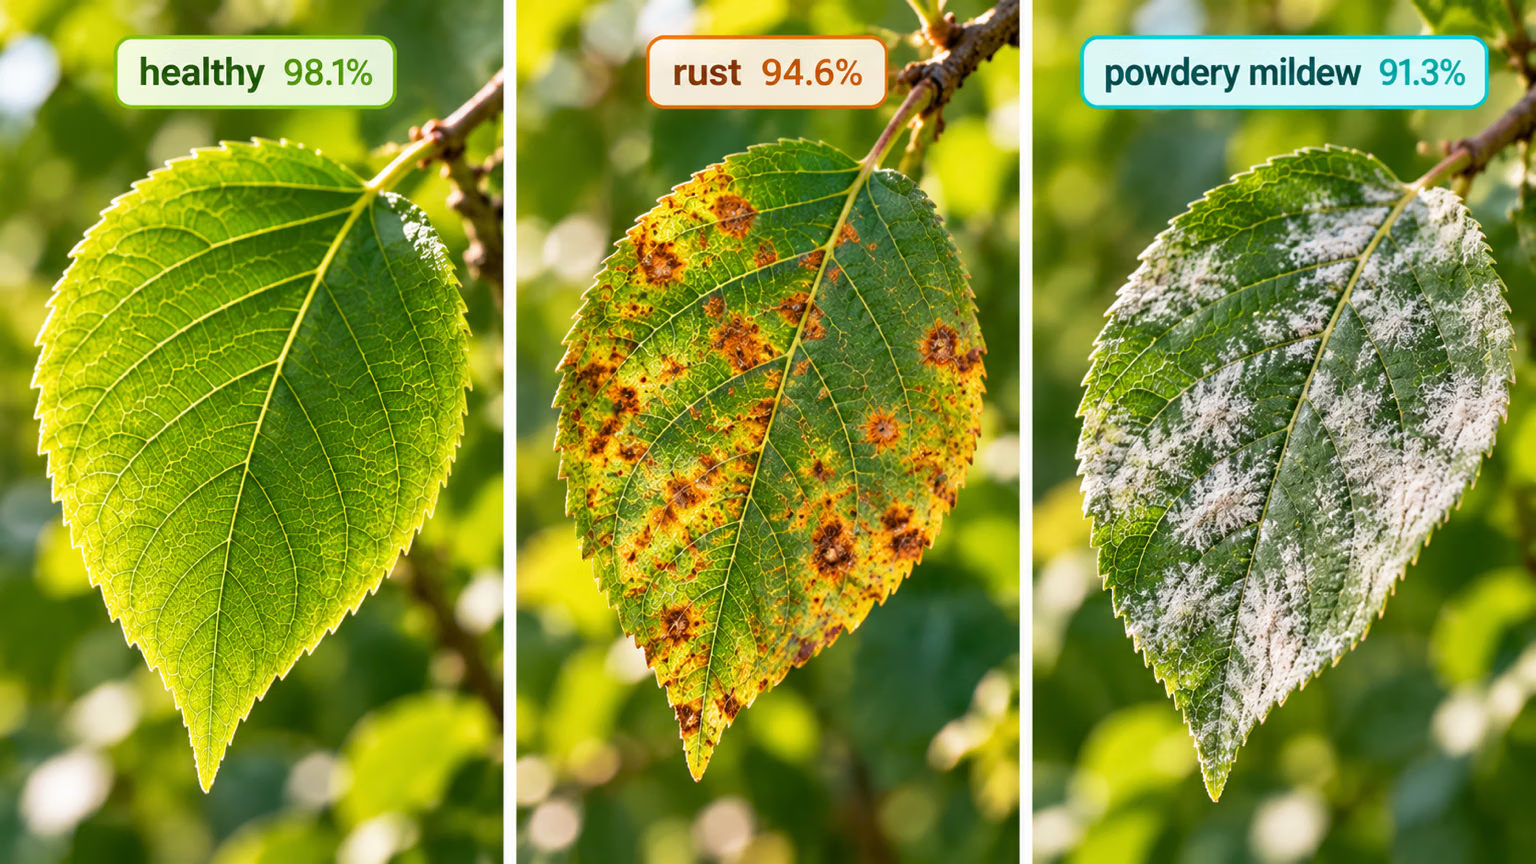
Les jeux de données de classification sont des répertoires, pas des fichiers YAML. Indique le dossier racine à data= :
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Voici ce que le chargeur en fait, d’après le code source installé et le guide des jeux de données de classification :
| Situation | Comportement |
|---|---|
| Indices de classe | noms des dossiers sous train/, triés par ordre alphabétique → dent=0, good=1, scratch=2 |
| Dossier de validation | val/, puis validation/, puis valid/ ; utilise test/ en dernier recours, avec un avertissement |
Pas de dossier train/, seulement des dossiers de classes | effectue automatiquement une division 80/20 en train/ et val/ |
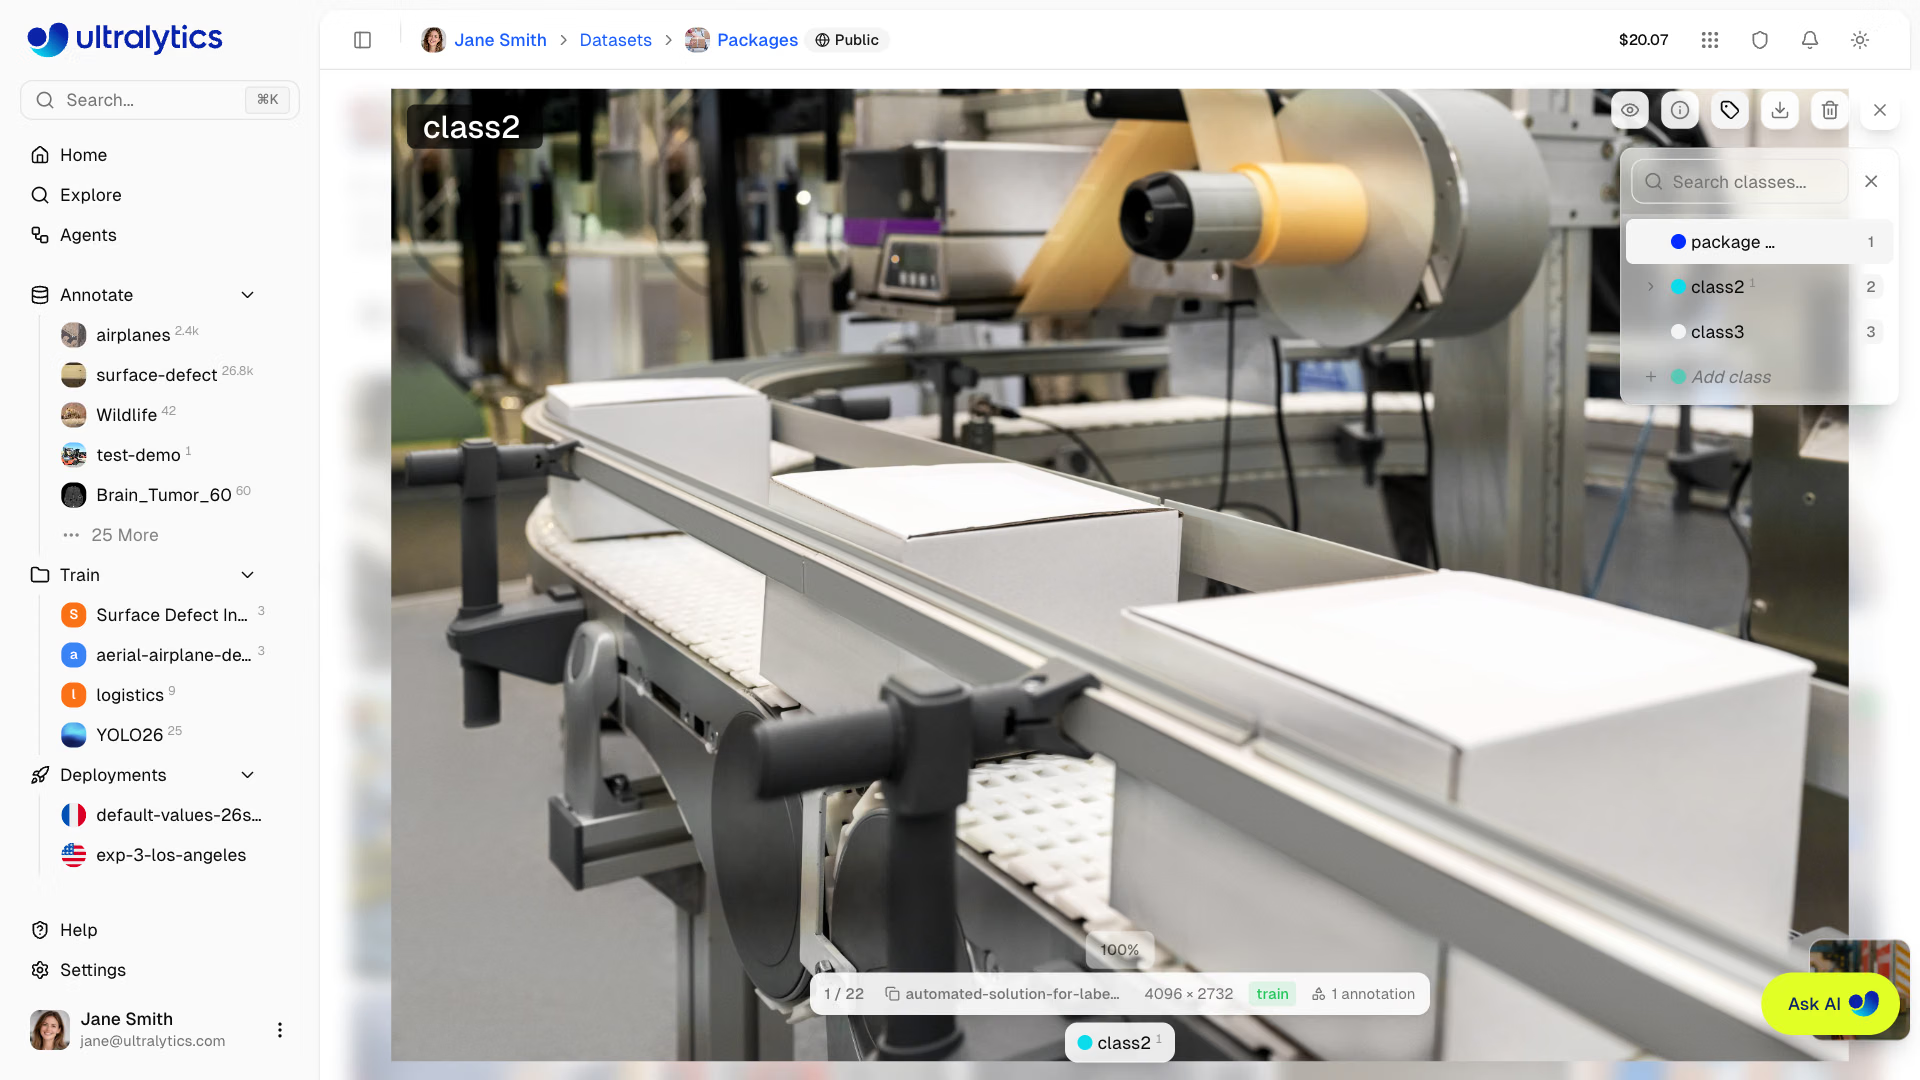
Sur la plateforme Ultralytics, un jeu de données de classification associe une seule étiquette au niveau de l’image à chaque image, au lieu de formes :
Symptôme : après l'ajout d'une classe, une ancienne intégration signale que les éléments good sont des éléments dent. Cause : l'ajout d'un dossier nommé bent le place en premier dans le tri et décale tous les index suivants. Solution : associe toujours les index aux noms avec model.names (ou result.names) ; ne code jamais un index en dur.
Entraîner sur MNIST160#
MNIST160 contient 160 chiffres manuscrits, 80 dans train/ et 80 dans test/, chacun réparti dans dix dossiers de chiffres — un jeu suffisamment petit pour un test rapide sur CPU. Il ne comporte pas de dossier val/ ; observe donc l’avertissement du chargeur et son recours à test/ :
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Une époque suffit à peine à faire progresser la nouvelle tête à dix classes. Lors de notre exécution, epochs=10 a atteint une précision top-1 de 0,55 et une précision top-5 de 0,95 en une dizaine de secondes sur le CPU d’un ordinateur portable — la boucle fonctionne, mais il faut davantage d’entraînement. Le guide de la tâche de classification répertorie les tailles des modèles préentraînés.
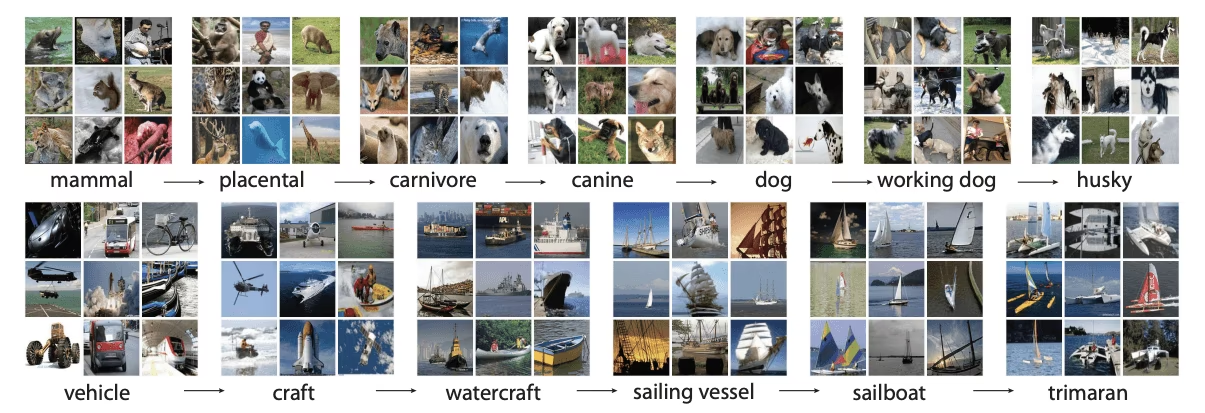
Top-1 correspond à la proportion d’images dont la classe la plus probable est correcte. Top-5 compte une prédiction comme correcte si la bonne classe figure parmi les cinq plus probables. La précision top-5 est utile pour les 1 000 classes d’ImageNet, qui vont de catégories générales à des catégories très précises ; avec cinq classes ou moins, elle vaut toujours 1,0 et, avec dix classes, elle est généreuse. Évalue le modèle sur la précision top-1 et une matrice de confusion par classe.
Lire les probabilités dans le code#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 est un indice, probs.top5 une liste d’indices et probs.data le vecteur complet des probabilités. Remarque le score de confiance top-1 : 0,52 dépasse à peine un pile ou face entre minibus et police_van. C’est sur ce nombre que tu règles l’orientation des prédictions.
Envoyer les prédictions incertaines à une personne#
En production, un classificateur n’a généralement pas besoin d’avoir raison pour chaque image ; il doit avoir raison pour les images qu’il traite seul. Ce script entraîne le modèle pendant 10 époques, puis mesure l’effet de différents seuils de confiance sur les 80 chiffres mis de côté :
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Chaque ligne représente un compromis : augmenter le seuil améliore la précision des prédictions acceptées et envoie davantage d’images à une personne. À 0,6, ce modèle ne traite seul que 10 chiffres sur 80 — il n’est pas prêt à automatiser quoi que ce soit ; la solution consiste à l’entraîner davantage, pas à choisir un seuil plus astucieux. Réexécute le même tableau après chaque cycle d’entraînement : il t’indique à la fois la précision obtenue et le volume exact de vérifications que génère chaque seuil.
Choisis le seuil le plus bas dont la précision sur les images acceptées répond à tes exigences, mesurée sur des données mises de côté. Vérifie ensuite que le volume de révisions généré est gérable par ton équipe ; sinon, améliore le modèle.
Pièges#
Symptôme : une station vide, une pièce incorrecte ou une main devant l'objectif reçoit une étiquette de classe avec une forte confiance. Cause : les probabilités softmax totalisent toujours 1, donc le classificateur choisit toujours l'une de ses classes. Solution : ajoute un dossier other/ contenant précisément ces images, puis envoie les prédictions top1conf faibles en révision.
Symptôme : un modèle préentraîné obtient un score proche de zéro sur ton jeu de données avant tout entraînement. Cause : yolo26n-cls.pt prédit 1 000 index ImageNet, et tes dossiers réutilisent les index 0–9 avec des significations différentes : sur MNIST160, le dossier 0 correspond à l'index 0, auquel la tête préentraînée associe tench. Nous avons mesuré une précision top-1 de 0.000 de cette façon. Solution : commence par affiner le modèle, puis valide-le.
Symptôme : une précision top-1 proche de 1.0 en validation, mais bien plus faible en production. Cause : des photos quasi identiques de la même pièce se trouvent dans train/ et val/. Solution : répartis les données par pièce ou par session, comme dans Répartir correctement le jeu de données.
Les classificateurs sont préentraînés à imgsz=224, et non à 640. Pour les petits objets dans une grande image, mieux vaut détecter puis classifier (leçon suivante) qu’utiliser un modèle imgsz plus grand.
Afficher la solution
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Nos résultats : 1 époque → top-1 0,162, top-5 0,463 ; 10 époques → top-1 0,550, top-5 0,950. Avec cinq classes, la bonne réponse figure toujours parmi les cinq premières ; la précision top-5 vaut donc 1,0 par construction et ne t’apprend rien.
Pour atteindre une précision de 75 % sur les images acceptées, route.py indique un seuil de 0,6 (80 % pour 10 images acceptées), ce qui envoie 70 des 80 chiffres en vérification. Voilà la réponse honnête : le seuil respecte l’exigence de précision, mais le modèle n’est pas encore utile. Entraîne-le plus longtemps et réexécute le tableau avant de choisir un seuil pour la production.