Évaluer et déployer chaque tâche
Définis un seuil pour chaque tâche à l’aide de sa propre métrique et de la taille de déploiement, valide toutes les tâches dans une seule boucle et exporte chaque modèle vers ONNX avec une prédiction vérifiée.
Chaque tâche a sa propre définition de la réussite : chevauchement des pixels, similarité des points clés, IoU des boîtes orientées, prédiction top-1 correcte ou rapport de profondeur. Les équipes qui réutilisent leur liste de vérification de détection déploient des modèles de segmentation évalués selon la mAP des boîtes et des modèles de pose évalués selon des boîtes qui ne correspondent jamais au produit. Même un modèle qui franchit son seuil peut échouer après l’export : dans cette leçon, les mêmes poids de pose détectent 5 personnes à une taille d’entrée et 3 à une autre, tandis que les distances du modèle de profondeur doublent presque.
Pratique
Un seuil par tâche#
| Tâche | Évaluer selon | Clé results_dict | Attribut Python | Évalué par |
|---|---|---|---|---|
| segmentation | mAP50-95 des masques | metrics/mAP50-95(M) | metrics.seg.map | IoU des pixels par instance |
| sémantique | mIoU (+ IoU par classe) | metrics/mIoU | metrics.miou | IoU des pixels par classe |
| pose | mAP50-95 de pose | metrics/mAP50-95(P) | metrics.pose.map | OKS |
| obb | mAP50-95 OBB | metrics/mAP50-95(B) | metrics.box.map | IoU des boîtes orientées |
| classification | précision top-1 | metrics/accuracy_top1 | metrics.top1 | classe top-1 correcte |
| profondeur | δ1 (+ AbsRel) | metrics/delta1 | metrics.delta1 | proportion de pixels dont la profondeur est à moins d’un facteur 1,25 de la profondeur réelle |
Le guide des métriques de performance explique chaque score. Les exécutions de segmentation et de pose rapportent aussi des métriques de boîte ; conserve-les comme outil de diagnostic — un écart entre la boîte et le masque indique un problème de qualité du contour — mais elles ne représentent pas le produit. Les méthodes d’analyse propres à la détection, comme les balayages de seuils et la matrice de confusion, restent applicables après Validation et diagnostic.
Valider toutes les tâches dans une seule boucle#
Le mode Val accepte les poids de n’importe quelle tâche avec le jeu de données correspondant ; une seule boucle produit donc les valeurs du tableau de mise en production :
from ultralytics import YOLO

runs = {
    "yolo26n-seg.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)"),
    "yolo26n-sem.pt": ("cityscapes8.yaml", "metrics/mIoU"),
    "yolo26n-pose.pt": ("coco8-pose.yaml", "metrics/mAP50-95(P)"),
    "yolo26n-obb.pt": ("dota8.yaml", "metrics/mAP50-95(B)"),
    "yolo26n-depth.pt": ("depth8.yaml", "metrics/delta1"),
}
for weights, (data, key) in runs.items():
    metrics = YOLO(weights).val(data=data, device="cpu", plots=False, verbose=False)
    print(f"{weights:17s} {key:22s} {metrics.results_dict[key]:.3f}")
yolo26n-seg.pt metrics/mAP50-95(M) 0.538
yolo26n-sem.pt metrics/mIoU 0.610
yolo26n-pose.pt metrics/mAP50-95(P) 0.419
yolo26n-obb.pt metrics/mAP50-95(B) 0.857
yolo26n-depth.pt metrics/delta1 0.377Sans imgsz explicite, chaque modèle est validé à la taille utilisée pour son entraînement : 640 pour la segmentation et la pose, 768 pour la profondeur, 1024 pour la segmentation sémantique et les OBB. Ces valeurs préentraînées sont supérieures à celles des entraînements à 320 pixels réalisés plus tôt dans le cours — en partie grâce à l’entraînement, en partie grâce à la résolution. Quatre images de validation font de chaque valeur un simple test de bon fonctionnement ; par exemple, la page de la tâche de profondeur présente δ1 sur l’ensemble du benchmark NYU. La classification est volontairement exclue : valide ton classificateur affiné sur ses propres dossiers, comme dans la leçon sur la classification.
Les mêmes poids obtiennent des scores différents selon imgsz. Consigne imgsz à côté de chaque valeur, valide à la taille prévue pour le déploiement et ne compare jamais des valeurs mesurées à des tailles différentes.
Exporter chaque tâche#
Chaque tâche s’exporte vers ONNX avec le même appel au mode Export. La tâche est stockée dans les métadonnées du modèle, donc YOLO("model.onnx") applique le post-traitement approprié. Le choix du moteur d’exécution, les vérifications de parité et l’optimisation pour TensorRT ou OpenVINO sont abordés dans Exporter vers ONNX (et vérifier la parité) ; cette boucle vérifie que chaque tâche résiste à l’aller-retour :
from ultralytics import YOLO

for weights in ["yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]:
    onnx_path = YOLO(weights).export(format="onnx", imgsz=320)
    onnx_model = YOLO(onnx_path)  # task comes from the ONNX metadata
    result = onnx_model("https://ultralytics.com/images/bus.jpg", imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:9s} {result.verbose()}")
segment 4 persons, 1 bus,
semantic
pose 3 persons,
obb (no detections),
classify minibus 0.38, police_van 0.21, trolleybus 0.05, amphibian 0.05, bullet_train 0.03,
depth depth 4.67-26.91m,Chaque export s’est rechargé avec la bonne tâche. Trois résultats méritent un examen plus attentif :
- La pose a détecté 3 personnes à 320 pixels, alors que l’exécution PyTorch à 640 pixels en détectait 5.
- La profondeur a interprété la scène comme s’étendant de 4,7 à 26,9 m, alors qu’avec les mêmes poids à leur résolution native de 768 pixels, elle indiquait de 2,1 à 14,9 m.
- Les OBB n’ont rien détecté sur une photo de rue — un comportement correct pour un modèle aérien, et non un bogue d’export.
PyTorch avec imgsz=320 donne les mêmes valeurs de pose et de profondeur qu’ONNX ; aucun des deux n’est donc un bogue d’export : c’est la taille d’entrée qui a modifié le résultat. Exporte à la taille imgsz que tu as validée. Les résultats sémantiques n’ont pas de ligne récapitulative par objet ; vérifie donc plutôt result.semantic_mask.
Effectue une prédiction avec chaque modèle exporté sur une image similaire à celles utilisées pour son entraînement — scènes de rue pour les modèles COCO, tuiles aériennes pour OBB, scènes intérieures ou de rue à la bonne échelle pour la profondeur — avant de déclarer un export défectueux ou de le déployer.
Si tu écris ton propre post-traitement, voici les sorties ONNX brutes à imgsz=320, tirées du journal d’export :
| Tâche | Forme(s) des sorties ONNX | Contenu |
|---|---|---|
| segmentation | (1, 116, 2100) et (1, 32, 80, 80) | boîtes + 80 scores de classe + 32 coefficients de masque ; prototypes de masque |
| sémantique | (1, 320, 320) | carte de classes, argmax déjà calculé dans le graphe |
| pose | (1, 56, 2100) | boîtes + 1 score + 17 × 3 valeurs de points clés |
| obb | (1, 20, 2100) | boîtes + 15 scores de classe + 1 angle |
| classification | (1, 1000) | probabilités des classes |
| profondeur | (1, 1, 320, 320) | profondeur en mètres par pixel |
Sur Ultralytics Platform, la page du modèle affiche les métriques propres à la tâche (la mAP des masques pour un modèle de segmentation), au-dessus d’un onglet Export qui propose les mêmes formats :

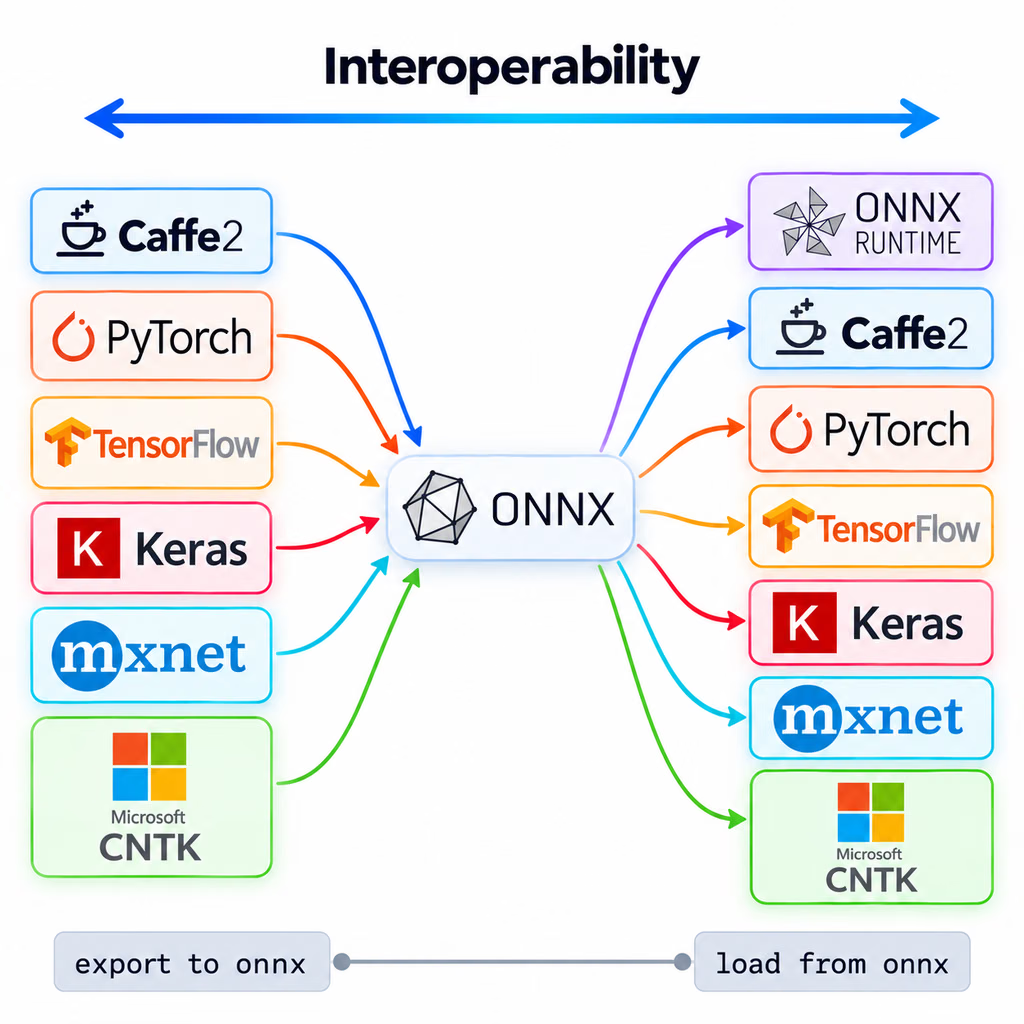
ONNX est le format d’échange : un même fichier exporté s’exécute dans ONNX Runtime ou se convertit vers d’autres moteurs d’exécution.
Liste de vérification avant déploiement#
- La métrique de validation du tableau ci-dessus atteint son objectif sur un ensemble de données réservé, à la taille de déploiement
imgsz. - Le modèle exporté se recharge avec
taskattendu et correspond aux prédictions PyTorch sur un ensemble d’images fixe. - Les chemins de code propres à chaque tâche gèrent les résultats vides :
masks is None, zéro point clé, zéro OBB. - Les valeurs calculées en aval (surfaces, angles, distances, probabilités des classes) sont consignées pour que tu puisses surveiller leur dérive, comme indiqué dans Observabilité et dérive.
Lorsque le seuil n’est pas atteint, « revenir aux données » signifie généralement agir sur l’un de ces trois leviers :
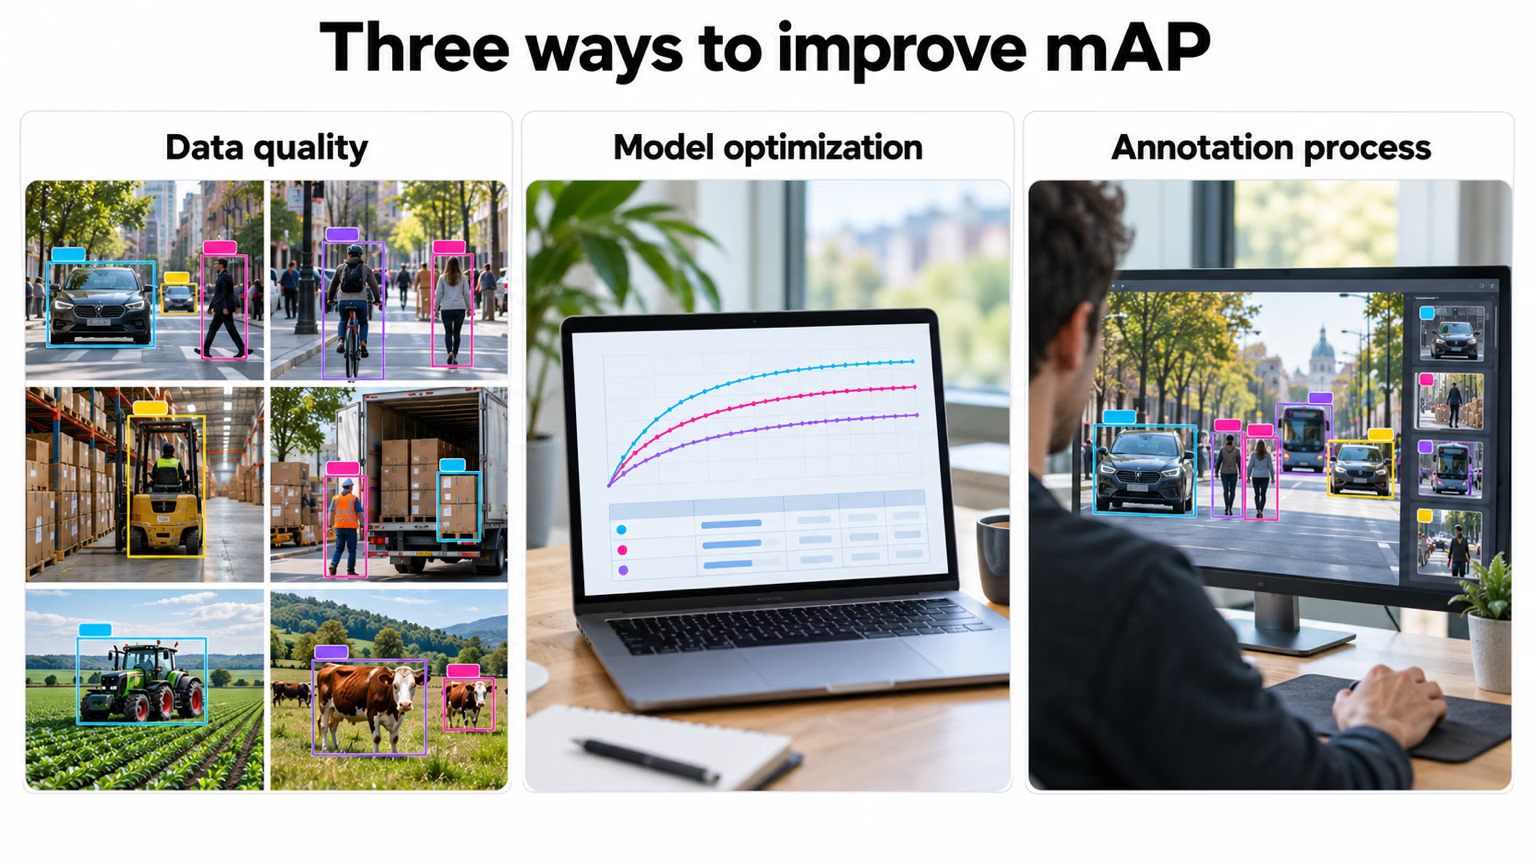
Commence par corriger la qualité des données et le processus d’annotation — les vérifications des étiquettes des leçons 2 et 6 sont le point de départ le moins coûteux — et ne modifie le modèle que lorsque les données sont propres.
Afficher la solution
from ultralytics import YOLO

checks = {
    "runs/segment/train/weights/best.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)", "https://ultralytics.com/images/bus.jpg"),
    "runs/obb/train/weights/best.pt": ("dota8.yaml", "metrics/mAP50-95(B)", "https://ultralytics.com/images/boats.jpg"),
}
for weights, (data, key, image) in checks.items():
    model = YOLO(weights)
    gate = model.val(data=data, imgsz=320, plots=False, verbose=False).results_dict[key]
    onnx_model = YOLO(model.export(format="onnx", imgsz=320))
    result = onnx_model(image, imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:8s} {key} @320 = {gate:.3f} | ONNX: {result.verbose()}")
Adapte les chemins runs/... aux dossiers affichés par tes exécutions d’entraînement (Results saved to ...). Avec les entraînements d’une époque des leçons 2 et 7 :
segment  metrics/mAP50-95(M) @320 = 0.377 | ONNX: 4 persons, 1 bus,
obb metrics/mAP50-95(B) @320 = 0.832 | ONNX: 185 ships, 3 harbors,| Modèle | Métrique de validation | Valeur | taille d’image | ONNX |
|---|---|---|---|---|
| segmentation | mAP50-95 des masques | 0.377 | 320 | se recharge en tant que segment, détecte le bus et 4 personnes |
| obb | mAP50-95 OBB | 0.832 | 320 | se recharge en tant que obb, détecte 185 navires et 3 ports |
Chaque vérification utilise une image de son propre domaine : le modèle OBB reçoit la photo aérienne du port, pas la scène de rue. Les deux lignes réussissent la vérification de l’export ; aucun des deux modèles n’est prêt à être déployé, car une époque d’entraînement et quatre images de validation constituent un test de bon fonctionnement, pas un seuil de validation.