Segmentation sémantique : étiqueter chaque pixel
Prédire une carte de classes par pixel avec yolo26n-sem.pt, la convertir en valeurs de couverture, créer des jeux de données de cartes de classes PNG et interpréter la mIoU sans se laisser induire en erreur par la précision au pixel.
Certaines questions ne concernent aucun objet à compter : quelle part du trottoir est bloquée, quelle part d’un champ est envahie par les mauvaises herbes, où se termine la chaussée praticable. La segmentation sémantique y répond en attribuant un ID de classe à chaque pixel. Sa métrique principale peut toutefois être mal interprétée : le modèle entraîné dans cette leçon obtient une précision au pixel de 91 % sans jamais détecter une seule personne.
Pratique
Instance ou sémantique ?#
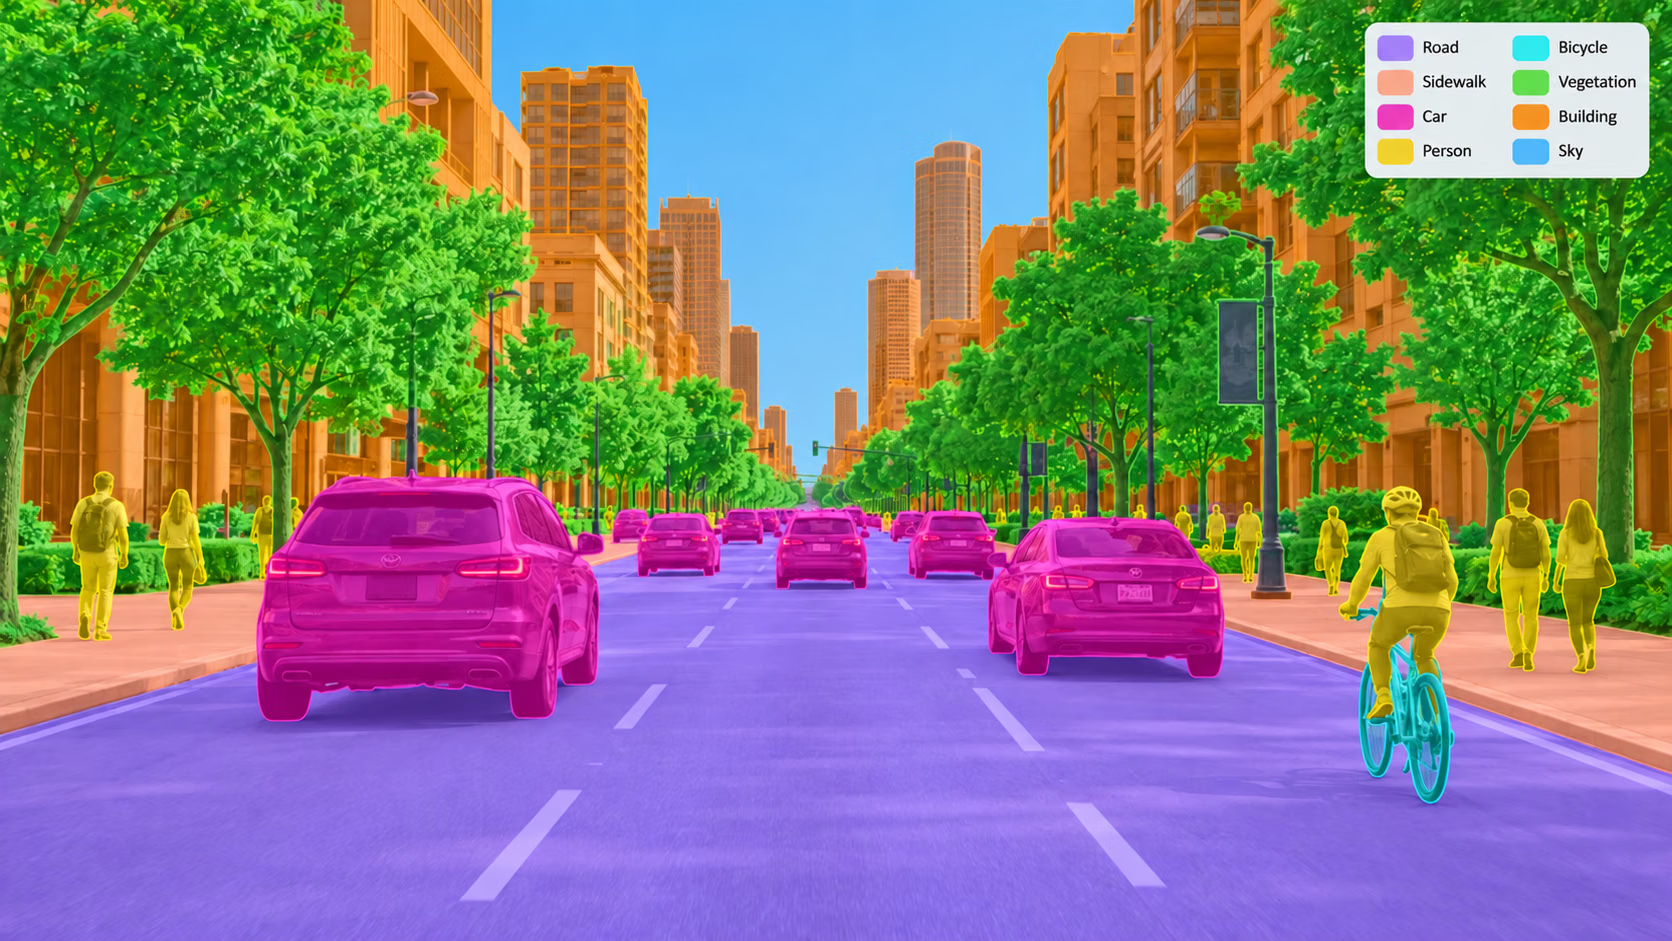
Segmentation d’instance (segment) | Segmentation sémantique (semantic) | |
|---|---|---|
| Sortie | un masque par objet, plus une boîte | un ID de classe par pixel |
| Compte les objets | oui | non — deux voitures qui se touchent forment une seule région « voiture » |
| Gère les « matières » (route, ciel, herbe) | mal — pas d’instances naturelles | oui |
| Étiquettes | polygones | cartes de classes PNG ou polygones |
| Métrique de validation | mAP50-95 des masques | mIoU |
| Poids préentraînés | yolo26n-seg.pt (COCO, 80 classes) | yolo26n-sem.pt (Cityscapes, 19 classes) |
Si la question en aval porte sur « combien », utilise la segmentation d'instances. Si elle porte sur « quelle quantité » ou « où », la segmentation sémantique est plus simple à étiqueter et à interpréter. La page consacrée à la tâche de segmentation sémantique contient le tableau des modèles.
Prédire une carte de classes#
result.semantic_mask.data est un tenseur H × W à la taille d’origine de l’image ; chaque valeur est un ID de classe et 255 signifie « ignorer ». result.summary() le convertit en ratios de pixels par classe :
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Regarde la dernière ligne. Cityscapes possède une classe bus, mais le modèle classe le bus comme train. Il a appris à partir d’images filmées depuis des voitures, principalement dans des rues allemandes ; un bus photographié de près depuis le trottoir ne correspond pas à cette distribution. Les modèles sémantiques héritent du point de vue et des définitions de classes de leur jeu d’entraînement — son biais de jeu de données — plus strictement que les détecteurs. Affine donc le modèle avec les images de ta propre caméra avant de te fier à la carte.
Transformer la carte de classes en réponse#
Une carte de classes permet d’obtenir une valeur utile au produit avec de simples comparaisons de tenseurs. Voici la question : « quelle part de la surface où un piéton pourrait marcher est constituée de route ou de trottoir, et quelle part est occupée par des personnes ? »
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personTrois habitudes rendent ces valeurs fiables :
- Récupère les IDs par nom depuis
result.names, jamais à partir d’un nombre codé en dur ; un modèle entraîné sur tes propres classes leur attribuera des numéros différents. - Limite-toi à la région qui compte. Les ratios calculés sur toute l’image incluent le ciel et les bâtiments ; découpe d’abord la carte de classes (ou multiplie-la par un masque de région).
- Affiche la superposition.
semantic_overlay.jpgte permet de vérifier en un coup d’œil si la « route » comptabilisée est vraiment une route.
Le format du jeu de données#
Les jeux de données sémantiques associent chaque image à une image masque à un seul canal, dont les valeurs des pixels sont des IDs de classe. Le guide des jeux de données sémantiques est la référence ; la structure reproduit celle de images/, fichier par fichier :
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
Le YAML ajoute masks_dir et, si les IDs enregistrés dans tes masques diffèrent des IDs utilisés pour l’entraînement, un bloc label_mapping :
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Les masques Cityscapes stockent les IDs d’étiquette bruts, de -1 à 33 ; la correspondance en conserve 19 et attribue les autres à ignore_label, enregistré sous la valeur 255. Les pixels à 255 sont exclus de la fonction de perte et des métriques — utilise la même valeur pour les régions sur lesquelles tes annotateurs n’ont pas pu se mettre d’accord.
Si tu as déjà des étiquettes polygonales mais pas de masks_dir, le chargeur rasterise les polygones pour toi et ajoute une classe background pour les pixels non couverts.
La compression avec perte mélange les valeurs des pixels voisins, transformant la frontière entre la classe 7 et la classe 8 en un mélange de 7, de 8 et d'identifiants inexistants. Enregistre chaque masque au format PNG ou TIFF.
Entraîner le modèle et interpréter la mIoU#
Cityscapes8 contient 8 images de scènes urbaines, 4 pour l’entraînement et 4 pour la validation, ce qui suffit pour un test rapide sur CPU :
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Lignes par classe abrégées.) La précision au pixel indique 91 % ; la mIoU, 42 % ; les lignes par classe montrent que le modèle n’a détecté aucune personne. Ces trois résultats sont vrais. La route, les bâtiments et la végétation occupent la majorité des pixels — la route à elle seule en compte 78,529 sur 192,315 — ; un modèle qui les classe correctement obtient donc une précision au pixel élevée tout en manquant toutes les petites classes. La mIoU calcule la moyenne des IoU par classe avec une pondération égale, donc chaque classe manquée la fait baisser.

Évalue le mIoU et l'IoU des classes sur lesquelles ton produit agit. Une fonctionnalité de sécurité des piétons avec un IoU de 0 pour la classe « personne » échoue, quel que soit le score de précision par pixel.
Afficher la solution
Lors de notre entraînement : mIoU 0.415, précision au pixel 0.906, et IoU égal à 0 pour les classes mur, personne, cycliste, moto et vélo, ainsi que pour toutes les classes absentes des quatre images de validation.
La précision au pixel est supérieure parce qu’elle compte les pixels, et que la route, les bâtiments, la végétation et le ciel constituent la majeure partie de chaque image Cityscapes. La mIoU accorde le même poids à chaque classe ; cinq petites classes manquées font donc baisser la moyenne, même si elles ne couvrent que quelques centaines de pixels. Pour un produit qui agit sur les personnes, ce modèle échoue au critère de validation rien qu’avec son IoU sur la classe personne.