Choisir la tâche et planifier le pipeline
Associe chaque question produit à l’une des sept tâches Ultralytics YOLO, avec ses poids, son champ de résultat, son format d’étiquettes et sa métrique de validation, puis vérifie le plan en exécutant chaque tâche sur une image.
Une fois un détecteur déployé, les demandes suivantes sont rarement « plus de boîtes ». Elles portent plutôt sur « quelle est la taille de la fuite », « le dos du travailleur est-il courbé », « dans quelle direction pointe le navire » et « cette pièce est-elle à rebuter ». Sur la photo de rue utilisée tout au long de ce cours, la boîte englobante du bus couvre 48 % de l’image alors que le bus lui-même n’en couvre que 29 % : une estimation de surface fondée sur la boîte serait donc erronée de plus de moitié. La tâche choisie détermine le format des étiquettes ; la choisir avant toute annotation est donc la décision la moins coûteuse du projet. La changer plus tard implique de refaire les annotations.
Pratique
Une photo, quatre réponses différentes#

Pose une seule question à propos d’une seule photo — quelle partie de cette image est occupée par le bus, et à quelle distance se trouve-t-il ? — et laisse quatre tâches Ultralytics YOLO y répondre :
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraExaminons chaque ligne :
- detect répond à la question où. La boîte comprend aussi la chaussée sous le bus et les quatre personnes devant lui ; elle surestime donc la surface de 63 %.
- segment répond à la question quelle forme. 29,2 % correspond à l’empreinte réelle du bus dans l’image, la valeur à utiliser pour toute règle de surface, de couverture ou de chevauchement.
- semantic répond à la question à quelle classe appartiennent les pixels. La surface est proche de celle du masque, mais le modèle classe le bus comme
train: il étiquette les surfaces avec les classes de son jeu d’entraînement (Cityscapes, leçon 4) et ne distingue jamais un véhicule d’un autre. - depth répond à la question à quelle distance. La profondeur médiane à l’intérieur du masque du bus est de 4,5 m : deux tâches combinées répondent à une question à laquelle aucune ne peut répondre seule.
Si le nombre fourni par ton produit représente une aire, une proportion de couverture ou un chevauchement, une boîte n'est pas l'outil adapté. Utilise un masque (segmentation d'instances) pour les objets ou une carte de classes (segmentation sémantique) pour les surfaces.
Les sept tâches en un coup d’œil#
Computer Vision Foundations explique en détail comment choisir entre les tâches — consulte de nouveau Les sept tâches de vision si le choix ne te semble pas évident. Voici le récapitulatif pratique pour la suite du cours. Chaque ligne correspond à une tâche que le package ultralytics installé peut entraîner, valider, utiliser pour des prédictions et exporter avec la même API ; la présentation des tâches constitue la référence complète.
| Question à laquelle la sortie répond | Tâche | Poids YOLO26 | Champ de résultat | Format des étiquettes | Métrique de validation |
|---|---|---|---|---|---|
| Où se trouve chaque objet ? | detect | yolo26n.pt | boxes | classe + boîte | mAP50-95 des boîtes |
| Quelle est la forme exacte et la surface de chaque objet ? | segment | yolo26n-seg.pt | masks + boxes | classe + polygone | mAP50-95 des masques |
| À quelle classe appartient chaque pixel ? | semantic | yolo26n-sem.pt | semantic_mask | Carte de classes PNG ou polygones | mIoU |
| Où se trouvent les articulations ou les repères ? | pose | yolo26n-pose.pt | keypoints + boxes | classe + boîte + points clés | mAP50-95 de pose (OKS) |
| Comment chaque objet est-il orienté ? | obb | yolo26n-obb.pt | obb | classe + 4 sommets | mAP50-95 OBB |
| Que représente cette image entière (ou cette zone recadrée) ? | classify | yolo26n-cls.pt | probs | un dossier par classe | précision top-1 |
| À quelle distance de la caméra se trouve chaque pixel ? | depth | yolo26n-depth.pt | depth | carte de profondeur par image (PNG 16 bits ou NPY) | δ1 (delta1) |
Tu déploies déjà la première ligne. Les leçons 2 à 8 enseignent les cinq lignes du milieu, et les leçons 9 et 10 les combinent et les déploient. La dernière ligne, l’estimation de profondeur monoculaire, prédit une distance en mètres pour chaque pixel d’une image unique. Ses étiquettes proviennent de capteurs de profondeur ou de moteurs de rendu 3D plutôt que d’annotateurs ; elle possède donc son propre format de jeu de données. Ce cours l’inclut partout où le flux de travail est commun : dans ce plan, la boucle de validation et la vérification de l’export de la dernière leçon.
Choisis une question à la fois#
Parcours les questions dans l’ordre et arrête-toi à la première réponse affirmative :
L’arbre couvre les cas courants. Quatre critères de départage couvrent la plupart des autres :
| Si la demande… | Choisis | Parce que |
|---|---|---|
| nécessite un décompte et une surface (« combien de fuites, et de quelle taille ») | segment | la segmentation sémantique fusionne les objets qui se touchent en une seule région |
| concerne des objets longs et fins, serrés les uns contre les autres et vus d’en haut | obb | les boîtes alignées sur les axes se chevauchent et NMS écarte de vrais objets, même si tu ne consultes jamais l’angle |
| nécessite de distinguer l’avant de l’arrière, ou la gauche de la droite | pose | une OBB donne un axe, pas un cap |
| ne montre par construction qu’un seul élément par image (un poste d’inspection fixe) | classify | les étiquettes les moins coûteuses et le modèle le plus rapide |
La tâche est définie à la création du jeu de données — sur Ultralytics Platform, il s’agit du champ Task Type de la boîte de dialogue New Dataset — ce choix doit donc précéder la première annotation :

Une API, sept champs de résultat#
Toutes les tâches utilisent le même appel ; le modèle déduit la tâche du fichier de poids. Ce qui change, c’est le champ du résultat qui est renseigné, et c’est ce champ que ton code va lire :
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Les résultats de segment et de pose conservent boxes, donc le code de détection que tu as déjà continue de fonctionner avec eux. Les résultats de classify, semantic et depth décrivent l’image entière et ne comportent aucun champ par objet.
Le code de détection qui parcourt result.boxes s'arrête avec TypeError: 'NoneType' object is not iterable sur un modèle OBB : result.boxes vaut None, et les détections pivotées se trouvent uniquement dans result.obb. Adapte le code de détection à OBB en lisant result.obb, au lieu d'ajouter une condition sur None et de ne récupérer aucune détection.
Quand un seul modèle ne suffit pas#
La plupart des systèmes de production qui vont au-delà de la détection suivent l’une de ces trois architectures :
- Détecter, puis classifier. Le détecteur repère de petits objets dans une grande image ; un classificateur d’images analyse chaque recadrage en pleine résolution pour fournir une prédiction fine : type de casque, catégorie de défaut, référence de produit.
- Pose et suivi. Les points clés décrivent une image ; un traqueur les transforme en une série temporelle par personne, qui permet de compter les répétitions ou de détecter les chutes.
- Segmenter, puis mesurer. Le modèle renvoie les pixels ; du code classique les convertit en surfaces, largeurs, ratios de couverture ou distances (avec la profondeur).
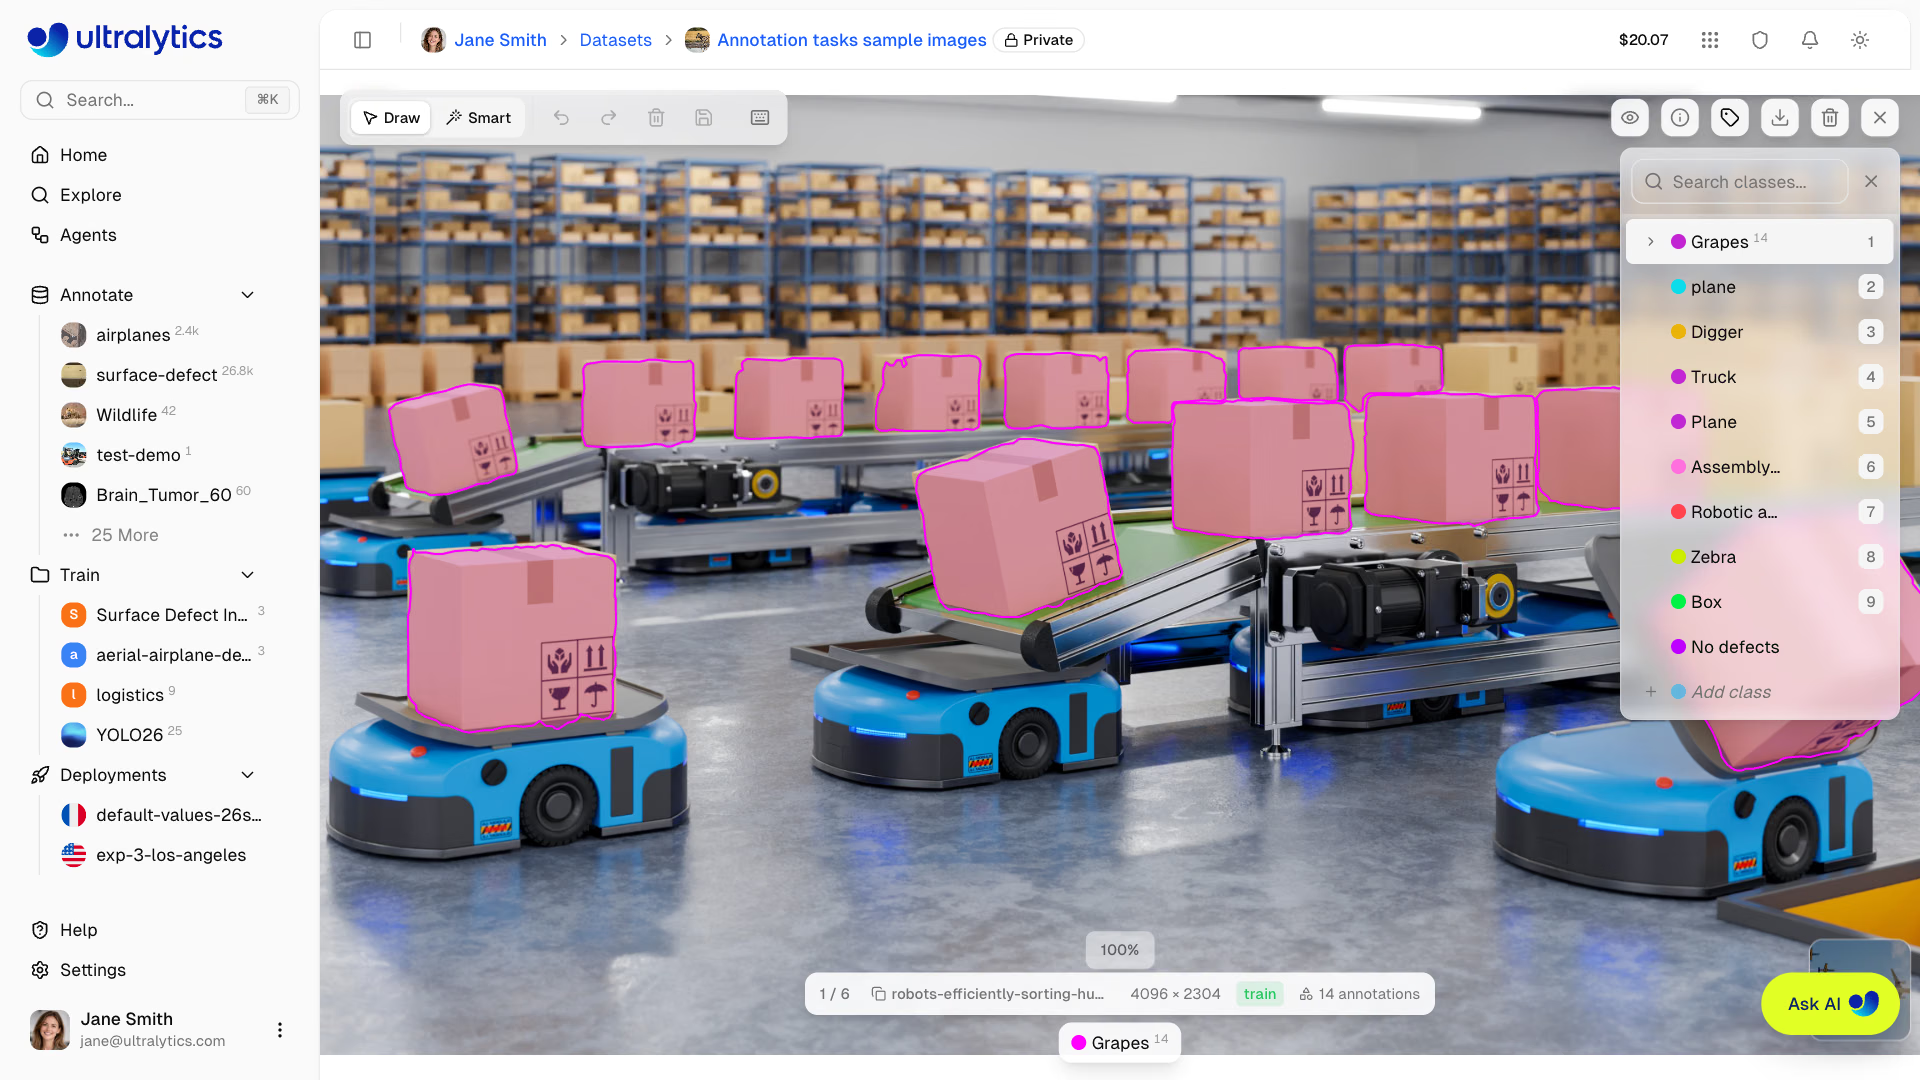
Les étiquettes d’un pipeline de segmentation suivie de mesures consistent en un polygone par objet, comme pour ces colis sur des robots d’entrepôt dans l’éditeur Ultralytics Platform :
Un deuxième modèle ajoute de la latence d'inférence, un deuxième jeu de données à étiqueter et à maintenir, ainsi qu'un deuxième modèle à surveiller. N'enchaîne les modèles que lorsqu'une seule tâche ne peut pas répondre à la question — un plan avec un seul modèle que tu peux déployer vaut mieux qu'un plan avec trois modèles que tu ne peux pas étiqueter.
Pièges#
Symptôme : l'équipe étiquette des polygones parce que les masques rendent bien en démo, alors que le produit ne fait ensuite que lire un décompte. Solution : avant l'étiquetage, identifie la ligne de code qui utilise le résultat. Si rien n'exploite le contour, déploie un détecteur : les boîtes sont plus rapides à étiqueter et à traiter.
Symptôme : après un mois d'étiquetage, quelqu'un remarque que le produit a besoin d'une orientation et que le jeu de données contient des étiquettes OBB, qui ne donnent qu'un axe. Solution : inscris l'attribut exact dans le plan (result.masks.xy, result.keypoints.xy, result.obb.xywhr) et lance tasks.py avec les poids choisis avant de créer la première étiquette.
Symptôme : un classificateur qui obtient 95 % sur des photos de produits nettes se trompe sur la plupart des recadrages du détecteur en production. Solution : crée le jeu de données de la deuxième étape à partir des recadrages générés par la première étape, avec leur flou et leur cadrage réels ; la leçon 9 explique comment faire.
Afficher la solution
Pour la demande concernant les palettes :
| Ligne | Choix |
|---|---|
| Question | Une partie quelconque d’une palette dépasse-t-elle la ligne de la poutre du rayonnage ? |
| Tâche | segment — le dépassement dépend du contour de la palette ; sa boîte couvre aussi l’espace sous la palette et la charge posée dessus |
| Poids | yolo26n-seg.pt, affiné à partir d’images des caméras de l’entrepôt |
| Format des étiquettes | Un polygone par palette |
| Champ de résultat | result.masks.data avec retina_masks=True (pixels au-delà de la ligne de la poutre) |
| Métrique de validation | mAP50-95 des masques sur une caméra exclue de l’entraînement |
| Deuxième étape | Aucun — la ligne du faisceau est fixe pour chaque caméra ; c'est donc une configuration, pas un modèle. |
La règle de surplomb tient en trois lignes de code : tracer la ligne du faisceau une fois par caméra, compter les pixels du masque du mauvais côté de cette ligne, puis déclencher une alerte au-dessus d'un seuil de pixels que tu calibres à partir de quelques surplombs connus. La leçon 3 montre exactement ce type de test entre masque et région.