Punti chiave personalizzati e metriche OKS
Progetta uno schema di punti chiave per oggetti non umani, scrivi e verifica il relativo YAML del dataset e imposta i valori sigma di OKS in base alla precisione con cui è possibile posizionare ciascun punto.
La stima della posa non riguarda solo le persone. Le punte delle forche di un carrello elevatore, gli angoli dell'etichetta di un pacco, il naso e la coda di un animale: qualsiasi oggetto con punti stabili e identificabili può diventare un dataset per la stima della posa. Lo schema che definisci il primo giorno è permanente: ogni etichetta, coppia di ribaltamento e metrica dipende da esso, e cambiarlo in seguito significa rietichettare tutto. In questa lezione definisci correttamente lo schema prima che qualcuno etichetti un migliaio di immagini e scopri esattamente come la metrica lo valuterà.
Pratico
Progetta lo schema dei punti chiave#
I punti chiave validi condividono tre proprietà: inequivocabili (due annotatori posizionano il punto nello stesso luogo), stabili (il punto è presente in ogni posa assunta dall'oggetto) e utili (un calcolo a valle li utilizza). Considera un carrello elevatore ripreso da una telecamera a soffitto, con la domanda a cui rispondere: "le forche sono sollevate mentre il carrello si muove?":
| Indice | Punto chiave | Motivo della sua presenza | Punto corrispondente speculare |
|---|---|---|---|
| 0 | left_fork_tip | estensione e direzione delle forche | 1 |
| 1 | right_fork_tip | estensione e direzione delle forche | 0 |
| 2 | mast_top | altezza delle forche rispetto al montante | 2 (se stesso) |
| 3 | mast_base | punto di riferimento sul telaio | 3 (se stesso) |
Ogni punto si giustifica contribuendo al calcolo: le punte delle forche indicano la direzione, mentre la coppia sul montante indica l'altezza. Valuta ogni punto candidato con lo stesso criterio:
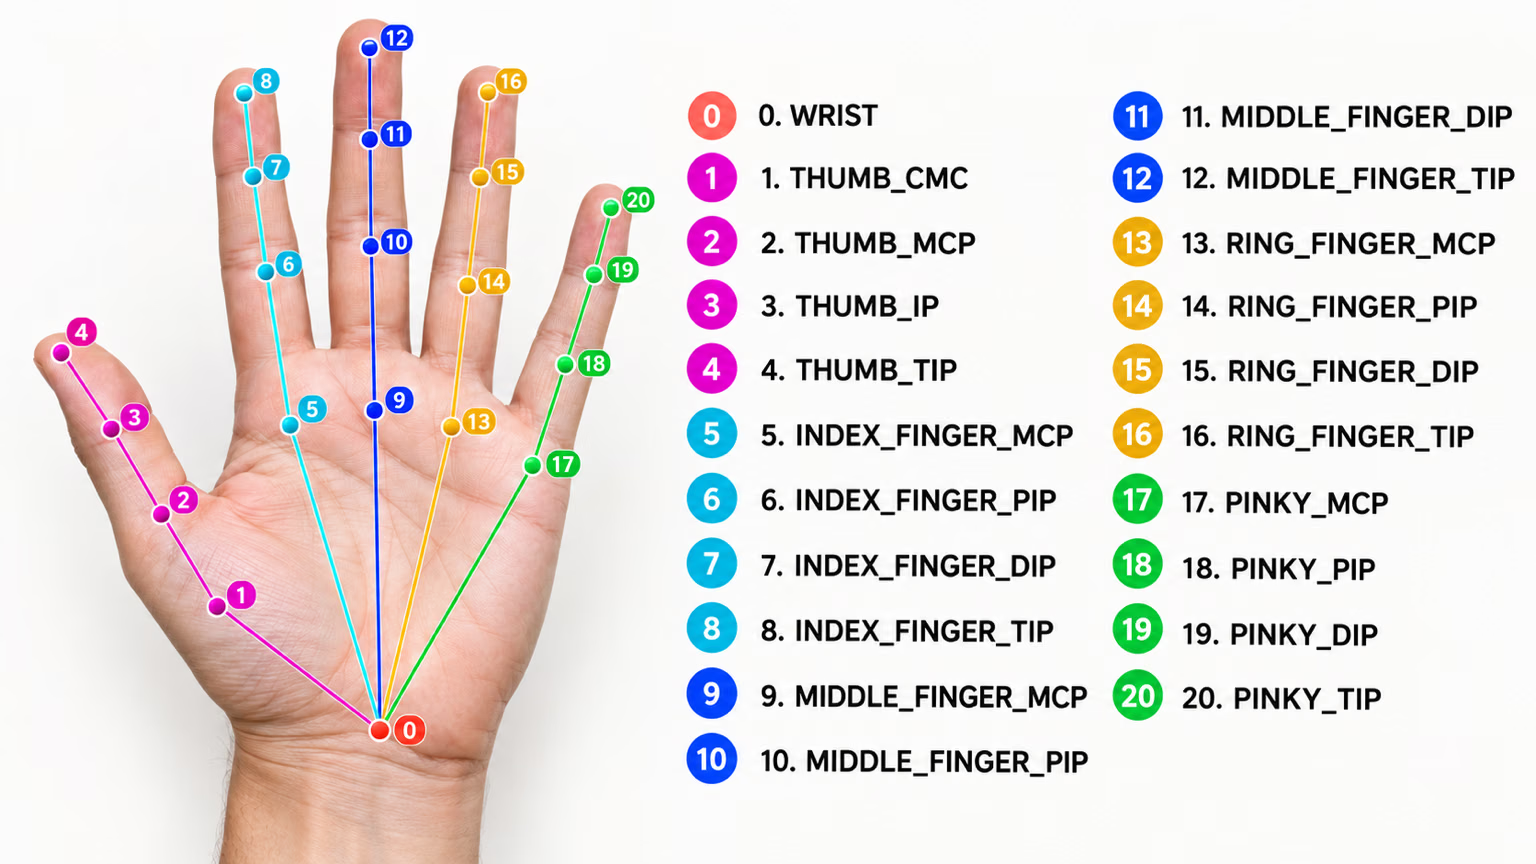
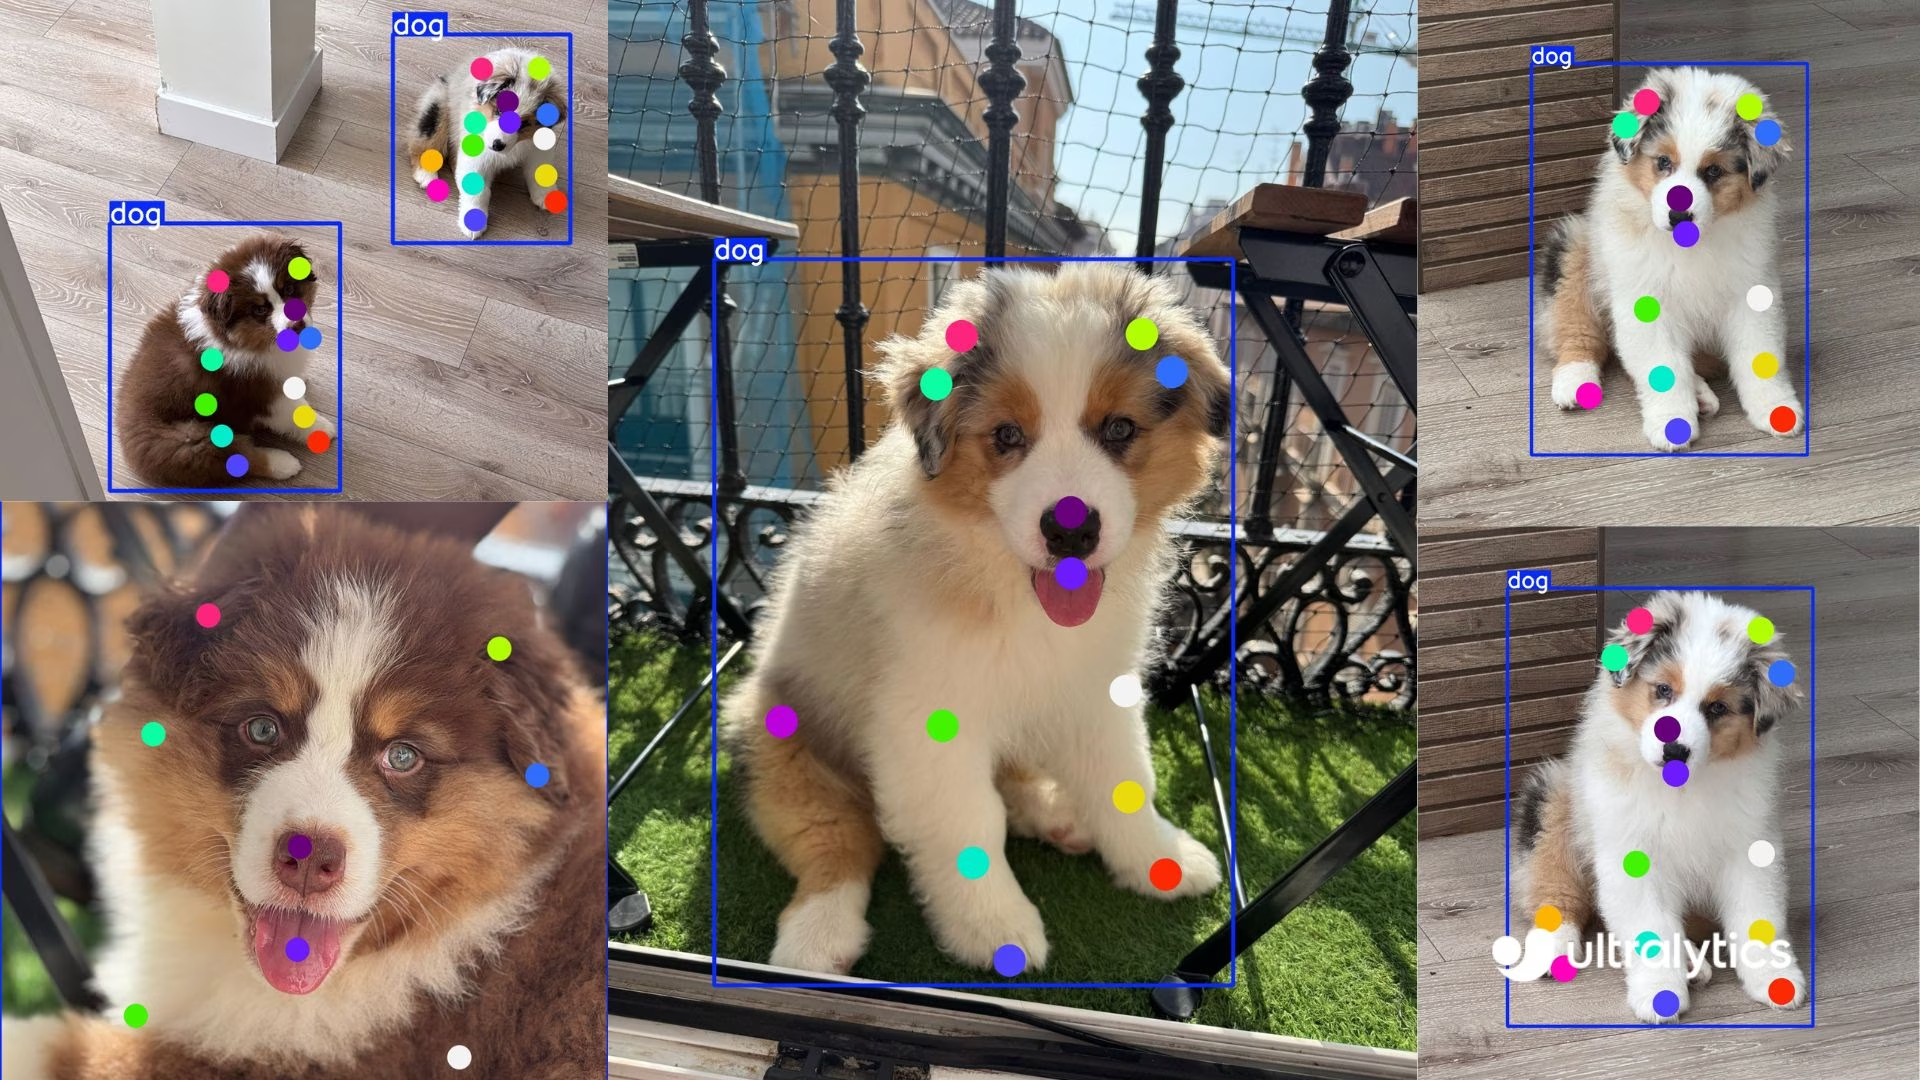
Resisti alla tentazione di aggiungere punti "per ogni evenienza": ognuno richiede tempo per l'etichettatura di ogni istanza, e i punti che nessuno utilizza aggiungono solo rumore alla metrica. I dataset pubblici mostrano la varietà: Tiger-Pose usa 12 punti senza visibilità, Dog-Pose ne usa 24 e Hand Keypoints 21:
Scrivi il YAML del dataset#
path: forklift-pose
train: images/train
val: images/val

kpt_shape: [4, 3] # 4 keypoints, each x, y, visibility
flip_idx: [1, 0, 2, 3] # fork tips swap, mast points stay
kpt_oks_sigmas: [0.05, 0.05, 0.08, 0.08] # tips are sharp, mast ends are fuzzier

names:
  0: forklift

kpt_names:
  0:
    - left_fork_tip
    - right_fork_tip
    - mast_top
- mast_basekpt_namesdocumenta l'ordine dei punti per persone e strumenti, per ciascuna classe.flip_idxdeve essere involutivo: applicandolo due volte, ogni indice deve tornare a se stesso.kpt_oks_sigmasè facoltativo e determina i pesi sia della loss dei punti chiave durante l'addestramento sia di OKS durante la validazione; se presente, deve contenere un valore positivo per ogni punto chiave, altrimenti l'esecuzione si interrompe con unValueError.
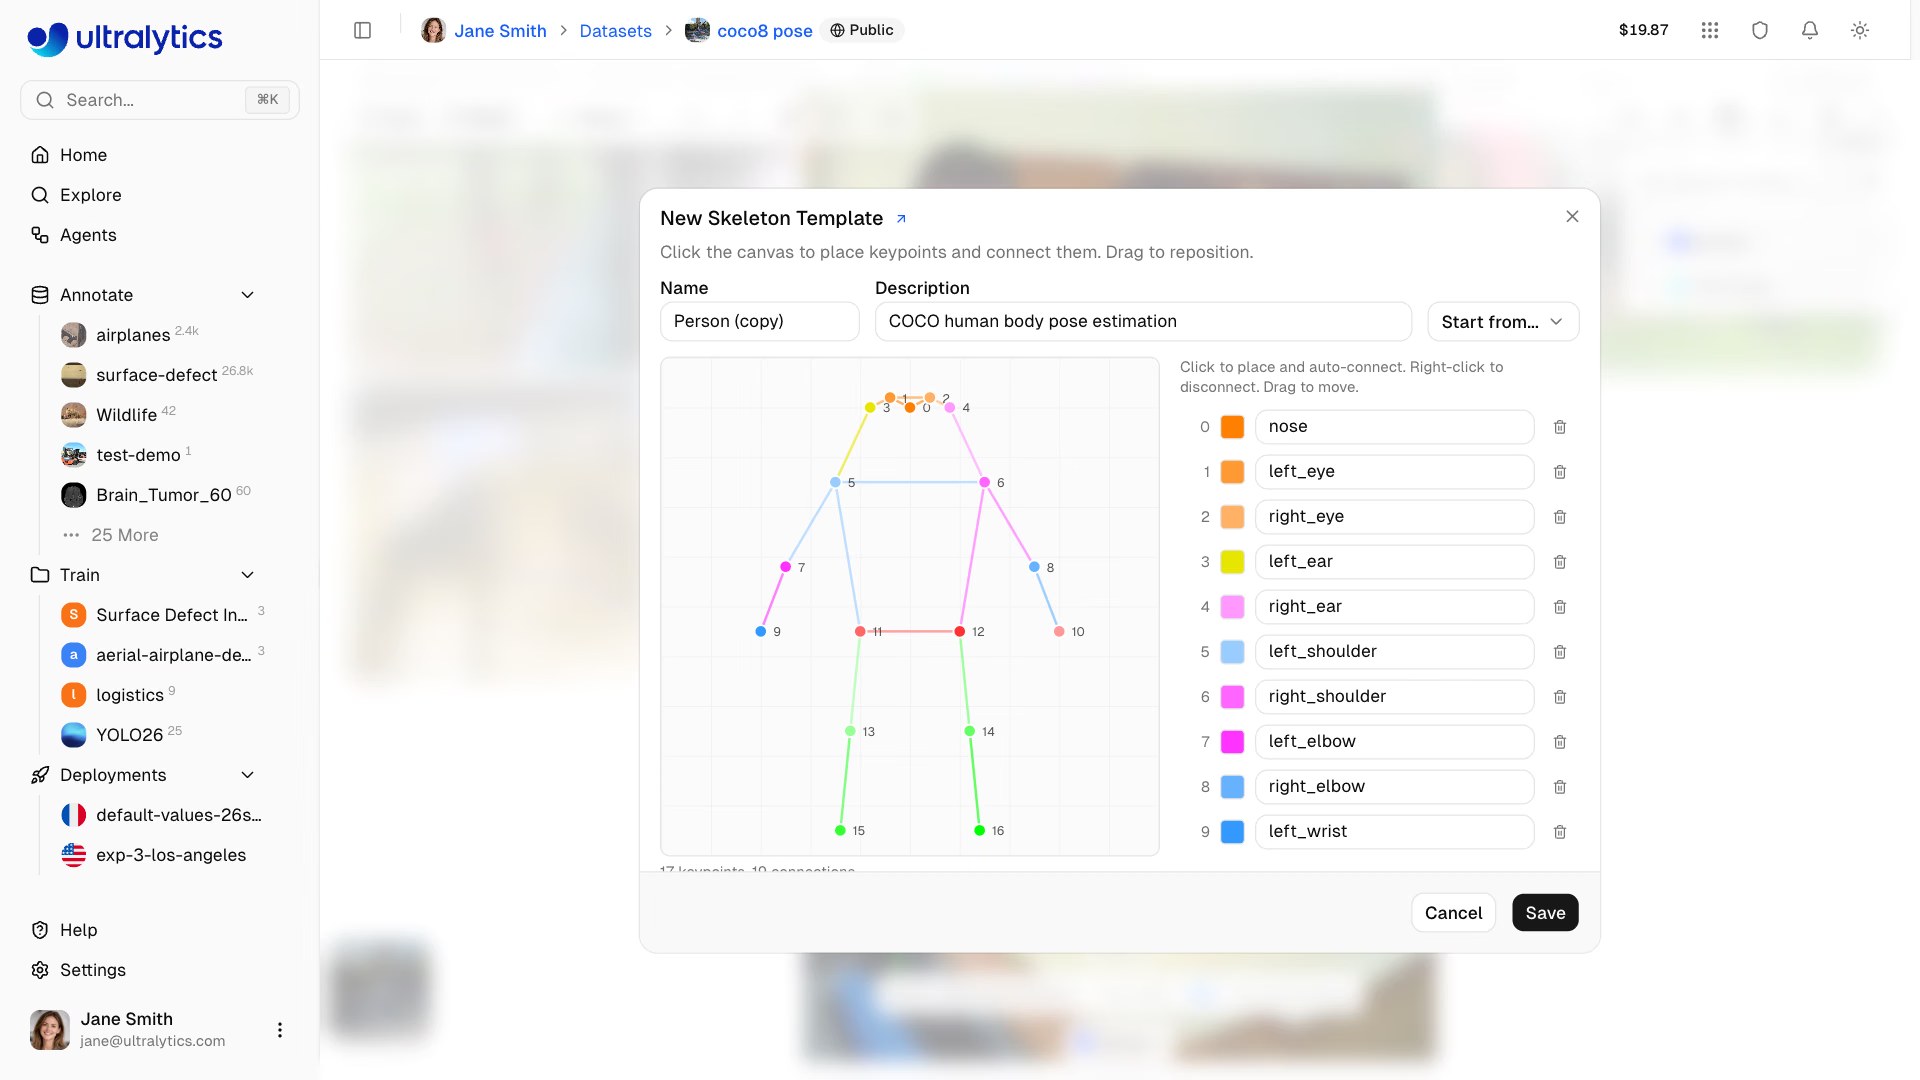
Su Ultralytics Platform, lo stesso schema diventa un modello di scheletro. Puoi creare un nuovo modello partendo da uno esistente (Parti da…), rinominando e riducendo i punti anziché posizionare manualmente ogni punto chiave: mantieni l'ordine degli indici della tabella dello schema:
Verifica le etichette prima dell'addestramento#
I dataset di stima della posa possono presentare errori difficili da notare: una riga a cui manca un punto chiave sposta tutti i valori successivi, mentre una visibilità pari a 3 generata da un esportatore difettoso viene letta come un qualsiasi altro numero. Questo verificatore carica il YAML tramite il loader di Ultralytics e convalida ogni riga. Puoi eseguirlo così com'è su COCO8-pose; sostituisci il percorso del tuo YAML:
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-pose.yaml")  # resolves paths, downloads if needed
k, dims = data["kpt_shape"]
flip = data.get("flip_idx", [])
assert not flip or sorted(flip) == list(range(k)), "flip_idx must list every keypoint index once"
assert all(flip[flip[i]] == i for i in range(len(flip))), "flip_idx must undo itself: pairs swap, center points stay"

expected = 5 + k * dims  # class + 4 box values + k keypoints of `dims` values
bad = 0
for label in Path(data["path"], "labels").rglob("*.txt"):
    for n, row in enumerate(label.read_text().splitlines(), 1):
        values = row.split()
        if len(values) != expected:
            bad += 1
            print(f"{label.name}:{n} has {len(values)} values, expected {expected}")
        elif dims == 3 and not {float(v) for v in values[7::3]} <= {0, 1, 2}:
            bad += 1
            print(f"{label.name}:{n} has a visibility flag outside 0/1/2")
print(f"kpt_shape={data['kpt_shape']}, flip_idx ok, {bad} bad rows")
kpt_shape=[17, 3], flip_idx ok, 0 bad rowsvalues[7::3] inizia dal primo flag di visibilità (classe, quattro valori del riquadro, quindi x y v) e prende ogni terzo valore successivo.
Come OKS valuta un punto chiave#
Pose mAP sostituisce la IoU dei riquadri con la Similarità dei punti chiave degli oggetti (OKS). Per ogni punto chiave etichettato, OKS trasforma la distanza in pixel tra la previsione e l'etichetta in un punteggio da 0 a 1, scalato in base alle dimensioni dell'oggetto e al valore sigma del punto chiave, quindi calcola la media sui punti chiave etichettati. Pose mAP50-95 calcola la media della precisione a soglie OKS da 0.50 a 0.95, proprio come box mAP sulle soglie IoU; la guida alle metriche di prestazione descrive il meccanismo condiviso.
Il modo più semplice per capire i valori sigma è misurarli. Questo script valuta la stessa previsione del carrello elevatore con due valori sigma, usando la funzione kpt_iou richiamata dal validatore della stima della posa:
import torch

from ultralytics.utils.metrics import kpt_iou

# One labeled forklift, 4 keypoints (x, y, visibility) in pixels, inside a 200 x 120 px box
label = torch.tensor([[[40.0, 30, 2], [40, 90, 2], [170, 20, 2], [170, 100, 2]]])
area = torch.tensor([200 * 120 * 0.53])  # Ultralytics scales box area by 0.53 to approximate object area

for offset in (2, 5, 10, 20):
    pred = label.clone()
    pred[..., 0] += offset  # every predicted keypoint lands `offset` pixels to the right
    sharp = kpt_iou(label, pred, area, sigma=[0.025] * 4).item()
    loose = kpt_iou(label, pred, area, sigma=[0.10] * 4).item()
    print(f"{offset:2d} px off: OKS {sharp:.2f} with sigma 0.025, {loose:.2f} with sigma 0.10")
2 px off: OKS 0.94 with sigma 0.025, 1.00 with sigma 0.10
5 px off: OKS 0.67 with sigma 0.025, 0.98 with sigma 0.10
10 px off: OKS 0.21 with sigma 0.025, 0.91 with sigma 0.10
20 px off: OKS 0.00 with sigma 0.025, 0.67 with sigma 0.10Su un carrello elevatore di 200 × 120 pixel, una previsione con un errore di 10 pixel non supera la soglia OKS di 0.50 con un valore sigma di 0.025, ma supera tutte le soglie fino a 0.90 con un valore sigma di 0.10. Stesso modello, stesso errore, pose mAP molto diversa.
| Sigma | Effetto | Uso |
|---|---|---|
| Piccolo (≈ 0.025–0.05) | anche pochi pixel di errore riducono già il punteggio | punti ben definiti: occhi, punte delle forche, angoli |
| Grande (≈ 0.08–0.10) | tolleranza ampia | punti poco definiti: fianchi, centro di un montante |
| Predefinita | Valori sigma COCO per kpt_shape: [17, 3]; altrimenti 1/K per ogni punto | inizia da qui, poi misura |
I valori sigma dovrebbero riflettere la coerenza con cui gli annotatori posizionano ciascun punto. Misurala: chiedi a due persone di etichettare le stesse 50 immagini e confronta le distanze per punto chiave. I punti su cui non sono d'accordo richiedono valori sigma più alti; altrimenti la metrica penalizza il modello per il rumore umano.
Modificare kpt_oks_sigmas cambia la mAP di pose senza modificare il modello, come mostra la tabella qui sopra. Imposta i valori sigma prima del primo riferimento, registrali con ogni risultato e non confrontare mai esecuzioni convalidate usando valori diversi.
Mostra la soluzione
Esempio di un pacco su un nastro trasportatore, visto dall'alto, con la domanda "l'etichetta è rivolta verso l'alto e in che direzione è ruotata?":
| Indice | Punto chiave | Funzione | Punto corrispondente speculare | Sigma |
|---|---|---|---|---|
| 0 | label_top_left | orientamento dell'etichetta | 1 | 0.04 |
| 1 | label_top_right | orientamento dell'etichetta | 0 | 0.04 |
| 2 | label_bottom_right | orientamento dell'etichetta | 3 | 0.04 |
| 3 | label_bottom_left | orientamento dell'etichetta | 2 | 0.04 |
kpt_shape: [4, 3]
flip_idx: [1, 0, 3, 2]
kpt_oks_sigmas: [0.04, 0.04, 0.04, 0.04]
flip_idx supera il controllo di involutività: 0 → 1 → 0 e 2 → 3 → 2. Un'etichetta specchiata scambia sinistra e destra ma mantiene alto e basso, quindi l'angolo superiore sinistro corrisponde all'angolo superiore destro, non a quello inferiore destro.
Per determinare la tolleranza, imposta sigma=[0.04] * 4 in oks.py e amplia gli scostamenti; la scala è definita dal riquadro dell'etichetta, quindi usa un riquadro delle dimensioni tipiche di un'etichetta dei pacchi nelle tue immagini. Lo scostamento al quale OKS scende per la prima volta sotto 0.5 è l'errore massimo compatibile con la precisione dei tuoi annotatori.