Etichetta e addestra un modello di segmentazione di istanze
Scrivi etichette poligonali, controllale nel codice, addestra yolo26n-seg.pt su COCO8-seg e diagnostica un modello dalla differenza tra le metriche di bounding box e maschera.
La segmentazione di istanze assegna a ogni oggetto il proprio contorno, ciò che serve quando la decisione dipende dall'area, dalla sovrapposizione o da un confine. I poligoni sono le etichette più costose che la maggior parte dei team acquista e una riga malformata non blocca l'addestramento: lo addestra silenziosamente sulla forma sbagliata. In questa lezione imposti il formato corretto delle righe, controlli un insieme di etichette nel codice e addestri un primo modello per vedere cosa ottieni con l'etichettatura aggiuntiva: una seconda metrica che valuta i contorni, non solo le posizioni.
Pratico
La riga dell'etichetta poligonale#
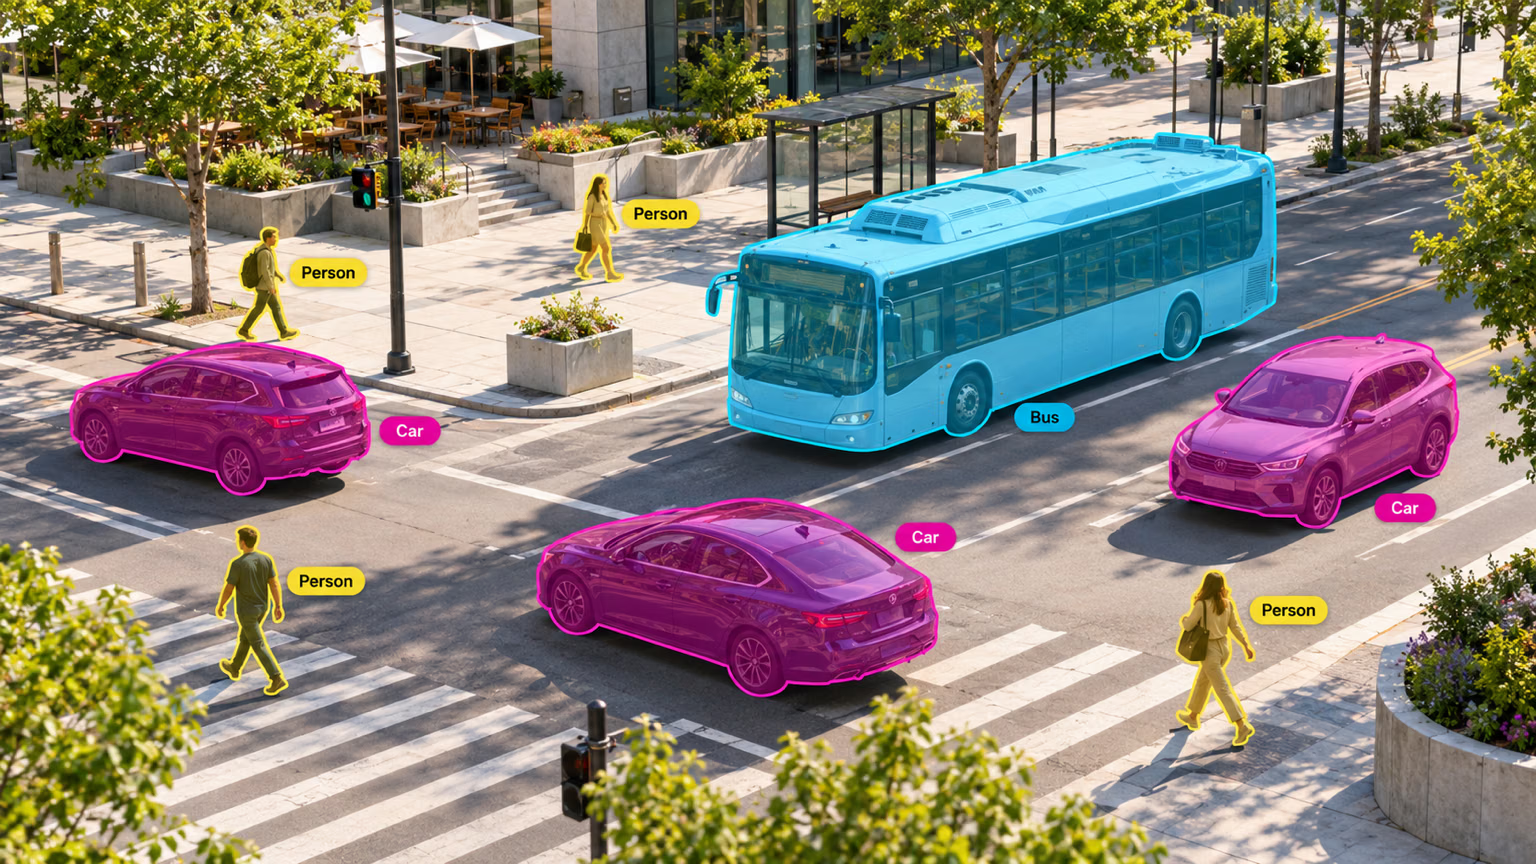
Un file di etichette di segmentazione ha una riga per oggetto, come un'etichetta di rilevamento, ma invece di una bounding box elenca il contorno dell'oggetto come coppie di vertici normalizzate. Ecco una riga reale di COCO8-seg, abbreviata:
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| Posizione | Riga di rilevamento | Riga di segmentazione |
|---|---|---|
| 1 | indice della classe (45 è bowl) | indice della classe |
| 2–5 | x_center y_center width height | i primi due vertici, x1 y1 x2 y2 |
| 6+ | — | altri vertici, quanti ne servono per definire il contorno |
| Unità | normalizzate 0–1 | normalizzate 0–1 (x in pixel ÷ larghezza dell'immagine, y in pixel ÷ altezza dell'immagine) |
Tre regole sono fondamentali: almeno tre vertici per oggetto, coordinate divise per le dimensioni dell'immagine e una riga per istanza anche quando due oggetti della stessa classe si toccano. La guida ai dataset di segmentazione contiene la specifica completa.
I poligoni sono un superset delle etichette di riquadro. La stessa cartella di etichette addestra yolo26n.pt (Ultralytics ricava ogni riquadro dal relativo poligono) e yolo26n-sem.pt (rasterizza i poligoni in mappe di classi): abbiamo addestrato entrambi con coco8-seg.yaml. Se il piano cambia dopo l'etichettatura, il budget non è sprecato.
Controlla le etichette prima di addestrare#
Una riga con un numero dispari di valori, una coordinata espressa in pixel o un contorno tracciato intorno all'oggetto sbagliato non interromperanno l'addestramento. Questo controllo carica il dataset con il loader di Ultralytics, rifiuta le righe malformate e stampa l'area di ogni poligono accanto alla bounding box che Ultralytics ne ricaverà:
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38Le aree sono frazioni dell'immagine, quindi la prima ciotola occupa il 39% della foto. Riempimento è l'area del poligono divisa per l'area della bounding box ed è la colonna da esaminare:
- La maggior parte degli oggetti compatti (ciotole, arance, broccoli) si attesta intorno a 0,6–0,7.
- Il valore 0,31 della giraffa è corretto: le zampe e il collo lunghi lasciano vuota gran parte della bounding box, ed è proprio per questo che serve una maschera.
- Il valore 0,15 della terza ciotola è quello che un revisore dovrebbe controllare. Intorno al cibo è visibile solo un sottile bordo della ciotola, quindi il suo contorno è una striscia stretta all'interno di una bounding box grande. In questo caso è corretto; nei tuoi dati, un riempimento così basso indica altrettanto spesso che il contorno è stato tracciato intorno all'oggetto sbagliato.
Correggi tutte le righe BAD prima dell'addestramento. Poi ordina per riempimento e apri in uno strumento di annotazione le righe con il riempimento più basso per ciascuna classe: un riempimento basso indica un oggetto sottile o occluso (da mantenere) oppure un contorno errato (da correggere).
Ottieni poligoni senza tracciare ogni bordo#
Tracciare a mano i contorni è la parte costosa dell'etichettatura dei dati. Prima di iniziare, controlla quale scorciatoia puoi usare:
| Hai già | Strumento |
|---|---|
| JSON COCO con segmentazione | convert_coco(labels_dir, use_segments=True) da ultralytics.data.converter |
| Maschere PNG (valore del pixel = indice della classe + 1, 0 = sfondo) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes) — gli oggetti della stessa classe che si toccano diventano un unico poligono, quindi dividili durante la revisione |
| Solo etichette di bounding box | yolo_bbox2segment(im_dir) — fornisci a SAM ogni bounding box come prompt per generare un poligono |
| Ancora niente | Annotazione intelligente ed etichettatura in batch — fai clic una volta e rivedi il poligono |
Sulla Ultralytics Platform, la modalità Smart usa SAM: un clic positivo sull'oggetto e un clic negativo su ciò che deve escludere generano una maschera da rivedere.
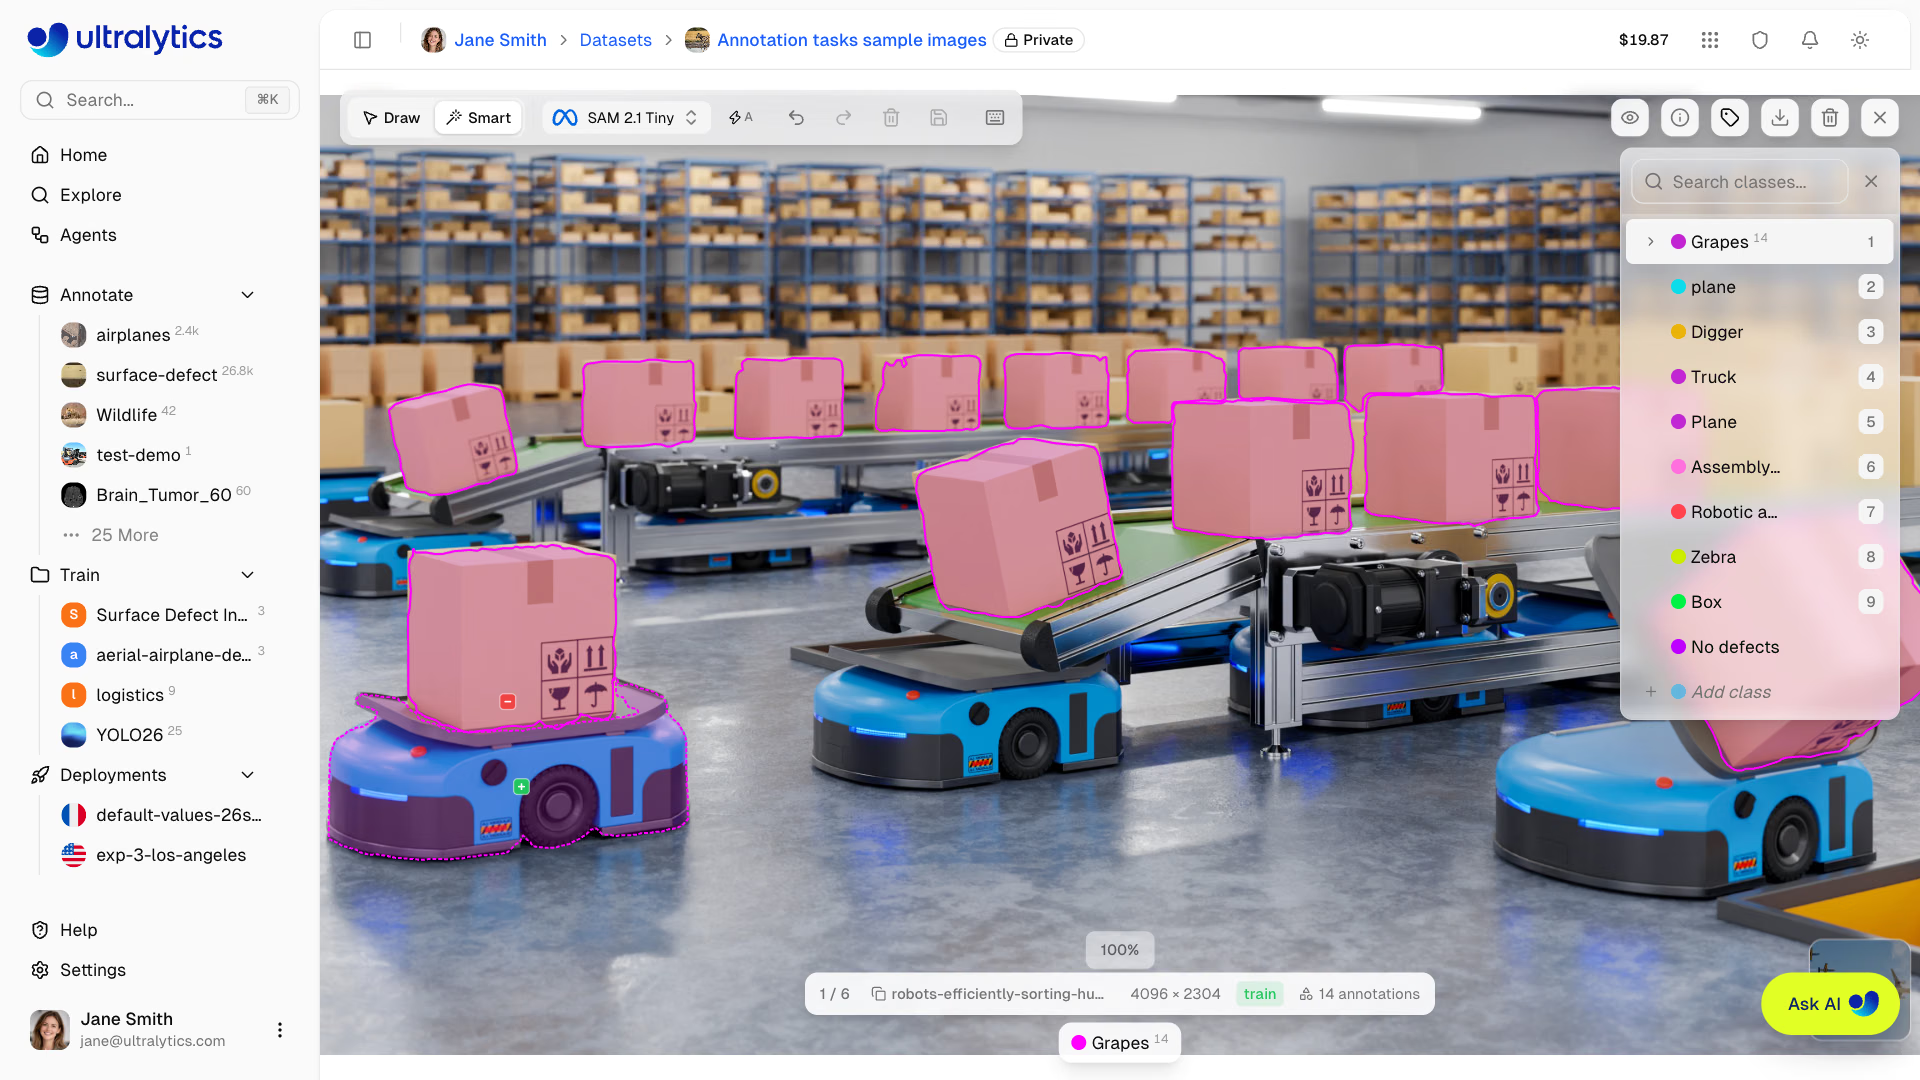
Una maschera che invade lo sfondo insegna al modello a fare lo stesso. Confronta i poligoni generati automaticamente con i criteri di qualità descritti in Riquadri e maschere, poi ripeti il controllo delle etichette qui sopra.
Addestra su COCO8-seg#
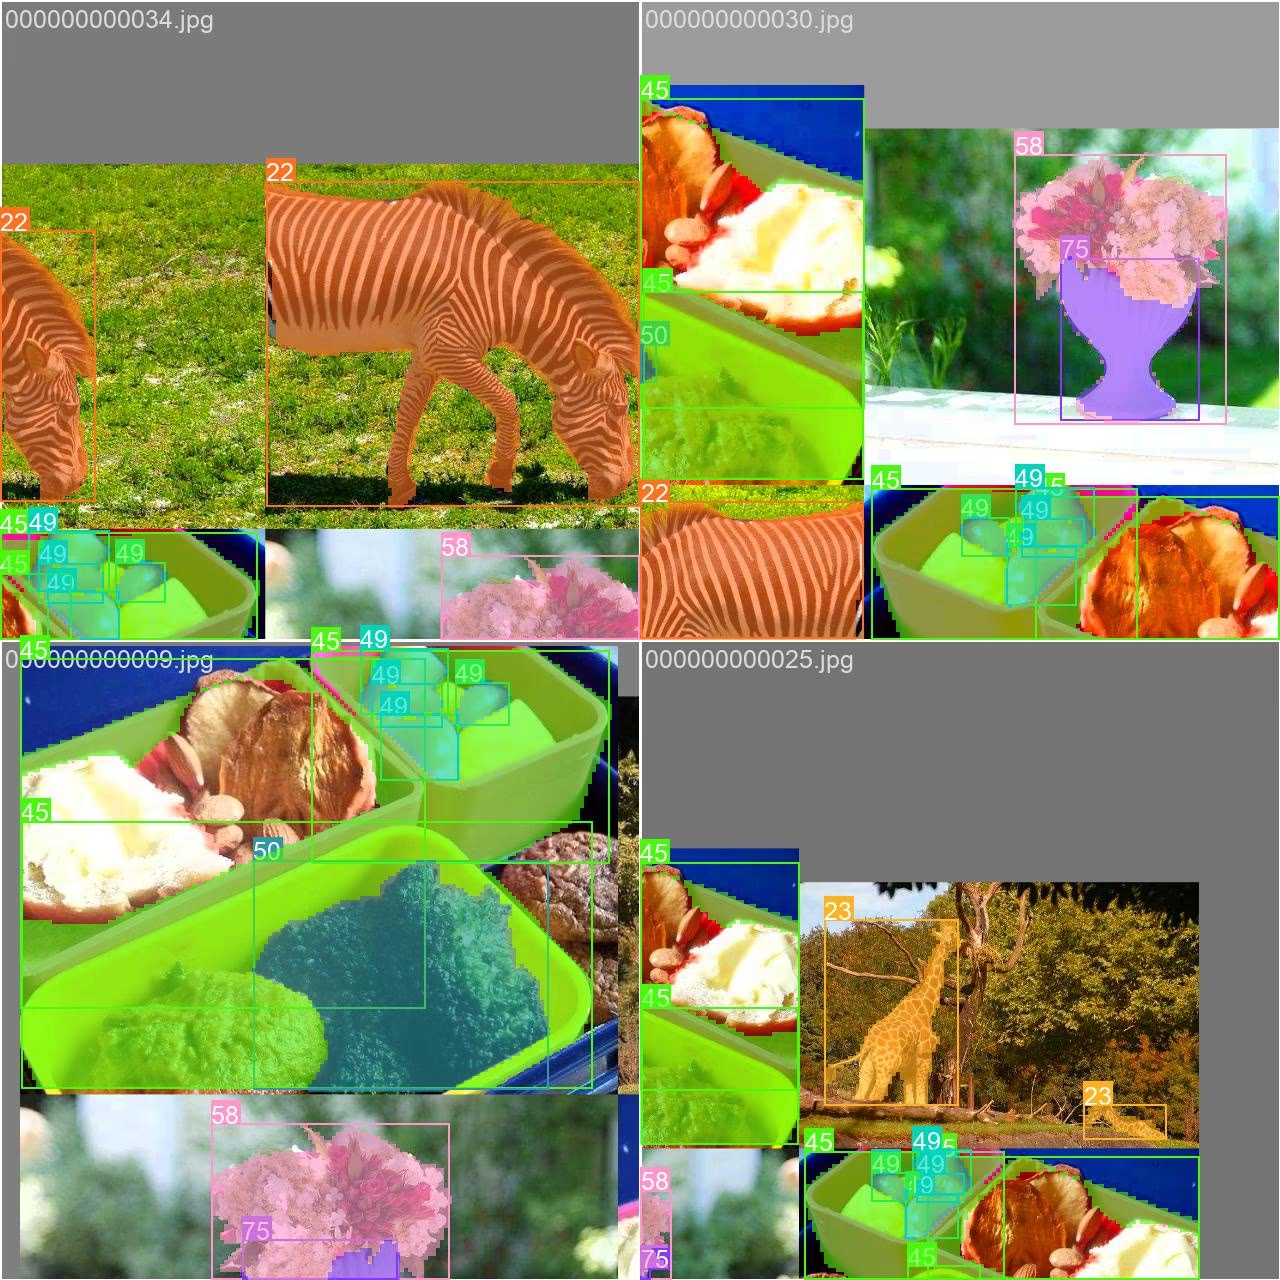
L'addestramento segue il flusso di lavoro di rilevamento, ma usa un modello -seg e un dataset di segmentazione. Un'epoca a imgsz=320 su una CPU di laptop termina in pochi secondi, quanto basta per verificare l'intera pipeline:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377Quattro immagini di convalida rendono questi numeri poco significativi; l'importante è che l'esecuzione termini e scriva weights/best.pt in runs/segment/. Per dati reali, segui la guida all'attività Segment e addestra con il programma completo su una GPU.
Leggi fianco a fianco le metriche delle bounding box e delle maschere#
La tabella di convalida contiene due sezioni. Box valuta ogni bounding box prevista rispetto alla bounding box implicata dall'etichetta; Mask confronta i pixel previsti con il poligono etichettato. Entrambe usano lo stesso meccanismo di mAP; cambia solo IoU.
mAP50-95 delle maschere è quasi sempre il valore più basso dei due, perché IoU dei pixel è più rigoroso: una bounding box spostata di pochi pixel continua a sovrapporsi bene, mentre una maschera che non include un braccio o invade la strada perde rapidamente IoU alle soglie 0,75–0,95. La riga horse mostra il caso più estremo: mAP50-95 delle bounding box è 0.564, quello delle maschere 0.199. Il modello ha trovato entrambi i cavalli e li ha racchiusi bene nelle bounding box, ma non ne ha delineato zampe e code. Usa la differenza per decidere cosa correggere:
- Entrambe basse: il problema è trovare gli oggetti, non delinearli. Per prima cosa, aggiungi dati relativi alle condizioni in cui gli oggetti non vengono rilevati.
- Bounding box buona, maschera molto più bassa: il modello trova gli oggetti, ma li delinea male. Esegui il controllo delle etichette, prova un modello più grande oppure addestra e convalida a una
imgszpiù alta. - La maschera migliora mentre la bounding box ristagna: va bene: per un prodotto di segmentazione, mAP50-95 delle maschere è il criterio di rilascio.
overlap_mask=True unisce le maschere di istanza in un'unica immagine durante l'addestramento e mask_ratio=4 riduce la risoluzione delle maschere di addestramento. Nessuno dei due modifica la risoluzione delle maschere predette: il parametro che la controlla è retina_masks, trattato nella lezione successiva. Lasciali entrambi sui valori predefiniti, a meno che tu non abbia misurato un motivo per modificarli.
Mostra la soluzione
Per controllare ogni suddivisione, sostituisci la cartella nel ciclo con Path(data["path"], "labels").rglob("*.txt"). Poi addestra:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}")   # 0.377 in our run
Una differenza di 0.1 è prevista: IoU delle maschere penalizza ogni pixel del contorno, mentre IoU delle bounding box penalizza solo i quattro lati. Nella nostra esecuzione, la classe con la differenza maggiore è horse (bounding box 0.564, maschera 0.199). mAP delle bounding box è buono e quello delle maschere è molto più basso, quindi il diagramma indica la qualità dei contorni: controlla prima questi poligoni, poi prova un modello più grande o una imgsz più alta.