Segmentazione semantica: etichettare ogni pixel
Prevedi una mappa delle classi per pixel con yolo26n-sem.pt, trasformala in valori di copertura, crea dataset di mappe delle classi PNG e interpreta mIoU senza lasciarti ingannare dall'accuratezza dei pixel.
Alcune domande non riguardano il conteggio degli oggetti: quanta parte del marciapiede è bloccata, quanta parte di un campo è invasa dalle erbacce, dove finisce la strada percorribile. La segmentazione semantica risponde assegnando un ID di classe a ogni pixel. La sua metrica principale, però, può essere interpretata male facilmente: il modello che addestri in questa lezione raggiunge un'accuratezza dei pixel del 91% senza mai rilevare una persona.
Pratico
Segmentazione di istanze o semantica?#
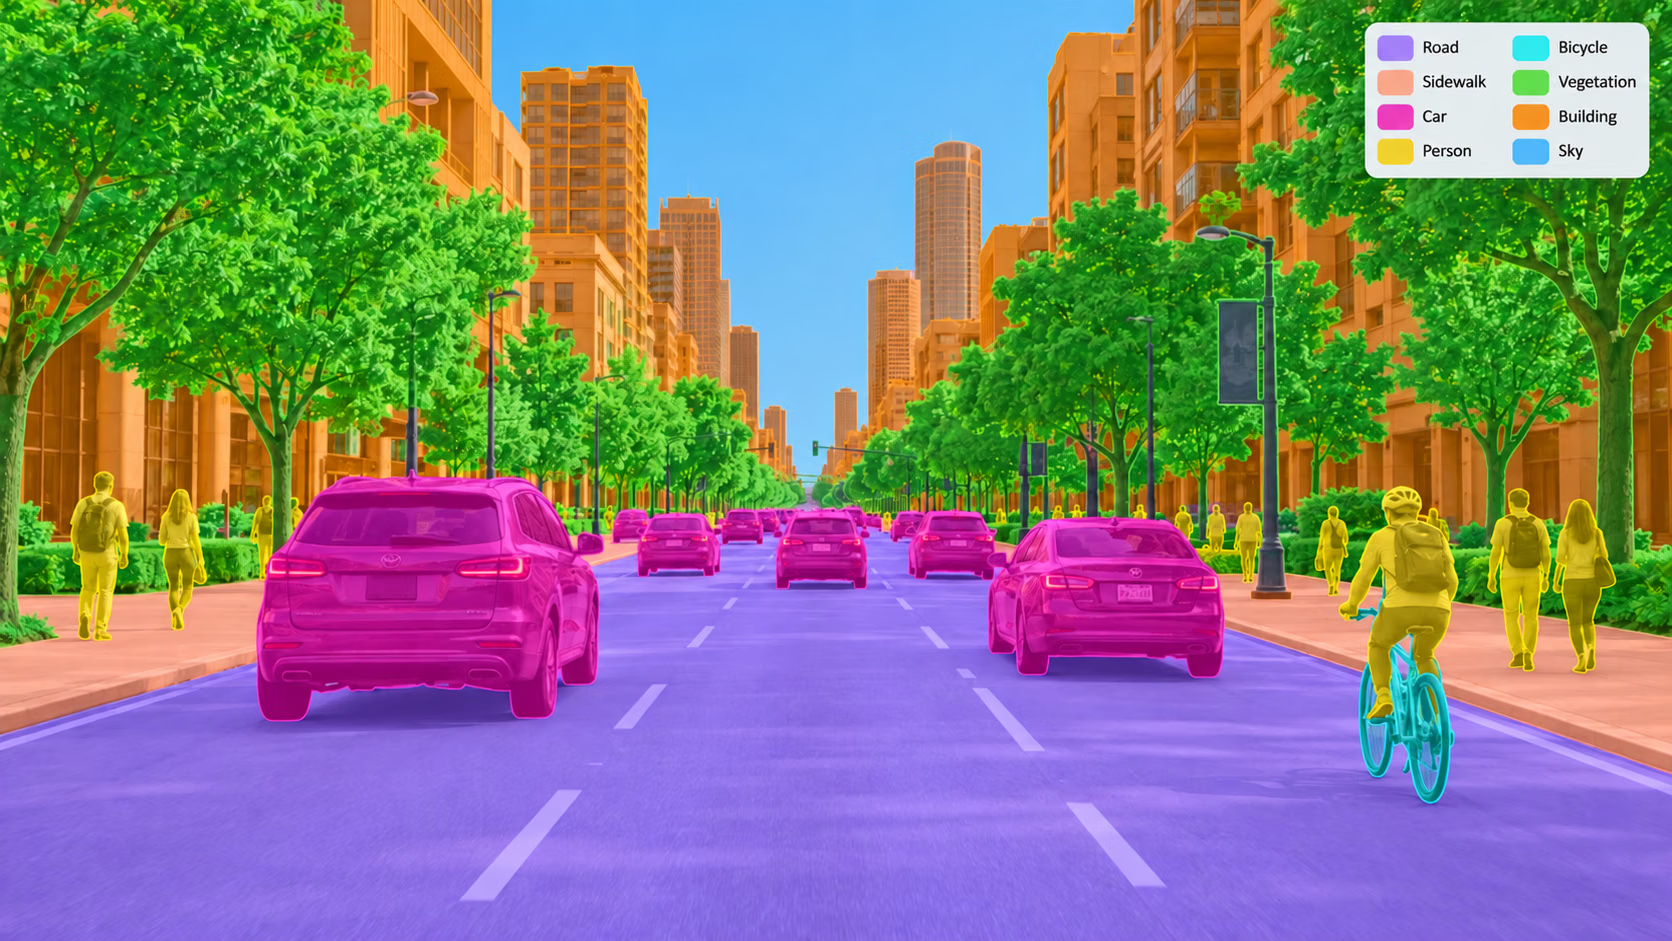
Segmentazione di istanze (segment) | Segmentazione semantica (semantic) | |
|---|---|---|
| Output | una maschera per oggetto, più un riquadro | un ID di classe per pixel |
| Conta gli oggetti | sì | no — due auto a contatto formano un'unica regione "auto" |
| Gestisce le classi di tipo "stuff" (strada, cielo, erba) | male — non esistono istanze naturali | sì |
| Etichette | poligoni | mappe delle classi PNG o poligoni |
| Metrica di soglia | mAP50-95 delle maschere | mIoU |
| Pesi preaddestrati | yolo26n-seg.pt (COCO, 80 classi) | yolo26n-sem.pt (Cityscapes, 19 classi) |
Se la domanda a valle include «quanti», usa la segmentazione di istanze. Se invece chiede «quanto» o «dove», la segmentazione semantica è più semplice da etichettare e interpretare. La pagina del task di segmentazione semantica contiene la tabella dei modelli.
Prevedere una mappa delle classi#
result.semantic_mask.data è un tensore H × W alle dimensioni originali dell'immagine; ogni valore è un ID di classe e 255 significa ignora. result.summary() lo trasforma in rapporti di pixel per classe:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Guarda l'ultima riga. Cityscapes contiene una classe bus, ma il modello classifica l'autobus come train. Il modello è stato addestrato su riprese effettuate da automobili, perlopiù su strade tedesche, e un autobus fotografato da vicino dal marciapiede è fuori da tale distribuzione. I modelli semantici ereditano il punto di vista e le definizioni delle classi del set di addestramento — il suo bias del dataset — in modo più rigido rispetto ai rilevatori. Perciò, prima di affidarti alla mappa, esegui il fine-tuning usando la tua telecamera.
Trasforma la mappa delle classi in una risposta#
Una mappa delle classi diventa un valore utile al prodotto con semplici confronti tra tensori. Ecco la domanda: "quanta parte dell'area in cui camminerebbe un pedone è strada o marciapiede, e quanta è occupata da persone?"
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personTre abitudini rendono affidabili questi valori:
- Cerca gli ID per nome in
result.names, mai usando un numero codificato direttamente: un modello addestrato sulle tue classi assegnerà loro numeri diversi. - Limita l'analisi alla regione rilevante. I rapporti sull'intero fotogramma includono cielo ed edifici; prima ritaglia la mappa delle classi oppure moltiplicala per una maschera della regione.
- Apri la sovrapposizione.
semantic_overlay.jpgti mostra subito se la "strada" conteggiata dal valore è davvero una strada.
Il formato del dataset#
I dataset semantici associano a ogni immagine una maschera a canale singolo, i cui valori dei pixel sono ID di classe. La guida ai dataset semantici è il riferimento; la struttura rispecchia quella di images/ file per file:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
Il file YAML aggiunge masks_dir e, quando gli ID memorizzati nelle maschere differiscono dagli ID usati per l'addestramento, un blocco label_mapping:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Le maschere Cityscapes memorizzano gli ID grezzi delle etichette da -1 a 33; la mappatura ne conserva 19 e assegna gli altri a ignore_label, memorizzato come 255. I pixel impostati su 255 vengono esclusi sia dalla loss sia dalle metriche: usa lo stesso valore per le regioni su cui i tuoi annotatori non sono riusciti a decidere.
Se hai già etichette poligonali ma non hai masks_dir, il caricatore rasterizza i poligoni e aggiunge una classe background per i pixel non coperti.
La compressione con perdita altera i valori dei pixel adiacenti, trasformando il confine tra la classe 7 e la classe 8 in una sfumatura di 7, 8 e ID inesistenti. Salva tutte le maschere in PNG o TIFF.
Addestramento e interpretazione di mIoU#
Cityscapes8 contiene 8 immagini di scene urbane, 4 per l'addestramento e 4 per la validazione: un numero sufficiente per un test rapido su CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Righe per classe abbreviate.) L'accuratezza dei pixel indica il 91%; mIoU indica il 42%; le righe per classe mostrano che il modello non ha rilevato nemmeno una persona. Sono tutti e tre risultati corretti. Strada, edificio e vegetazione occupano la maggior parte dei pixel: la sola strada ne copre 78,529 su 192,315. Perciò, un modello che le classifica bene ottiene un'accuratezza dei pixel elevata anche se non rileva nessuna delle classi piccole. mIoU calcola la media di IoU per classe assegnando a tutte lo stesso peso, quindi ogni classe non rilevata abbassa il risultato.

Imponi una soglia su mIoU e su IoU per le classi su cui interviene il tuo prodotto. Se una funzione di sicurezza per i pedoni ha IoU 0 per la classe persona, non è accettabile, a prescindere dall'accuratezza sui pixel.
Mostra la soluzione
Nella nostra esecuzione: mIoU 0.415, accuratezza dei pixel 0.906 e IoU pari a 0 per muro, persona, ciclista, motocicletta e bicicletta, oltre a tutte le classi senza pixel nelle quattro immagini di validazione.
L'accuratezza dei pixel è più alta perché conta i pixel e strada, edificio, vegetazione e cielo costituiscono la maggior parte di ogni fotogramma Cityscapes. mIoU assegna lo stesso peso a ogni classe, quindi cinque classi piccole non rilevate abbassano la media anche se coprono solo poche centinaia di pixel. Per un prodotto che prende decisioni sulle persone, questo modello non supera il criterio di accettazione basandosi solo sull'IoU della classe persona.