Addestra un classificatore di immagini
Organizza un dataset in cartelle, addestra yolo26n-cls.pt su MNIST160, leggi le probabilità e l'accuratezza top-1 e invia le predizioni con bassa confidenza a una revisione umana.
La classificazione delle immagini risponde a una domanda per immagine: che cos'è? Richiede le etichette più economiche tra tutte le attività — il nome di una cartella — ed è l'opzione più veloce, perciò è la seconda fase predefinita dopo un rilevatore e il modello iniziale ideale per una stazione di ispezione che acquisisce un singolo componente per fotogramma. Il dataset non ha un file YAML, quindi la struttura delle cartelle definisce il contratto; inoltre, un classificatore fornisce sempre una risposta, anche per immagini che non assomigliano a nulla di ciò che ha già visto. Capire quando non fidarsi del risultato è metà del lavoro.
Pratico
La struttura del dataset in cartelle#
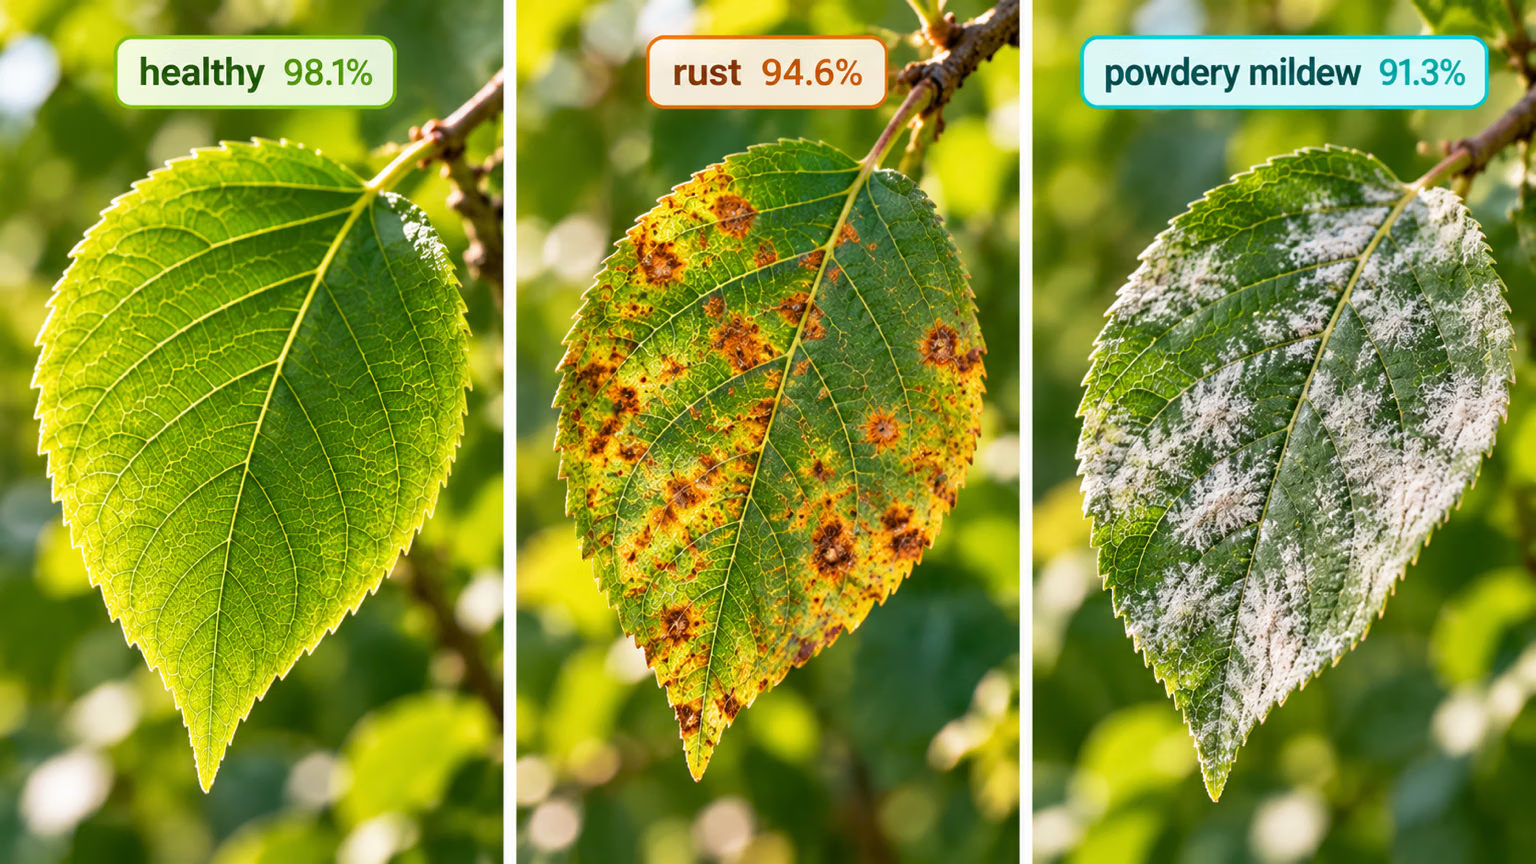
I dataset di classificazione sono directory, non file YAML. Imposta data= sulla cartella radice:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Ecco cosa fa il caricatore, in base al codice sorgente installato e alla guida ai dataset di classificazione:
| Situazione | Comportamento |
|---|---|
| Indici delle classi | nomi delle cartelle in train/, in ordine alfabetico → dent=0, good=1, scratch=2 |
| Cartella di validazione | val/, poi validation/, poi valid/; in assenza di queste, usa test/ e mostra un avviso |
Nessuna cartella train/, solo cartelle delle classi | suddivide automaticamente i dati in train/ e val/ con una proporzione 80/20 |
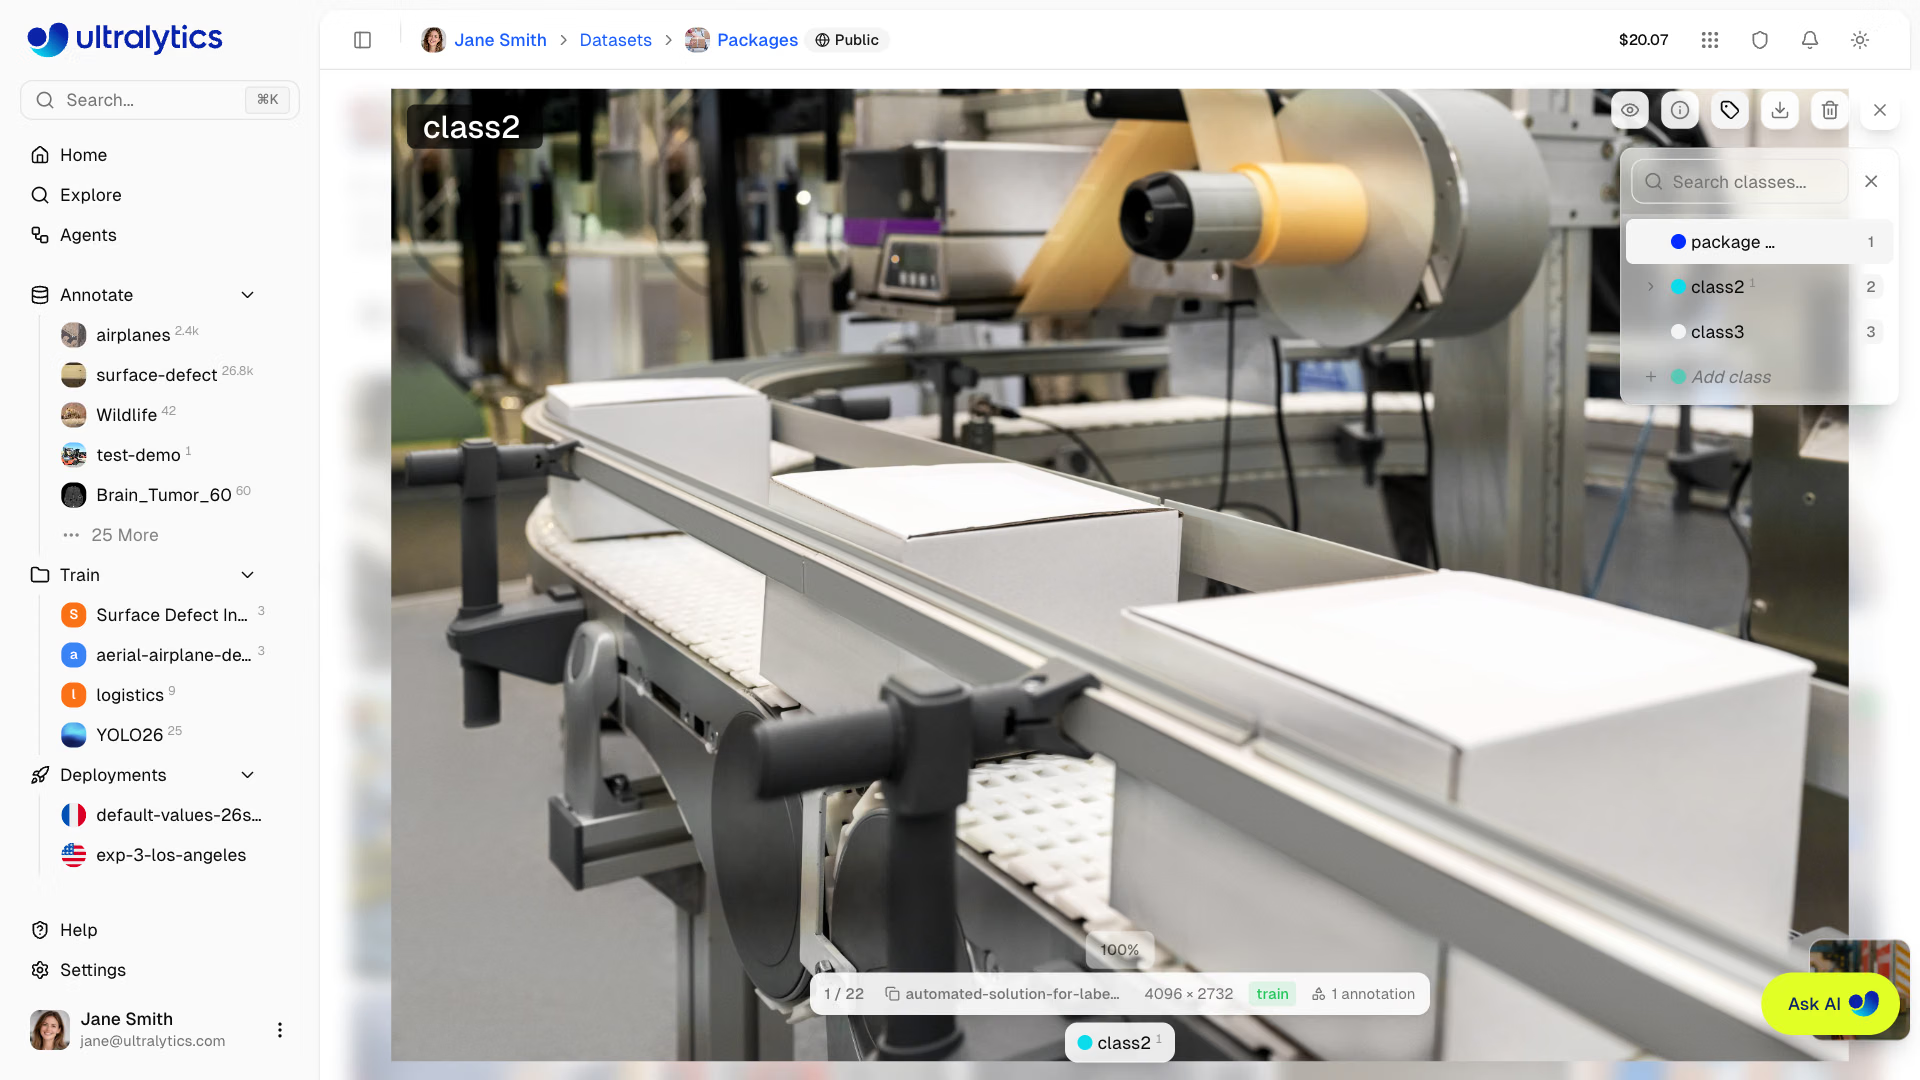
Sulla Ultralytics Platform, un dataset di classificazione contiene un'etichetta a livello di immagine per ogni immagine, anziché forme:
Sintomo: dopo aver aggiunto una classe, una vecchia integrazione segnala le parti good come dent. Causa: l'aggiunta di una cartella chiamata bent la ordina per prima e sposta tutti gli indici successivi. Soluzione: mappa sempre gli indici ai nomi con model.names (o result.names); non codificare mai un indice in modo fisso.
Addestra su MNIST160#
MNIST160 contiene 160 cifre scritte a mano, 80 in train/ e 80 in test/, ciascuna suddivisa in dieci cartelle, una per cifra: un dataset abbastanza piccolo per un test rapido su CPU. Non ha una cartella val/, quindi verifica che il caricatore mostri l'avviso e usi come alternativa test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Un'epoca sposta appena la nuova testa a dieci classi. Nella nostra esecuzione, epochs=10 ha raggiunto un'accuratezza top-1 di 0.55 e top-5 di 0.95 in circa dieci secondi su una CPU di laptop: il ciclo funziona, ma serve un programma di addestramento. La guida all'attività Classify elenca le dimensioni dei modelli preaddestrati.
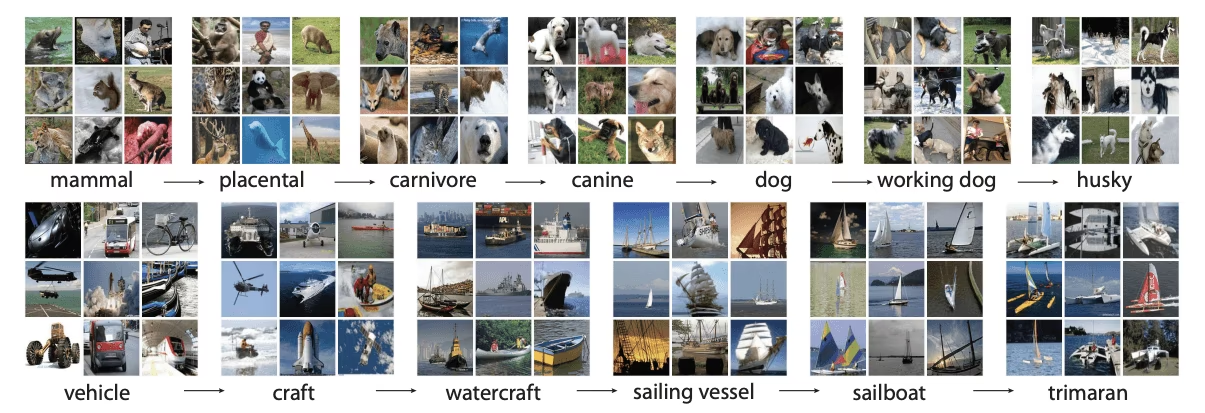
Top-1 è la percentuale di immagini per cui la classe con probabilità più alta è corretta. Top-5 considera corretta una predizione se la classe giusta compare tra le cinque con probabilità più alta. Top-5 è utile per ImageNet, con 1.000 classi (ImageNet), che vanno da categorie ampie a categorie molto specifiche; con cinque classi o meno è sempre 1.0 e con dieci è fin troppo generosa. Valuta il modello in base all'accuratezza top-1 (accuratezza) e a una matrice di confusione per classe.
Leggi le probabilità nel codice#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 è un indice, probs.top5 è un elenco di indici e probs.data è il vettore completo delle probabilità. Nota la confidenza top-1: 0.52 è appena superiore al lancio di una moneta per scegliere tra minibus e police_van. È su questo valore che basi l'instradamento.
Invia le predizioni incerte a una persona#
In produzione, raramente serve che un classificatore indovini ogni immagine; deve invece essere corretto sulle immagini che decide di classificare da solo. Questo script addestra il modello per 10 epoche, poi misura l'effetto di diverse soglie di confidenza sugli 80 numeri tenuti da parte:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Ogni riga rappresenta un compromesso: alzando la soglia, le predizioni accettate diventano più accurate e un maggior numero di immagini viene inviato a una persona. Con 0.6, questo modello classifica da solo solo 10 degli 80 numeri: non è ancora pronto per automatizzare nulla e la soluzione è addestrarlo di più, non scegliere una soglia più ingegnosa. Ripeti la stessa tabella dopo ogni ciclo di addestramento: ti indica sia l'accuratezza prevista sia l'esatta quantità di lavoro di revisione che genera ciascuna soglia.
Scegli la soglia più bassa la cui accuratezza sulle immagini accettate soddisfi il tuo requisito, misurandola su dati di test mai usati in addestramento. Poi verifica che il volume di revisioni che genera sia gestibile dal tuo team; in caso contrario, migliora il modello.
Insidie#
Sintomo: una stazione vuota, un pezzo errato o una mano davanti all'obiettivo ricevono un'etichetta di classe con elevata sicurezza. Causa: le probabilità softmax sommano sempre a 1, quindi il classificatore sceglie sempre una delle sue classi. Soluzione: aggiungi una cartella other/ contenente esclusivamente quelle immagini e invia in revisione le predizioni top1conf con bassa confidenza.
Sintomo: un modello preaddestrato ottiene un punteggio vicino a zero sul tuo dataset prima di qualsiasi addestramento. Causa: yolo26n-cls.pt predice 1.000 indici ImageNet, mentre le tue cartelle riutilizzano gli indici 0–9 con significati diversi: in MNIST160, la cartella 0 è l'indice 0, che la testa preaddestrata chiama tench. In questo modo abbiamo misurato un top-1 pari a 0.000. Soluzione: esegui prima il fine-tuning, poi la validazione.
Sintomo: top-1 vicino a 1.0 in validazione, molto più basso in produzione. Causa: foto quasi identiche dello stesso pezzo in train/ e val/. Soluzione: suddividi per pezzo o per sessione, come descritto in Suddividi correttamente il dataset.
I classificatori sono preaddestrati con imgsz=224, non con 640. Per gli oggetti piccoli all'interno di un fotogramma grande è più adatto rilevare e poi classificare (lezione successiva) che usare un imgsz più grande.
Mostra la soluzione
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
I risultati delle nostre esecuzioni: 1 epoca → top-1 0.162, top-5 0.463; 10 epoche → top-1 0.550, top-5 0.950. Con cinque classi, la risposta corretta rientra sempre nelle prime cinque, quindi top-5 è 1.0 per definizione e non fornisce alcuna informazione.
Per raggiungere un'accuratezza del 75% sulle immagini accettate, route.py indica 0.6 (80% su 10 immagini accettate), che invia 70 degli 80 numeri alla revisione. Questa è la risposta onesta: la soglia soddisfa il requisito di accuratezza, ma il modello non è ancora utile. Prima di scegliere una soglia per l'uso reale, addestra il modello più a lungo e ripeti la tabella.