Combina le attività in un'unica pipeline
Crea una cascata di rilevamento e classificazione, classifica ogni oggetto tracciato una sola volta invece che a ogni fotogramma e trasforma i keypoint di posa in serie temporali per persona.
I sistemi più utili oltre il rilevamento di solito usano due modelli, non uno. Un rilevatore individua ogni lavoratore e un classificatore determina se ogni casco è del tipo giusto; un modello di posa individua le articolazioni e un tracker le trasforma in una cronologia da cui puoi contare le ripetizioni. Il codice è breve. Ciò che mette in crisi questi sistemi è un dataset per la seconda fase che non corrisponde ai ritagli prodotti dalla prima fase e un costo che si moltiplica per ogni oggetto in ogni fotogramma: se eseguito in modo ingenuo, un flusso a 30 FPS con dieci persone richiede 300 classificazioni al secondo.
Pratico
Due schemi adatti alla maggior parte dei prodotti#
Entrambi partono dallo stesso fotogramma e dalla stessa API Ultralytics; differiscono per i dati usati dalla seconda fase. La selezione e la regolazione del tracker e la gestione dei flussi per il tracking degli oggetti sono trattate in Traccia oggetti con ByteTrack, BoT-SORT e TrackTrack; qui ci concentriamo sulla combinazione delle attività.
Rileva, poi classifica i ritagli#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)La procedura è corretta: i ritagli provengono da orig_img a piena risoluzione, nelle coordinate pixel usate dal rilevatore stesso, e il classificatore li elabora tutti con un'unica chiamata batch. Le etichette sono volutamente senza senso.
Il classificatore ImageNet non è mai stato addestrato su figure stradali ravvicinate e parzialmente ritagliate, quindi tira a indovinare: tieni presente che nessuna confidenza supera 0.50. Lo stesso succede a un classificatore addestrato su foto nitide di prodotti quando riceve ritagli sfocati del rilevatore.
Crea il dataset per la seconda fase a partire dai tuoi ritagli#
Il modo più affidabile per ottenere dati corrispondenti è lasciare che li produca il rilevatore:
- Esegui il rilevatore su riprese rappresentative con
save_crop=True, ad esempioyolo predict model=best.pt source=footage/ save_crop=True. I ritagli vengono salvati inruns/detect/predict/crops/<class>/. - Suddividi i ritagli di ogni classe nelle cartelle delle categorie specifiche (
helmet_ok/,helmet_missing/): è già la struttura per la classificazione vista nella lezione precedente. - Addestra il classificatore su quelle cartelle e convalidalo su ritagli acquisiti in un giorno diverso o con una telecamera diversa.
Dato che è stato il rilevatore a ritagliare le immagini, queste mantengono inquadratura, sfocatura e occlusioni reali — esattamente ciò che il classificatore vedrà in produzione — e il fine-tuning su di esse è una normale forma di transfer learning.
Classifica una sola volta per ID di tracking#
Un casco non cambia da un fotogramma all'altro, quindi classificare ogni riquadro di ogni fotogramma è uno spreco. Traccia i rilevamenti e classifica una sola volta ogni nuovo ID di tracking:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}Tre chiamate al classificatore anziché 33 in una clip di 11 fotogrammi; in un flusso lungo, il risparmio cresce a ogni fotogramma in cui una persona rimane visibile. Le etichette sono ancora predizioni basate su ImageNet: sostituiscile con il tuo classificatore ottimizzato e diventeranno le etichette per persona.
Classifica una sola volta per traccia quando l'attributo non può cambiare mentre l'oggetto è in vista (tipo di casco, marca del veicolo, SKU del prodotto). Riclassifica ogni N fotogrammi quando invece può cambiare (porta aperta, mano alzata). Se le prime rilevazioni tendono a essere piccole e sfocate, classifica il fotogramma in cui il riquadro della traccia è più grande.
Posa e tracking#
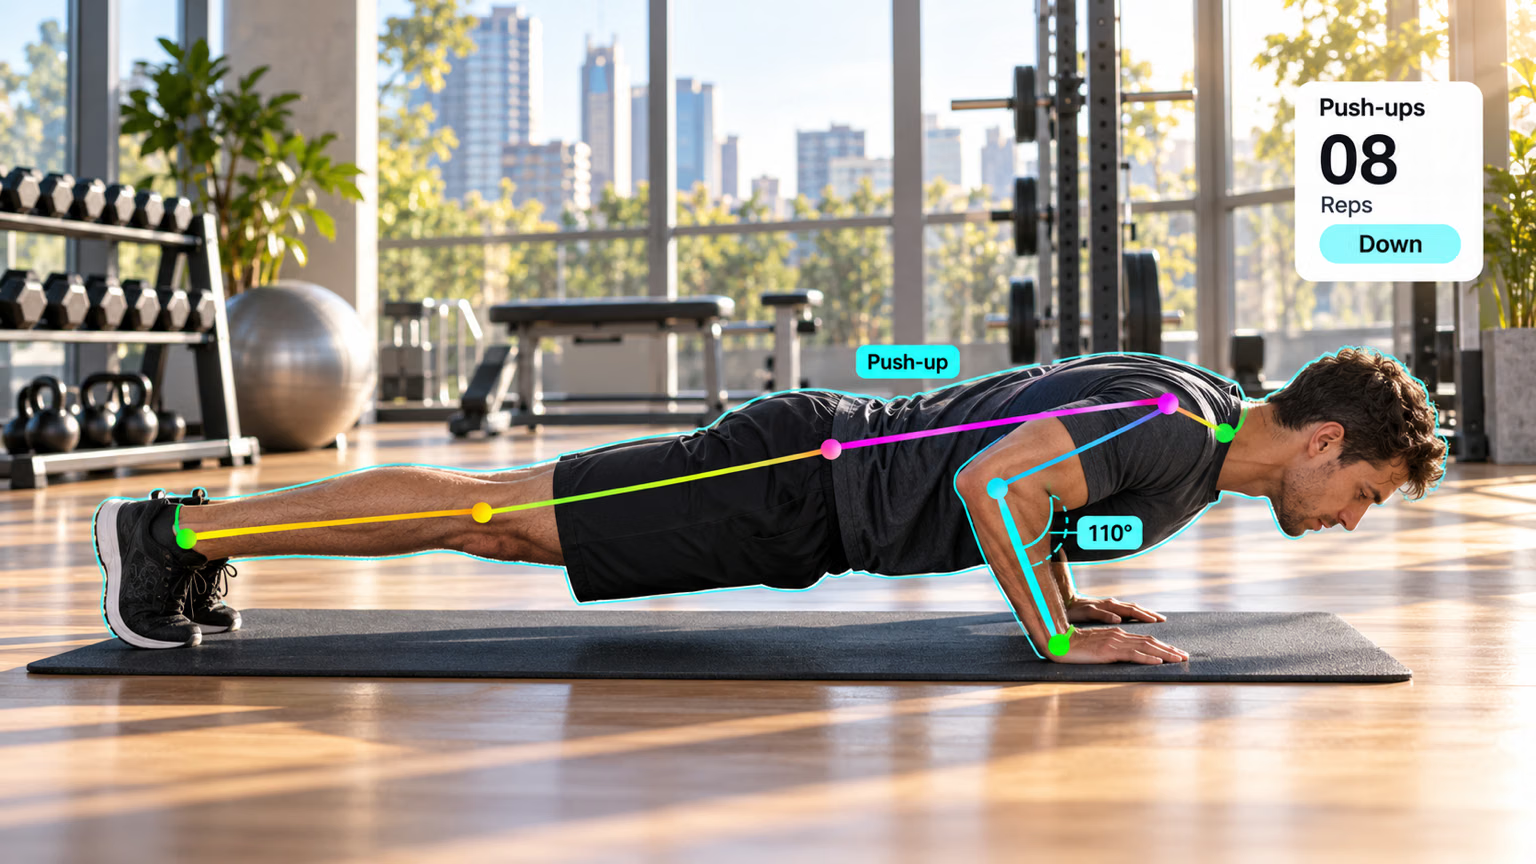
La modalità tracking aggiunge un result.boxes.id persistente per ogni persona, trasformando i keypoint in una serie temporale. Questo script registra l'angolo del ginocchio sinistro di ogni persona nello stesso breve video:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degIl ginocchio piegato dell'ID 2 corrisponde alla persona seduta nella clip; le altre due persone sono in piedi con le gambe dritte, a circa 180°. Da qui, puoi contare le ripetizioni rilevando l'attraversamento di soglie nella serie di ciascun ID: si scende sotto un angolo e poi si risale sopra un altro. È ciò che la soluzione di monitoraggio degli allenamenti fa per te.
Stima il costo della pipeline#
| Fattore che determina il costo | Rilevamento seguito da classificazione | Posa e tracking |
|---|---|---|
| Aumenta in base a | oggetti per fotogramma | fotogrammi |
| Leva principale | raggruppa i ritagli in batch; classifica una sola volta per ID di traccia e memorizza il risultato nella cache | riduci imgsz o vid_stride quando il movimento è lento |
| Modalità di errore | il classificatore vede ritagli diversi dai dati di addestramento | i cambi di ID dividono in due la cronologia di una persona |
Sintomo: il contatore delle ripetizioni si azzera a metà serie oppure una persona appare con due ID. Causa: il tracker ha perso la persona (occlusione, svolta rapida) e le ha assegnato un nuovo ID. Soluzione: ottimizza il tracker come nel corso sulla messa in produzione e fai in modo che la logica per ID tolleri brevi interruzioni: l'etichetta del classificatore memorizzata nella cache viene semplicemente ricalcolata per il nuovo ID.
Mostra la soluzione
Aggiungi save_crop=True alla chiamata del rilevatore:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]I ritagli compaiono in runs/detect/predict*/crops/person/ e crops/bus/ (il nome della cartella dell'esecuzione aumenta a ogni esecuzione di predizione). La memorizzazione nella cache per traccia ha richiesto 3 chiamate al classificatore per 33 riquadri di persone, con un risparmio di 30 chiamate in un clip di 11 frame.
Per contare gli angoli del ginocchio, sostituisci il ciclo finale di pose_track.py:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 degL'ID 2, la persona seduta, ha un angolo inferiore a 120° in tutti e 11 i frame; gli ID 1 e 3 non lo hanno mai.