Scegli l'attività e pianifica la pipeline
Associa ogni domanda sul prodotto a una delle sette attività Ultralytics YOLO, indicando pesi, campo dei risultati, formato delle etichette e metrica di soglia, e verifica il piano eseguendo ogni attività su un'immagine.
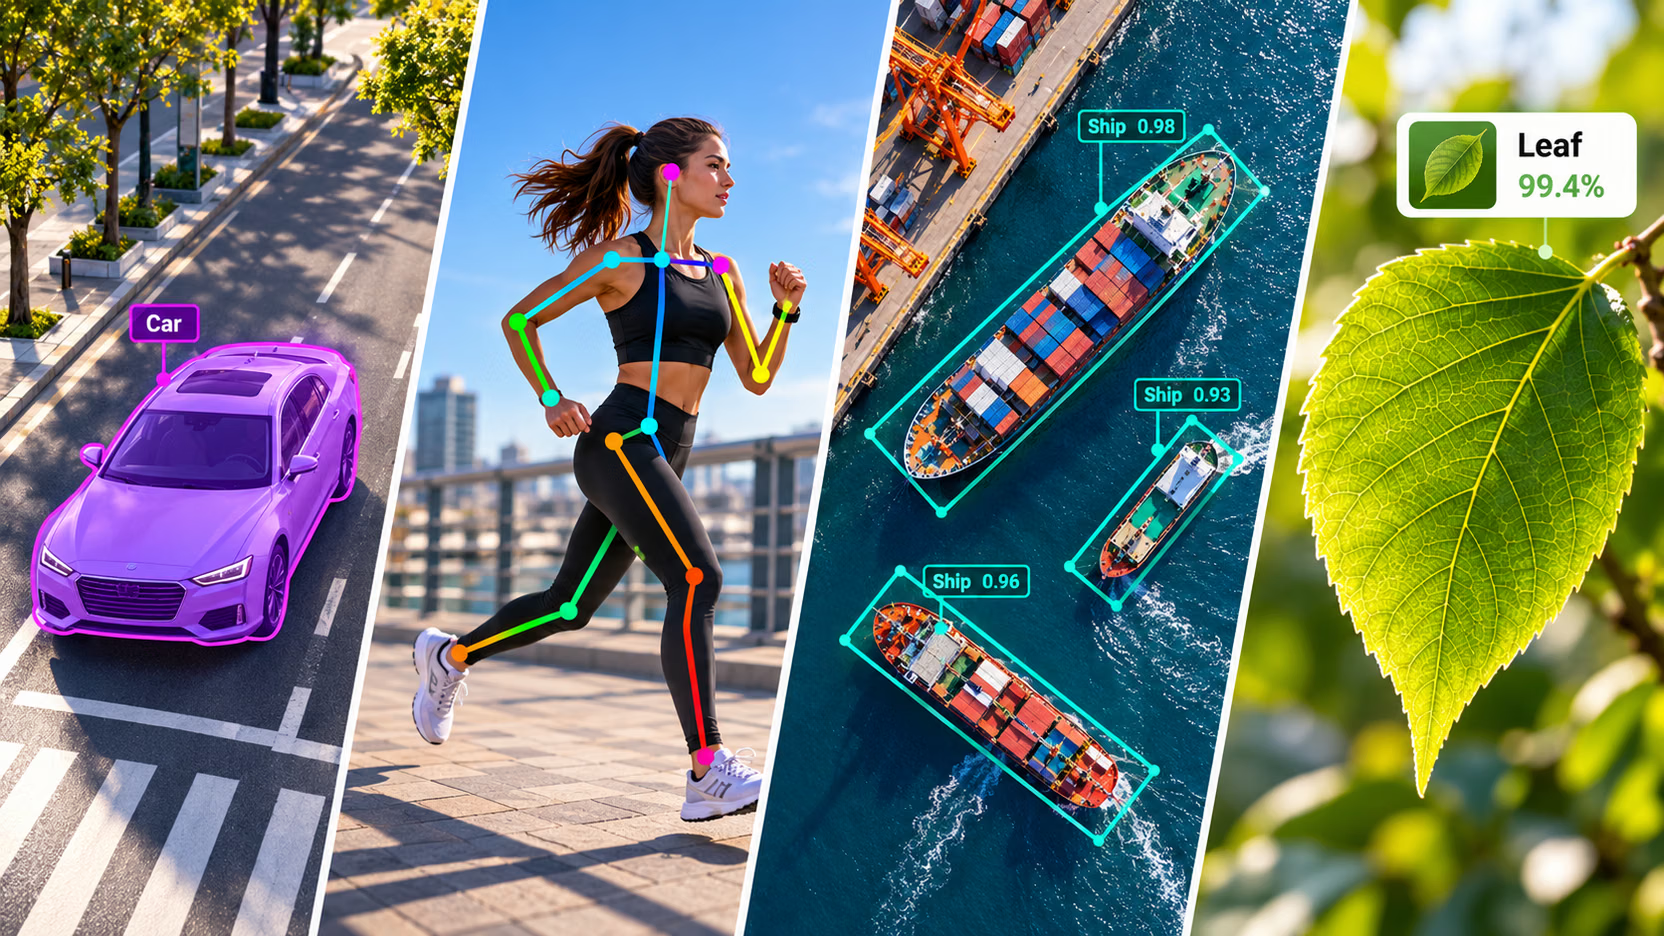
Quando un rilevatore viene rilasciato, le richieste successive raramente sono «più riquadri». Sono «quanto è grande la chiazza», «la schiena del lavoratore è piegata», «in che direzione punta la nave» e «questo componente è da scartare». Nella foto di strada usata in tutto il corso, la bounding box dell'autobus occupa il 48% dell'immagine, mentre l'autobus stesso ne copre il 29%; quindi una stima dell'area basata sul riquadro sarebbe sbagliata di oltre la metà. L'attività scelta determina il formato delle etichette: sceglierla prima che qualcuno inizi ad annotare è la decisione meno costosa del progetto; cambiarla in seguito significa ripetere le annotazioni.
Pratico
Una foto, quattro risposte diverse#

Poni una domanda su una foto — quanta parte di questa immagine è occupata dall'autobus e quanto è lontano? — e lascia che quattro attività Ultralytics YOLO rispondano:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraEsaminiamole una per una:
- detect risponde a dove. Il riquadro include anche la strada sotto l'autobus e le quattro persone davanti a esso, quindi l'area risulta sovrastimata del 63%.
- segment risponde a che forma. Il 29,2% è l'effettiva impronta dell'autobus nell'immagine: il valore da usare per qualsiasi regola relativa ad area, copertura o sovrapposizione.
- semantic risponde a quali pixel appartengono a quale classe. L'area è simile a quella della maschera, ma il modello definisce l'autobus
train: assegna alle superfici le classi del proprio set di addestramento (Cityscapes, lezione 4) e non distingue mai un veicolo dall'altro. - depth risponde a a che distanza. La profondità mediana all'interno della maschera dell'autobus è di 4,5 m: due attività combinate per rispondere a una domanda a cui nessuna delle due potrebbe rispondere da sola.
Se il valore restituito dal tuo prodotto è un'area, una percentuale di copertura o una sovrapposizione, un riquadro non è lo strumento giusto. Usa una maschera (segmentazione) per gli oggetti oppure una mappa di classi (semantica) per le superfici.
Panoramica dei sette task#
Fondamenti di Computer Vision spiega nel dettaglio come scegliere tra le attività: se la scelta non è ovvia, ripassa Le sette attività di visione. Questo è il riepilogo operativo per il resto del corso. Ogni riga corrisponde a un'attività che il pacchetto ultralytics installato addestra, convalida, usa per le previsioni ed esporta tramite la stessa API; la panoramica delle attività è il riferimento completo.
| Domanda a cui risponde l'output | Task | Pesi YOLO26 | Campo dei risultati | Formato delle etichette | Metrica di soglia |
|---|---|---|---|---|---|
| Dove si trova ogni oggetto? | detect | yolo26n.pt | boxes | classe + riquadro | mAP50-95 dei riquadri |
| Qual è la forma e l'area esatta di ogni oggetto? | segment | yolo26n-seg.pt | masks + boxes | classe + poligono | mAP50-95 delle maschere |
| A quale classe appartiene ogni pixel? | semantic | yolo26n-sem.pt | semantic_mask | Mappa di classi PNG o poligoni | mIoU |
| Dove si trovano le articolazioni o i punti di riferimento? | pose | yolo26n-pose.pt | keypoints + boxes | classe + riquadro + punti chiave | mAP50-95 delle pose (OKS) |
| Come è ruotato ogni oggetto? | obb | yolo26n-obb.pt | obb | classe + 4 vertici | mAP50-95 OBB |
| Che cos'è l'intera immagine (o ritaglio)? | classify | yolo26n-cls.pt | probs | una cartella per classe | accuratezza top-1 |
| A quale distanza dalla fotocamera si trova ogni pixel? | depth | yolo26n-depth.pt | depth | mappa di profondità per immagine (PNG a 16 bit o NPY) | δ1 (delta1) |
Hai già messo in produzione la prima riga. Le lezioni dalla 2 alla 8 insegnano le cinque righe centrali, mentre le lezioni 9 e 10 le concatenano e le mettono in produzione. L'ultima riga, la stima della profondità monoculare, prevede una distanza in metri per ogni pixel di una singola immagine. Le etichette provengono da sensori di profondità o renderer 3D, non da annotatori, quindi ha un proprio formato del dataset; il corso la include nei punti in cui il flusso di lavoro è condiviso: questo piano, il ciclo di convalida e il controllo dell'esportazione nell'ultima lezione.
Scegli una domanda alla volta#
Esamina le domande nell'ordine e fermati alla prima risposta affermativa:
Il diagramma copre i casi più comuni. Quattro criteri per dirimere i casi dubbi coprono gran parte degli altri:
| Se la richiesta… | Scegli | Perché |
|---|---|---|
| richiede sia un conteggio sia un'area («quante chiazze ci sono e quanto sono grandi») | segment | la segmentazione semantica unisce gli oggetti a contatto in un'unica regione |
| riguarda oggetti lunghi e sottili, disposti uno accanto all'altro e ripresi dall'alto | obb | i riquadri allineati agli assi si sovrappongono e la NMS elimina oggetti reali, anche se non leggi mai l'angolo |
| richiede di distinguere la parte anteriore da quella posteriore o la sinistra dalla destra | pose | un OBB fornisce un asse, non una direzione |
| per costruzione, mostra esattamente un elemento per immagine (una stazione di ispezione fissa) | classify | le etichette meno costose e il modello più veloce |
L'attività viene definita quando crei il dataset — su Ultralytics Platform corrisponde al campo Tipo di attività della finestra di dialogo Nuovo dataset — quindi questa scelta va fatta prima della prima annotazione:

Una API, sette campi dei risultati#
Tutte le attività usano la stessa chiamata; il modello ricava l'attività dal file dei pesi. Cambia il campo dei risultati che viene compilato: è quello che leggerà il tuo codice.
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']I risultati di segmentazione e pose mantengono boxes, quindi il codice di rilevamento che hai già continua a funzionare anche con loro. I risultati di classificazione, semantica e profondità descrivono l'intera immagine e non hanno campi per singolo oggetto.
Il codice di rilevamento che scorre result.boxes si interrompe con TypeError: 'NoneType' object is not iterable su un modello OBB: result.boxes è None e le rilevazioni ruotate si trovano solo in result.obb. Adatta il codice di rilevamento a OBB leggendo result.obb, invece di controllare None e ottenere zero rilevazioni.
Quando un modello non basta#
La maggior parte dei sistemi di produzione che vanno oltre il rilevamento adotta una di queste tre strutture:
- Rileva, poi classifica. Il rilevatore trova gli oggetti piccoli in un'immagine grande; un classificatore di immagini assegna un'etichetta dettagliata a ogni ritaglio a piena risoluzione: tipo di casco, livello del difetto, codice SKU del prodotto.
- Pose e tracking. I punti chiave descrivono un singolo fotogramma; un tracker li trasforma in una serie temporale per persona, da cui puoi contare le ripetizioni o rilevare le cadute.
- Segmenta, poi misura. Il modello restituisce i pixel; il normale codice li converte in aree, larghezze, rapporti di copertura o distanze (con la profondità).
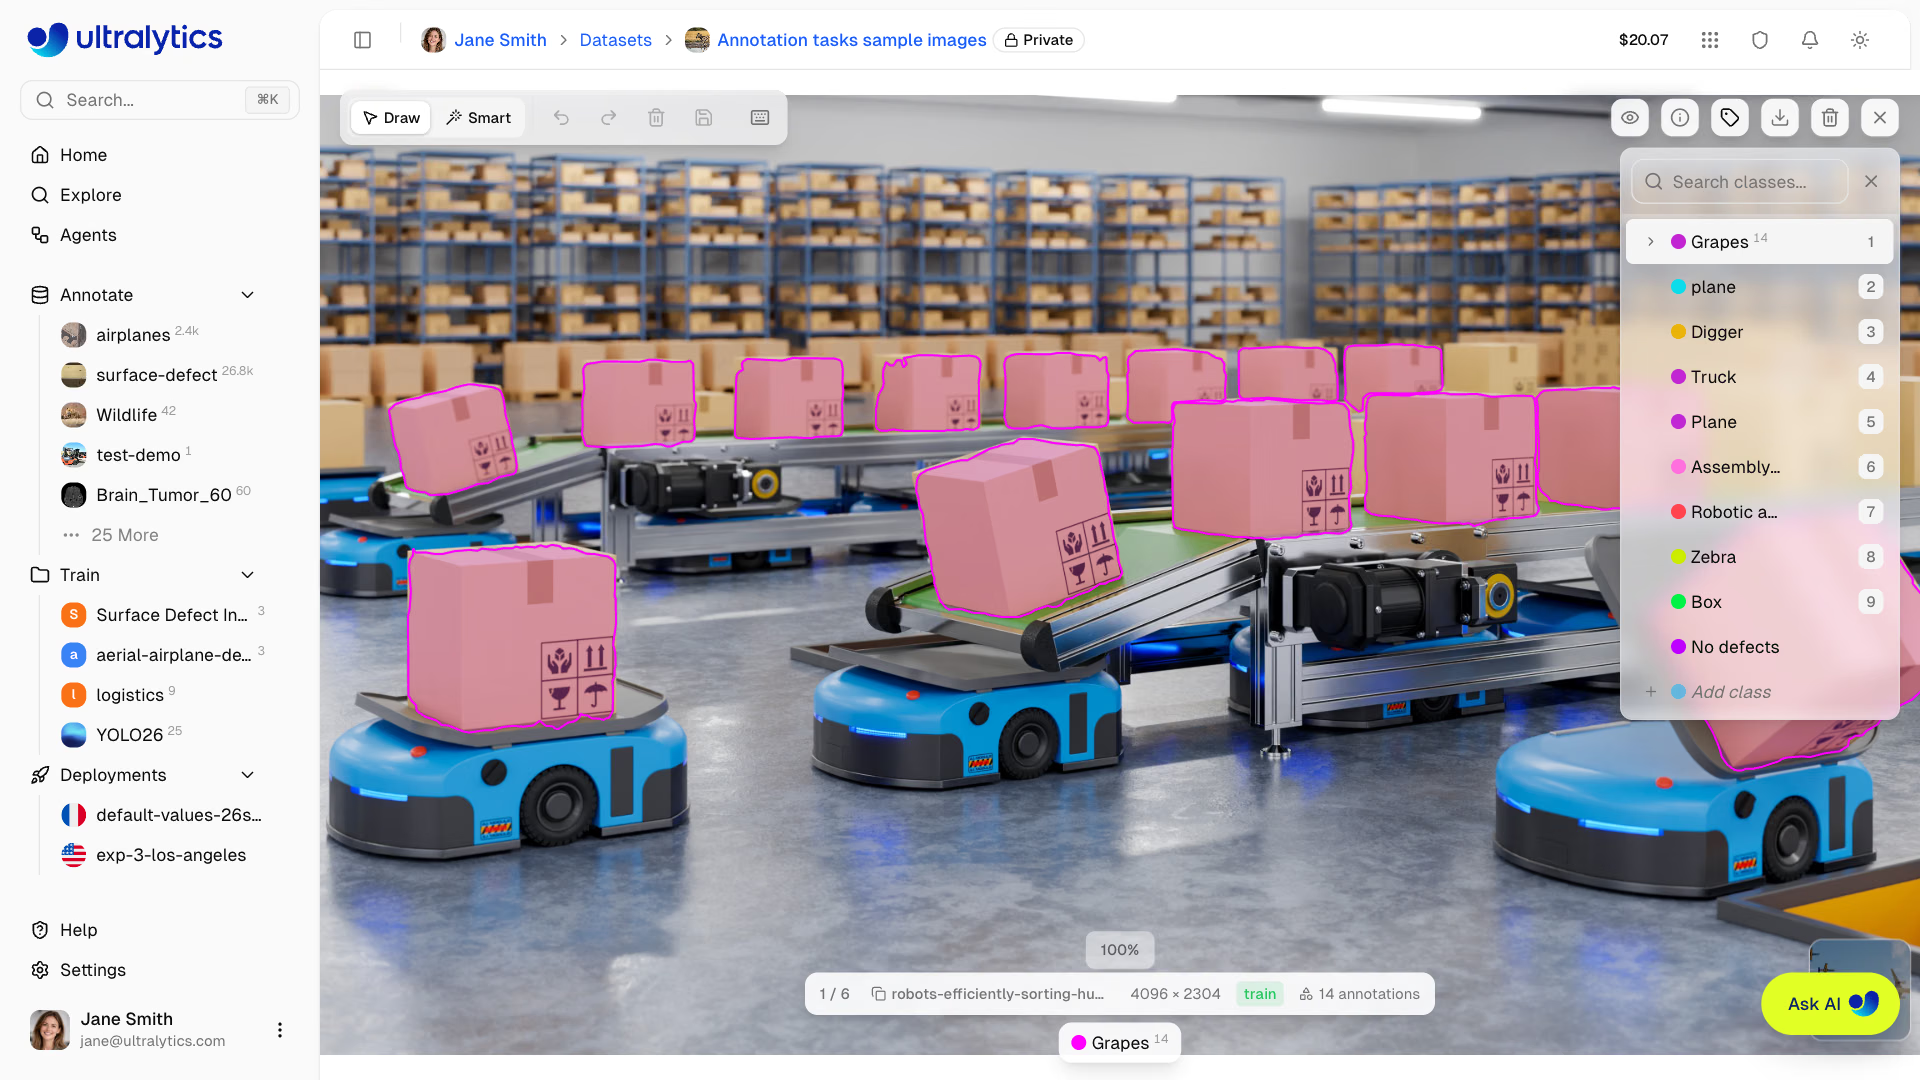
Le etichette di una pipeline di segmentazione e misurazione consistono in un poligono per oggetto, come per questi pacchi sui robot da magazzino nell'editor di Ultralytics Platform:
Un secondo modello aggiunge latenza di inferenza, un secondo dataset da etichettare e gestire e un secondo modello da monitorare. Crea una catena solo quando un singolo task non può rispondere alla domanda: un piano con un modello che puoi distribuire è meglio di un piano con tre modelli che non puoi etichettare.
Insidie#
Sintomo: il team etichetta poligoni perché le maschere fanno bella figura nelle demo, ma poi il prodotto legge solo un conteggio. Soluzione: prima di etichettare, individua la riga di codice che usa il risultato. Se nessun componente utilizza il contorno, distribuisci un rilevatore: i riquadri sono più rapidi da etichettare e da elaborare.
Sintomo: dopo un mese di etichettatura, qualcuno si accorge che il prodotto ha bisogno di un orientamento e il dataset contiene etichette OBB, che forniscono solo un asse. Soluzione: inserisci nel piano l'attributo esatto (result.masks.xy, result.keypoints.xy, result.obb.xywhr) ed esegui tasks.py con i pesi scelti prima di creare la prima etichetta.
Sintomo: un classificatore con un punteggio del 95% su foto pulite dei prodotti sbaglia la maggior parte dei ritagli del rilevatore in produzione. Soluzione: crea il dataset della seconda fase usando i ritagli prodotti dalla prima fase, con il loro effettivo sfocato e inquadramento; la lezione 9 spiega come.
Mostra la soluzione
Per la richiesta sui pallet:
| Voce | Scelta |
|---|---|
| Domanda | Una parte del pallet sporge oltre la linea della trave della scaffalatura? |
| Task | segment — la sporgenza dipende dal contorno del pallet; il riquadro include anche lo spazio sotto il pallet e il carico sopra di esso |
| Pesi | yolo26n-seg.pt, perfezionato su fotogrammi ripresi dalle telecamere del magazzino |
| Formato delle etichette | Un poligono per pallet |
| Campo dei risultati | result.masks.data con retina_masks=True (pixel oltre la linea della trave) |
| Metrica di soglia | mAP50-95 delle maschere su una telecamera esclusa dall'addestramento |
| Seconda fase | Nessuno — la linea del fascio è fissa per ogni telecamera, quindi è una configurazione, non un modello |
La regola dello sbalzo richiede quindi tre righe di codice: traccia la linea del fascio una volta per telecamera, conta i pixel della maschera dal lato sbagliato e genera un avviso se superano una soglia di pixel che calibri su alcuni sbalzi noti. La lezione 3 mostra proprio questo tipo di test tra maschera e regione.