Ottimizzazione di costi e latenza
Esegui la profilazione dell'intera pipeline, aziona nell'ordine le leve che incidono davvero su latenza e costo e fermati al raggiungimento del budget.
I team perdono settimane per limare millisecondi al modello, mentre il vero collo di bottiglia è una scrittura sul database o un decoder RTSP. Le leve principali sono poche e ben misurate: YOLO26s impiega 2.2 volte più tempo di YOLO26n su CPU per ottenere 7.7 punti mAP in più, mentre eseguire il rilevamento un fotogramma sì e uno no dimezza il lavoro. In questa lezione imparerai a eseguire prima la profilazione, azionare la leva più efficace tra quelle adatte e fermarti al budget che hai stabilito in anticipo.
Pratico
Misura prima l'intera pipeline#
Ogni oggetto Results suddivide il proprio tempo in fasi:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameQui l'inferenza occupa il 95% del tempo del modello, quindi le leve relative al modello saranno utili. Misura allo stesso modo i tempi di decodifica e di output della tua pipeline (inserendo time.perf_counter() attorno a ciascuna fase), poi applica la regola corrispondente a ciò che rilevi:
| Misurazione | Primo intervento |
|---|---|
| 60 ms per decodificare RTSP, 5 ms per l'inferenza | Decodifica hardware, risoluzione inferiore del flusso o più thread del decoder |
| 30 ms per l'inferenza, 100 ms per la post-elaborazione in Python | Vettorizza con NumPy o sposta l'elaborazione in un processo worker |
| 5 ms per l'inferenza, 200 ms per le scritture sul database | Raggruppa le scritture o rendile asincrone |
| L'inferenza è il fattore dominante | La classifica delle leve qui sotto |
La classifica delle leve#
Prova le opzioni partendo dall'alto e fermati quando raggiungi il budget:
| Soluzione | Aumento di velocità tipico | Costo tipico in termini di precisione |
|---|---|---|
| Modello più piccolo (m → s, s → n) | 1.5–2.5× | 4.5–7.7 punti mAP su COCO; meno nei task specifici |
imgsz più piccolo (640 → 480) | circa 1.8× | Prima gli oggetti piccoli e lontani |
| Runtime più veloce, FP16 | circa 1.5× su GPU | Di solito nessuno; verifica la parità |
| INT8 con calibrazione | un ulteriore 1.2× su GPU; fino a 2.9× su CPU | 1 punto (YOLO26n) fino a 4–6 punti (modelli più grandi); QAT recupera gran parte della perdita |
Meno fotogrammi (vid_stride=N) | fino a N× | Si possono perdere oggetti veloci ed eventi brevi |
| Batch più grande (server) | Più throughput, non meno latenza | Nessuna |
I valori provengono dalle tabelle dei benchmark di YOLO26, TensorRT e OpenVINO, oltre che dalle misurazioni qui sotto; i tuoi risultati saranno diversi, quindi misura.
Modello più piccolo#
La tabella dei benchmark di YOLO26 su COCO:
| Modello | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
Su CPU, ogni passaggio al modello più piccolo è 2.2–2.5× più veloce. La differenza di precisione su COCO rappresenta il caso peggiore: un rilevatore per magazzino a 3 classi con oggetti grandi di solito perde molto meno passando da m a n rispetto a un rilevatore generalista a 80 classi, quindi vale sempre la pena provare il modello più piccolo sul proprio set di convalida.
Input più piccolo#
Il calcolo aumenta all'incirca in proporzione al numero di pixel, quindi imgsz=480 richiede circa il 56% del lavoro rispetto a 640. Misurazione eseguita sulla CPU del laptop di prova con ONNX Runtime e batch 1 (mediana di 25 esecuzioni su bus.jpg):
| Modello | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Criterio decisionale: se l'oggetto importante più piccolo occupa ancora circa 10 pixel o più alla nuova dimensione, prova questa opzione; se gli oggetti sono piccoli o lontani (droni, scaffali distanti dalla telecamera), mantieni la risoluzione e riduci il modello.
Meno fotogrammi#
Se l'inferenza limita il frame rate e la scena si muove lentamente, esegui il rilevamento a ogni N-esimo fotogramma con vid_stride=N e lascia che il tracker colmi gli intervalli:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsUsare la metà dei fotogrammi richiede circa la metà del tempo e il tracker ha mantenuto 30 identità su 32. Con vid_stride=3 ne ha perse 4: per questa scena con persone che camminano, è il segnale che indica di fermarsi.
Riduci i costi del cloud#
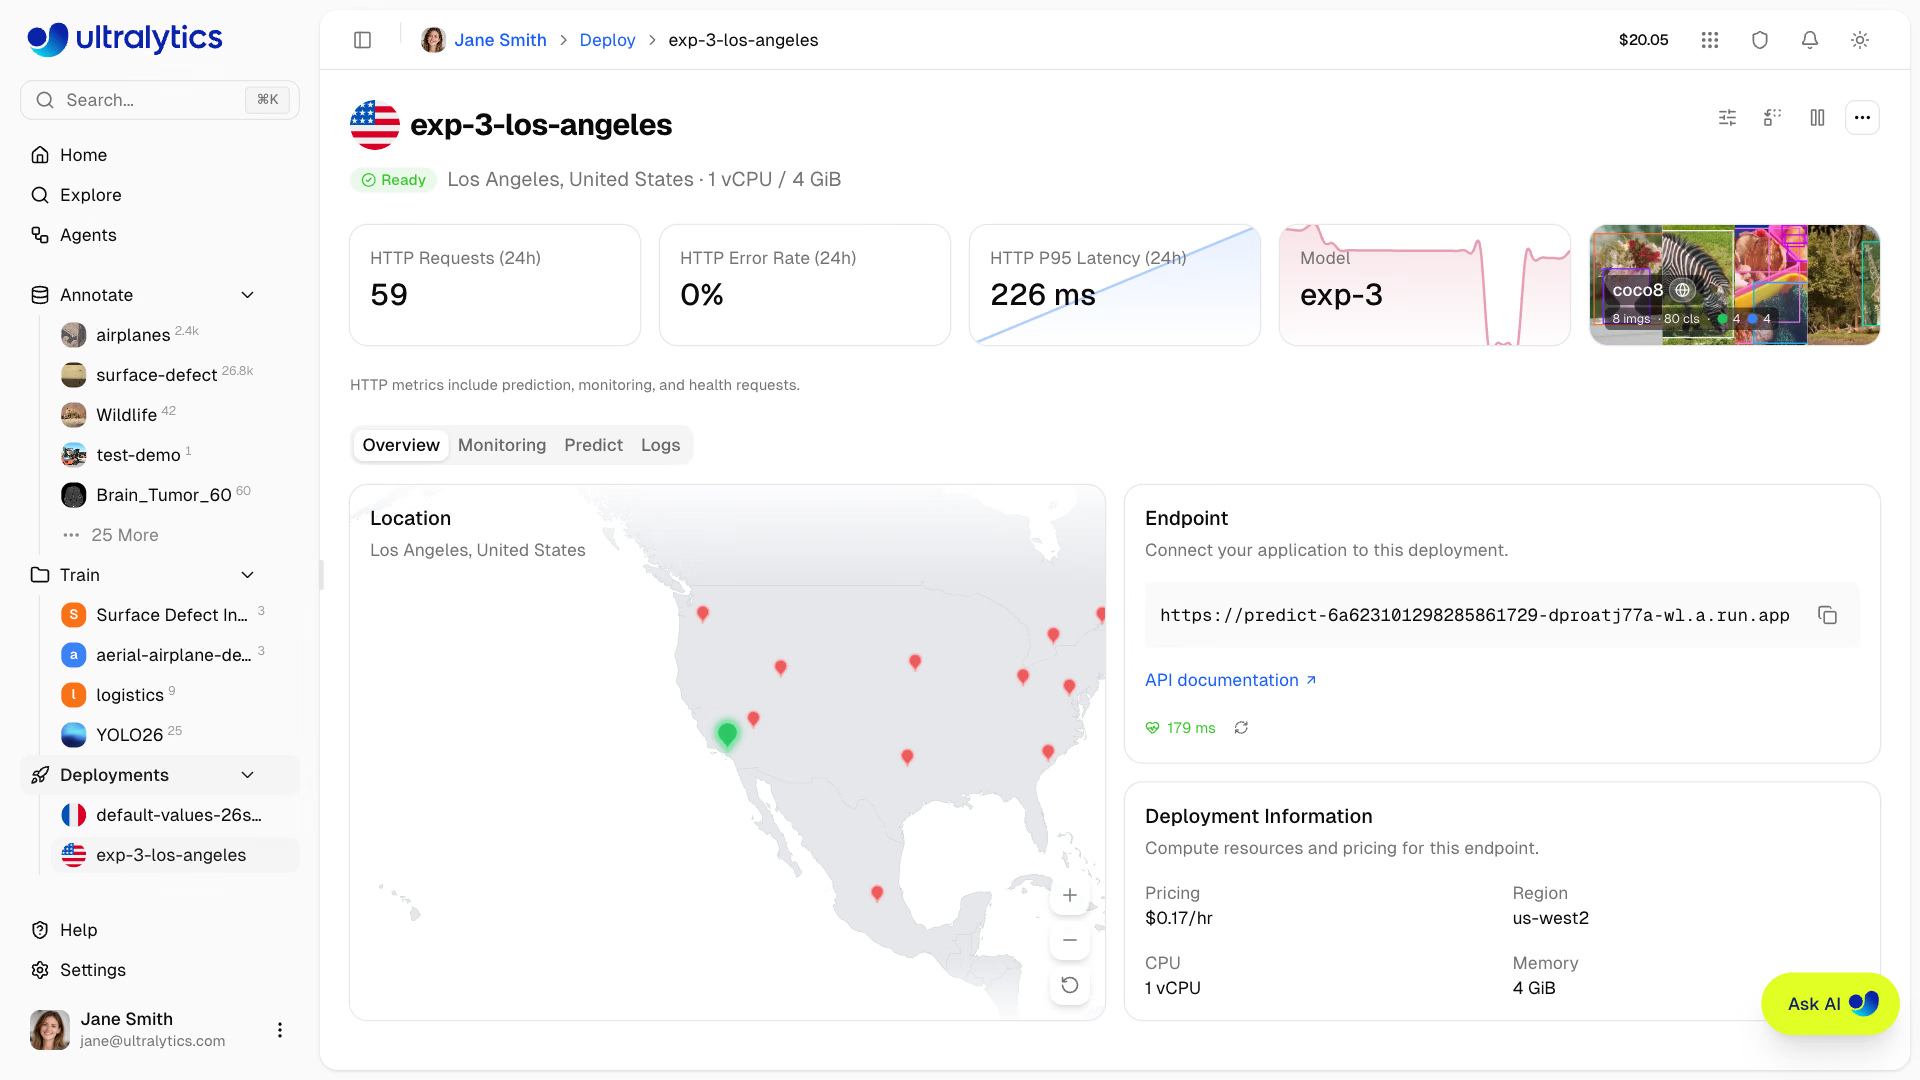
Il costo è dato dalle ore di utilizzo dell'istanza divise per il lavoro utile. Una scheda come questa mostra i due valori che ti servono: il costo orario ($0.17 per 1 vCPU e 4 GiB in questo caso) e il lavoro svolto (59 richieste in 24 ore a una latenza P95 di 226 ms: un endpoint perlopiù inattivo). Poi:
- Aumenta l'utilizzo. Una GPU con un utilizzo del 30% spreca il 70% della spesa. Raggruppa i flussi (come spiegato nelle lezioni precedenti) o servi le richieste tramite Triton Inference Server.
- Scegli la dimensione giusta. Esegui benchmark su una GPU più piccola o su una CPU con OpenVINO prima di dare per scontato di averne bisogno di una grande.
- Usa capacità spot o prerilasciabile per i job batch. La rielaborazione di video archiviati tollera le interruzioni; i flussi live no.
Insidie#
Sintomo: due settimane di ottimizzazione hanno fatto risparmiare 10 ms, ma il sistema è ancora lento. Soluzione: analizza prima le prestazioni dell'intera pipeline e intervieni sullo stadio più lento, qualunque esso sia.
Sintomo: inserire if i % 2: continue nel ciclo dei risultati non fa risparmiare nulla. Soluzione: il modello ha già elaborato quel fotogramma; salta i fotogrammi alla sorgente con vid_stride.
Sintomo: il throughput è aumentato, ma ora ogni fotogramma arriva più tardi. Soluzione: batch più grandi aumentano il throughput per dollaro, non riducono la latenza per fotogramma; usali per molti flussi o per processi offline, non per una singola telecamera in tempo reale.
Quando hai esaurito le leve di ottimizzazione del modello, il passo successivo è migliorare i dati. Un dataset che rispecchia la produzione permette a un modello più piccolo di raggiungere l'accuratezza che prima richiedeva un modello più grande: costi inferiori senza perdita di accuratezza.
Mostra la soluzione
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Ogni riga esclude le prime cinque esecuzioni come fase di riscaldamento e riporta la mediana delle restanti. Scegli la prima riga che rispetta il budget di latenza con una perdita di mAP entro il limite stabilito. Un esempio di budget concreto: "due giorni, al massimo 1 punto di mAP, 20 FPS sul computer del negozio". Se yolo26s a 640 supera i 50 ms per frame e yolo26n a 640 rispetta il limite entro 1 punto sul tuo set di validazione, fermati lì; non dedicare il secondo giorno alla risoluzione 480.