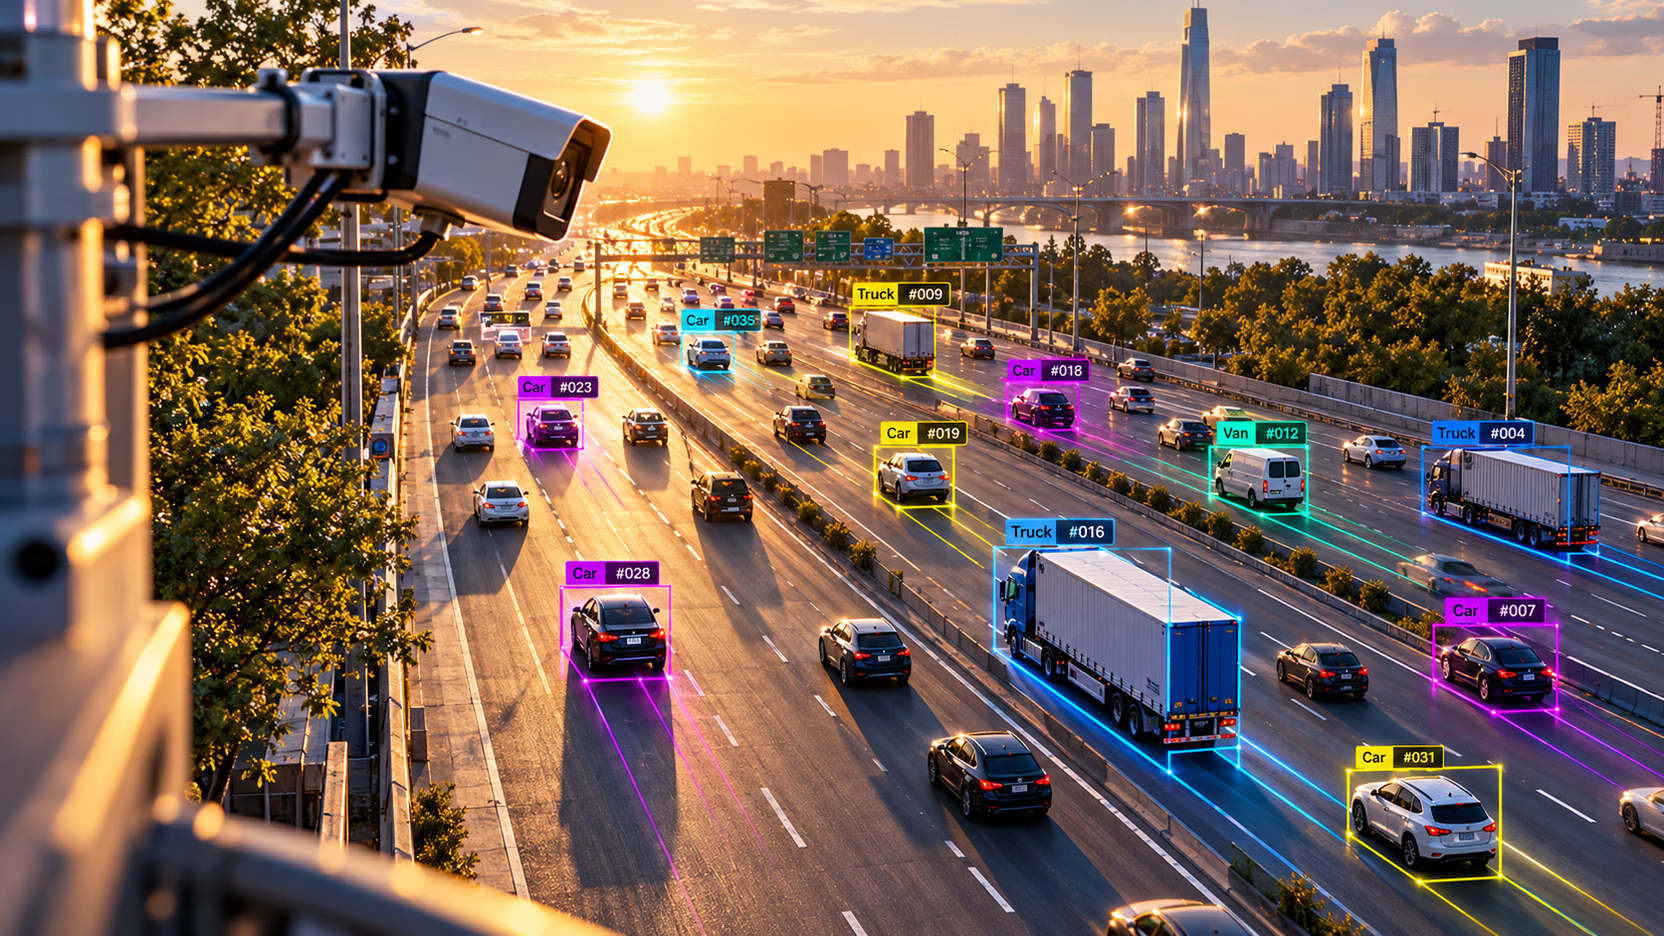
Ultralytics YOLO in produzione
Porta in produzione un modello Ultralytics YOLO addestrato: scegli un runtime, esportalo e verifica il risultato, ottimizzalo per il tuo hardware, traccia gli oggetti, crea pipeline di conteggio, gestisci molti flussi e rileva il drift prima che se ne accorgano gli utenti.
Di Ultralytics Academy
Distribuisci un modello YOLO26 sul runtime più adatto con parità verificata, trasforma i rilevamenti in ID tracciati e conteggi su molti flussi e strumentalo in modo che i problemi di latenza, accuratezza e drift ti vengano segnalati prima che gli utenti se ne accorgano.
Scegli un runtime e il valore di
format=in base al dispositivo, al budget di latenza e alla flotta, quindi verifica la scelta con benchmark ripetuti.Esporta in ONNX e dimostra la parità con PyTorch, includendo il problema del letterbox a forma statica.
Scegli tra FP32, FP16 e INT8 su TensorRT e OpenVINO, con dati di calibrazione e una soglia minima di accuratezza.
Traccia gli oggetti con ByteTrack, BoT-SORT o TrackTrack e regola le soglie del tracker in base alle confidenze del tuo rilevatore.
Crea contatori di attraversamento linea, occupazione delle zone, mappe di calore e stime di velocità calibrate basandoti sul tracking.
Gestisci diversi flussi video tramite un solo modello, usando inferenza in batch, code con limiti definiti e perdita di fotogrammi misurata.
Registra le metriche per fotogramma, rileva il drift delle confidenze con un test KS e scegli l'intervento meno costoso per ridurre latenza e costi.
Una decisione sul runtime per il tuo dispositivo, supportata da benchmark ripetuti confrontati con un budget in millisecondi.
Un'esportazione ONNX con controllo di parità registrato (riquadri, confidenze e mAP) rispetto al modello PyTorch.
Un'esportazione ottimizzata (OpenVINO o TensorRT) che ha superato una soglia di mAP e latenza sull'hardware di destinazione.
Una pipeline di conteggio con una linea di conteggio, il conteggio di una zona, una mappa di calore e una stima di velocità calibrata su video reali.
Un worker multi-stream che elabora in batch i fotogrammi di diverse telecamere e comunica i fotogrammi elaborati e persi per ogni flusso.
Un ciclo di monitoraggio: metriche JSON per fotogramma, un test KS per il drift delle confidenze e una validazione settimanale su un set di controllo.
Un modello addestrato, ad esempio
runs/detect/pills_v1/weights/best.ptda Addestra il tuo primo modello YOLO, oppure il checkpoint preaddestratoyolo26n.ptper seguire gli esempi.Python 3.10+ con
pip install "ultralytics[solutions]" onnxruntime scipy(solutions aggiunge shapely e lap).Dimestichezza con Python, la riga di comando e le sorgenti video (file, webcam, RTSP).
Consigliato: completa prima Addestra il tuo primo modello YOLO e Creazione di dataset YOLO ad alte prestazioni.
Contenuti del corso
4 moduli · 9 lezioniModulo 1
Scegli una destinazione di distribuzione
Individua un runtime e un formato di esportazione a partire dal dispositivo, dal budget di latenza e dalla flotta, quindi verifica la scelta sul dispositivo.
Esportare in ONNX (e verificare la parità)
Esporta un modello ONNX portabile, poi dimostra che corrisponde a PyTorch per bounding box, confidence e mAP prima di distribuire qualsiasi cosa.
Modulo 2
Modulo 3
Traccia gli oggetti con ByteTrack, BoT-SORT e TrackTrack
Assegna a ogni oggetto un ID stabile tra i fotogrammi, scegli un tracker e regola le sue soglie in base al tuo rilevatore.
Conteggi, mappe di calore e stima della velocità
Crea contatori di attraversamento, conteggi di occupazione delle zone, mappe di calore e stime della velocità basati sul tracciamento, e calibrali in modo rigoroso.
Modulo 4
Inferenza multi-stream
Elabora più telecamere con un solo modello usando inferenza a batch, code con capacità limitata e monitoraggio dei frame persi.
Osservabilità e deriva
Registra le metriche che rivelano il calo silenzioso della precisione, verifica la deriva con le distribuzioni di confidenza e invia avvisi solo per segnali che richiedono un'azione.
Ottimizzazione di costi e latenza
Esegui la profilazione dell'intera pipeline, aziona nell'ordine le leve che incidono davvero su latenza e costo e fermati al raggiungimento del budget.