Inferenza multi-stream
Elabora più telecamere con un solo modello usando inferenza a batch, code con capacità limitata e monitoraggio dei frame persi.
Un sistema che riesce a gestire una telecamera può accumulare minuti di ritardo con quattro telecamere senza che si verifichi alcun arresto anomalo: i risultati arrivano semplicemente sempre più tardi, finché la memoria non si esaurisce. Con la CPU del laptop usato qui, uno stream a 30 FPS ha retto il passo, quattro hanno perso metà dei frame e otto ne hanno persi più di due terzi. In questa lezione realizzerai la pipeline che misura questi dati, perché servono per dimensionare l'hardware.
Pratico
Dove finisce il tempo#
Ogni frame attraversa quattro fasi:
| Fase | Costo tipico | Esecuzione |
|---|---|---|
| Decodifica (RTSP o file → array) | 5–20 ms per frame a 1080p | CPU |
| Preelaborazione (letterbox, normalizzazione) | circa 1 ms | CPU |
| Inferenza | da pochi ms (GPU) a decine di ms (CPU) | Acceleratore |
| Postelaborazione, tracciamento, sink | pochi ms, di più con database lenti | CPU |
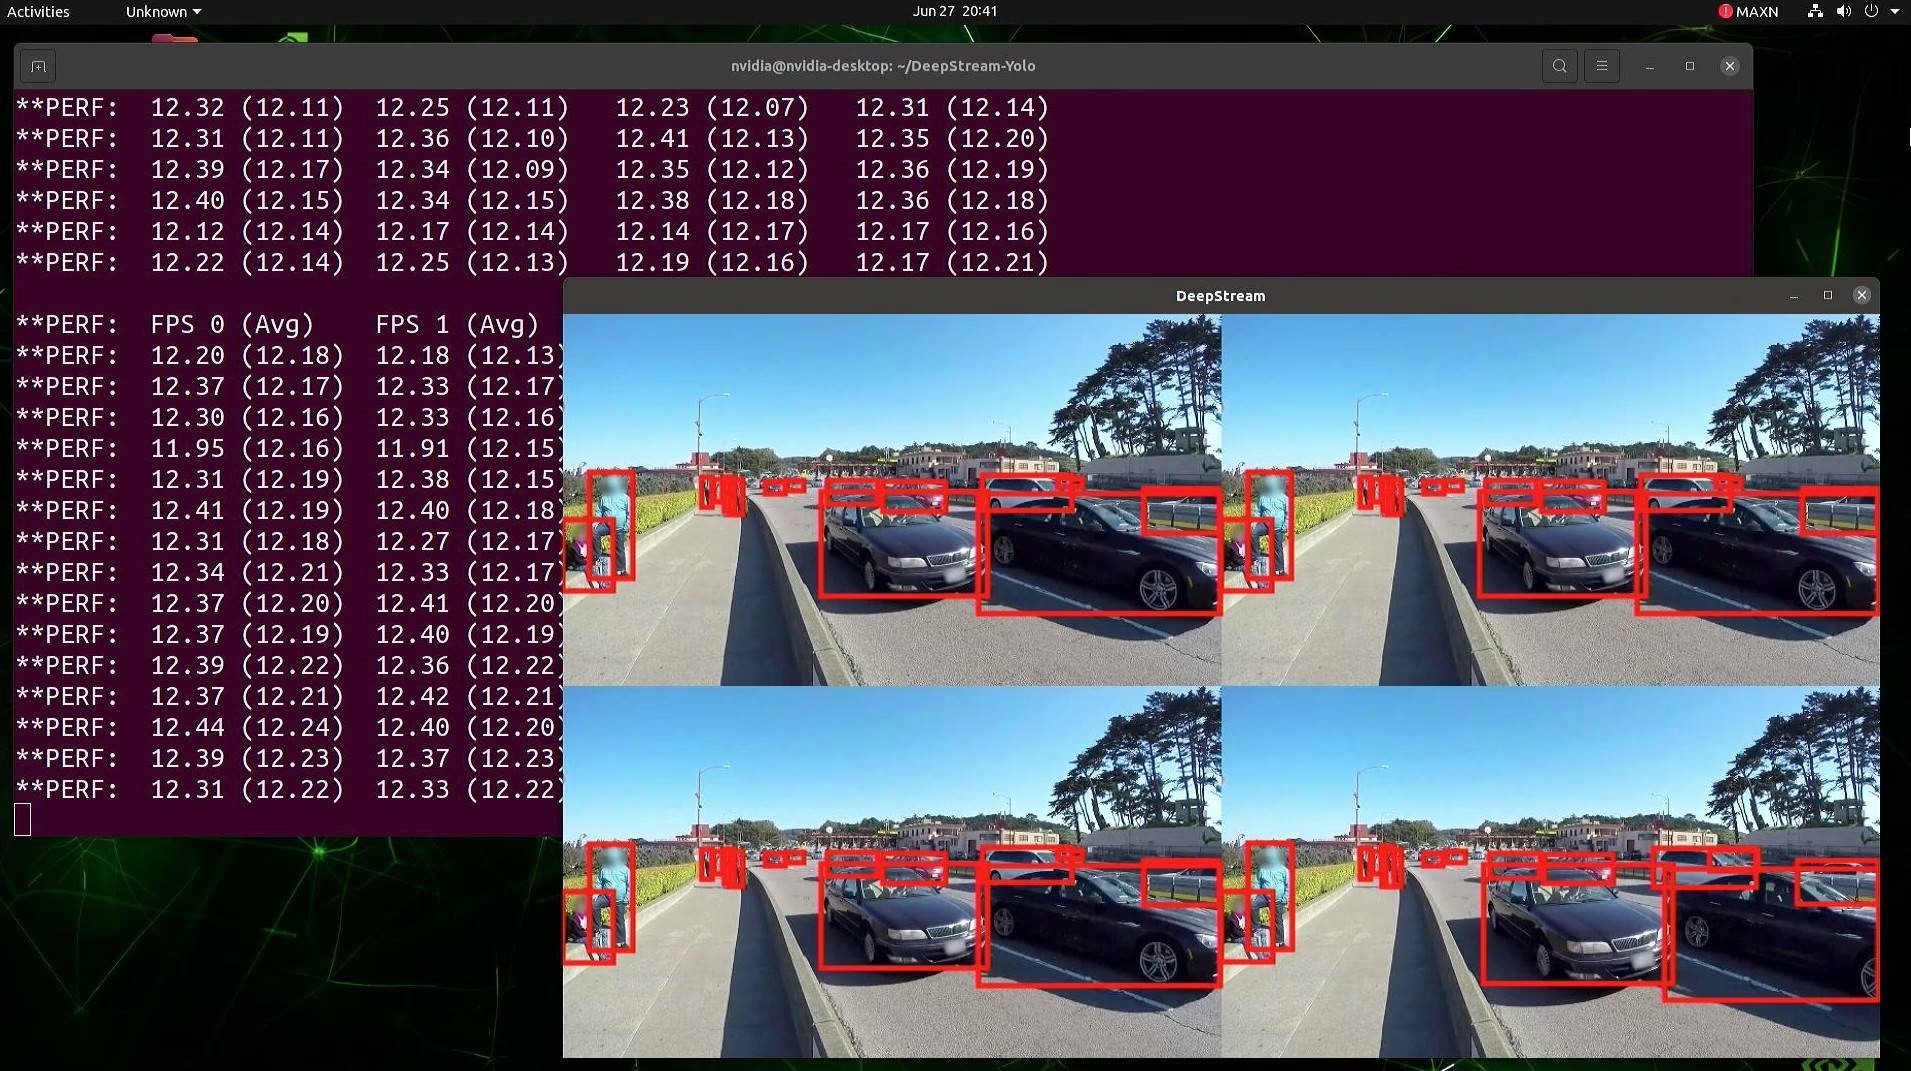
Esegui le fasi una dopo l'altra, telecamera per telecamera, in un solo thread, e l'acceleratore resta inattivo mentre i frame vengono decodificati. La soluzione è separare le fasi, come fa la pipeline DeepStream qui sopra: quattro stream condividono un dispositivo e ciascuno riporta i propri FPS (circa 12 in questo caso). La stessa struttura in Python:
Integrato: un file .streams#
Ultralytics raggruppa più sorgenti in batch per te. Inserisci una sorgente per riga in un file .streams e passalo a Predict o alla modalità Track. Ogni stream ha il proprio thread di lettura e tracker, mentre a ogni iterazione viene eseguito un unico forward pass in batch su tutti gli stream:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # produzione: un URL rtsp:// per riga

model = YOLO("yolo26n.pt")  # usa in produzione la tua esportazione ottimizzata
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path indica da quale stream proviene questo risultato
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Entrambi gli stream hanno prodotto 62 risultati perché l'iterazione si interrompe quando termina lo stream più corto (la clip dell'aeroporto ha 150 frame). stream_buffer=True ha elaborato ogni frame, scelta corretta per i file registrati; con le telecamere in diretta, mantieni l'impostazione predefinita False, così un modello lento salta i frame obsoleti invece di accumulare ritardo. Abbina questa soluzione a un'esportazione TensorRT o OpenVINO per ottenere il massimo throughput per stream.
Personalizzata: produttore-consumatore con contatori dei frame persi#
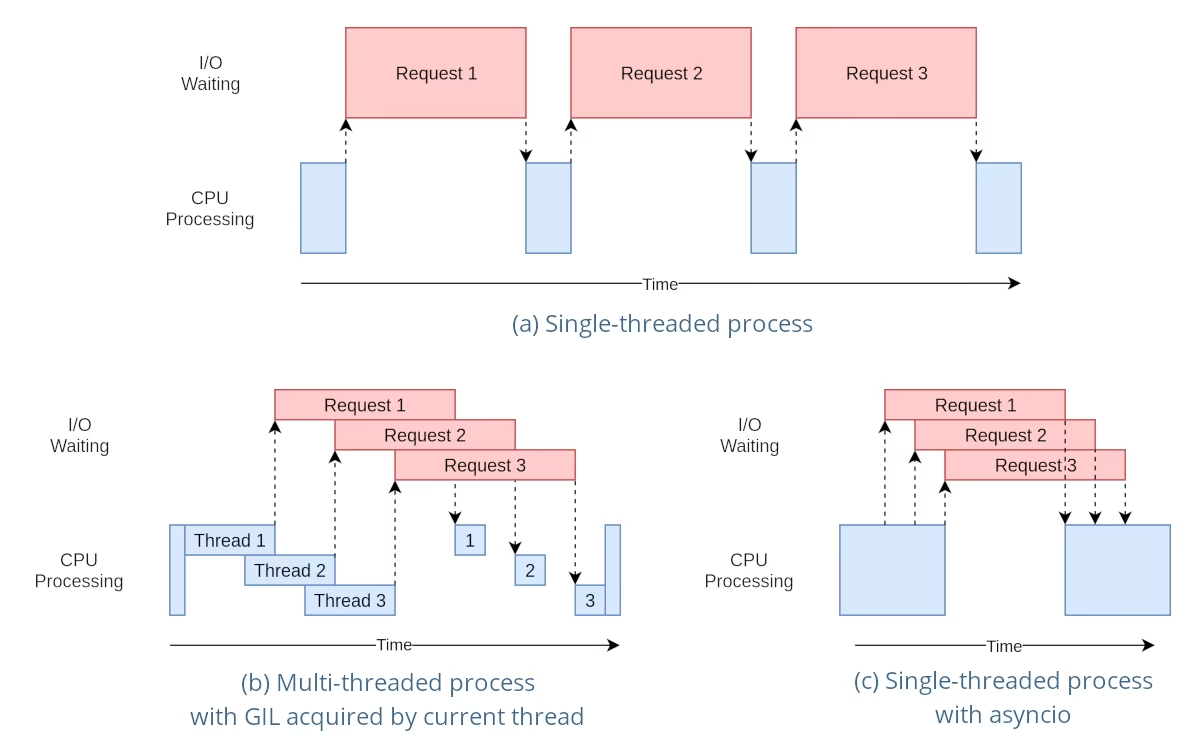
Il diagramma mostra perché i thread funzionano per questa pipeline. La decodifica consiste perlopiù in attese (le barre rosa dell'I/O) e OpenCV e PyTorch rilasciano il GIL di Python durante l'elaborazione, perciò i thread di decodifica si sovrappongono bene (pannello b). La postelaborazione intensiva in Python non si sovrappone; spostala in processi separati.
Quando ti servono sink personalizzati, logica specifica per telecamera o metriche esplicite dei frame persi, crea la pipeline in autonomia. I thread di decodifica non accedono mai al modello; se ne occupa un unico ciclo consumer, che garantisce anche il rispetto delle regole di inferenza thread-safe:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Le due clip hanno 62 e 150 frame e ogni frame viene elaborato o perso (56 + 6 = 62, 131 + 19 = 150), quindi i contatori tengono conto di tutto. Sono stati persi 25 frame su 212: la CPU di questo laptop non riesce a eseguire yolo26n in PyTorch su due stream a 30 FPS. Ecco un'unica esecuzione che ripete le clip per simulare un numero maggiore di telecamere:
| Stream (30 FPS ciascuno) | Frame persi |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Pianifica la capacità in base alle misurazioni#
Stream per dispositivo ≈ throughput sostenuto (frame al secondo elaborati dal modello alla dimensione del batch scelta) ÷ FPS richiesti per stream. Misura il throughput con l'esportazione ottimizzata delle lezioni precedenti sull'hardware effettivo, mantieni un margine del 20–30% per i picchi e invia un avviso quando le perdite superano lo zero. Una risoluzione più alta ha un costo che cresce all'incirca con il numero di pixel: 1280×1280 richiede circa 4× la potenza di calcolo di 640×640. Per flotte di grandi dimensioni, Triton Inference Server e DeepStream su Jetson sono le soluzioni più adatte alla produzione.
Insidie#
Sintomo: model.track(["cam1.mp4", "cam2.mp4"]) tratta l'elenco come un batch di immagini, non come flussi. Soluzione: scrivi le sorgenti in un file .streams, una per riga.
Sintomo: ogni file produce solo uno o due fotogrammi. Soluzione: stream_buffer=False scarta i fotogrammi obsoleti e i lettori di file avanzano più rapidamente del modello; imposta stream_buffer=True per i file e mantieni il valore predefinito per le telecamere in diretta.
Sintomo: risultati occasionalmente errati o confusi sotto carico. Soluzione: non chiamare mai contemporaneamente la stessa istanza YOLO da più thread. Affidala a un solo consumatore, come sopra, oppure crea un modello all'interno di ogni thread di inferenza.
Sintomo: la latenza aumenta di minuto in minuto e la memoria cresce finché il processo si arresta. Soluzione: usa una coda limitata che scarti gli elementi quando è piena, insieme a un contatore degli scarti. I sistemi in tempo reale dovrebbero scartare fotogrammi quando sono sovraccarichi, non accumulare ritardo.
Mostra la soluzione
Rendi il numero di stream un argomento della riga di comando aggiungendo queste righe a producer_consumer.py, subito dopo la riga SOURCES:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # numero di telecamere simulate
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Poi aumenta gradualmente il numero:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Per questa macchina, la risposta è uno stream: le perdite iniziano a due. Per gestire quattro telecamere, esporta verso un runtime più veloce (lezioni 3 e 4), riduci imgsz oppure passa a un acceleratore, quindi ripeti la verifica.