Ottimizza con TensorRT
Crea un engine TensorRT FP16, decidi se INT8 vale la perdita di precisione e verifica l'engine prima della distribuzione.
Su una GPU NVIDIA, un engine TensorRT FP16 è solitamente il modo più economico per aumentare la velocità: circa 1,5× più veloce nel benchmark Ultralytics A100, senza variazioni del mAP. INT8 va oltre, ma la quantizzazione INT8 post-training ha fatto perdere da 4 a 6 punti mAP a YOLO26s e YOLO26m su COCO. Questa lezione ti insegna a capire quale passaggio stai facendo e a misurarne gli effetti prima che lo facciano i tuoi utenti.
Pratico
Il codice di questa lezione richiede una GPU NVIDIA con TensorRT installato. Tutti gli argomenti mostrati sono elencati per format=engine nella documentazione della modalità di esportazione.
FP16 è il primo passaggio sicuro#
Le GPU NVIDIA dalla generazione Volta in poi hanno tensor core FP16 e, in fase di inferenza, raramente i modelli di rilevamento hanno bisogno di FP32. Inizia da qui:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # oppure runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Motore FP16, fino a 4 GiB di memoria di lavoro del compilatore
workspace limita la memoria GPU che TensorRT può usare durante la creazione; non impostarlo se vuoi lasciare decidere TensorRT. La pagina sull'integrazione di TensorRT pubblica questo risultato su A100 (YOLOv8n, 640 px):
| Precision | Predizione, batch 8 (ms) | mAP50-95 su COCO val |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
Il modello è più vecchio di YOLO26, ma l'andamento del compromesso resta valido: FP16 era circa 1,5× più veloce senza costi; INT8 ha aggiunto un altro 1,2×, al costo di 4 punti. Se FP16 rispetta il tuo budget, distribuiscilo.
Non hai una GPU NVIDIA locale? La scheda Esportazione della piattaforma Ultralytics crea l'engine su una GPU cloud a tua scelta, con le stesse opzioni di dimensione immagine, precisione, batch, modalità dinamica, NMS e workspace:

Scegli la famiglia di GPU su cui distribuirai il modello: l'engine nello screenshot è stato creato su una RTX 5090 e funzionerà solo su quella famiglia.
INT8 richiede dati di calibrazione#
La quantizzazione INT8 mappa le attivazioni di ogni layer su 256 livelli. Per determinare questi intervalli, l'esportatore esegue le immagini di calibrazione nel modello e registra le attivazioni osservate; le immagini devono quindi essere simili a quelle di produzione:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # le immagini di calibrazione provengono dalla suddivisione val di questo dataset; usa my_dataset/data.yaml
    fraction=1.0,  # quota (o numero) di queste immagini da usare
    batch=8,  # batch di calibrazione più grandi producono intervalli più stabili
    dynamic=True,  # con batch=8, l'engine accetta batch da 1 a 8
    workspace=4,
)
Il costo di INT8 dipende dal modello. La documentazione sulla modalità di esportazione ha misurato gli engine TensorRT di YOLO26 su COCO val (mAP50-95):
| Modello | Engine FP32 | INT8, calibrato (PTQ) | INT8 dopo l'addestramento consapevole della quantizzazione (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
La sola calibrazione costa 1 punto a YOLO26n e da 4 a 6 punti ai modelli più grandi. QAT affina il modello con quantize=8 in train affinché i suoi pesi tollerino INT8; il checkpoint include i propri intervalli, l'esportazione INT8 non richiede dati di calibrazione e il risultato resta entro 1–2 punti da FP32. La decisione:
Verifica l'engine prima della distribuzione#
Ogni engine deve superare gli stessi controlli sulla GPU di destinazione:
| Controllo | Criterio |
|---|---|
| mAP50-95 sul tuo set di validazione | Entro 0,5 punti da FP32 per FP16; entro il budget scritto per INT8 |
| AP per classe | Nessuna classe perde più di circa 1 punto (le classi piccole variano di più) |
| Latenza p95 | Sotto il budget con la dimensione del batch di produzione |
| Soglia operativa | conf ricalcolata dalla curva F1 dell'engine stesso |
| Determinismo | La stessa immagine produce esattamente le stesse bounding box in due esecuzioni |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
Da dove deriva l'aumento di velocità#
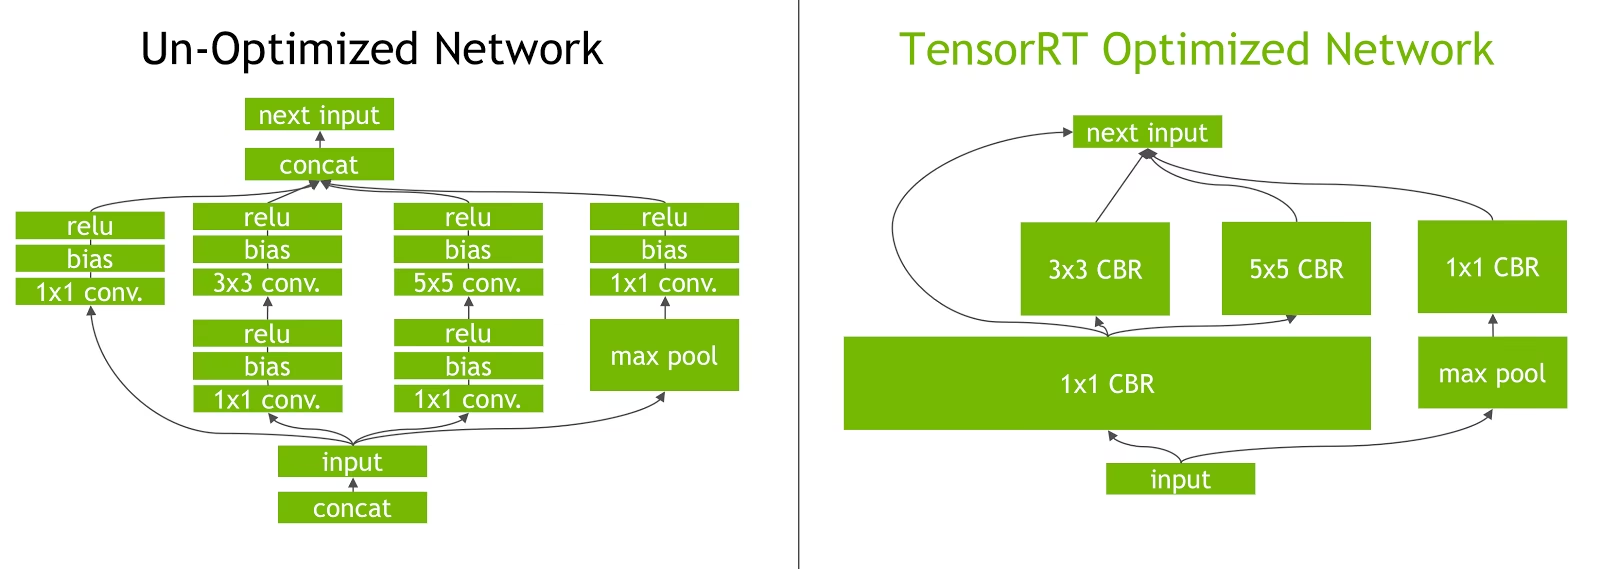
TensorRT fonde ogni convoluzione, bias e ReLU in un solo kernel (i blocchi "CBR" a destra) ed elimina i passaggi di concatenazione, così la GPU avvia molti meno kernel e sposta meno dati. In YOLO26 questo migliora le catene conv-BN-attivazione presenti in tutta la rete, il blocco di attenzione (PSA) nel backbone e le numerose operazioni di piccole dimensioni nella testa di rilevamento. Se un engine è ancora lento, analizzalo con trtexec o NVIDIA Nsight: spesso un layer impiega almeno il 30% del tempo.
Insidie#
Sintomo: INT8 perde 1 punto su COCO e 6 sulle tue telecamere. Soluzione: esegui la calibrazione con una porzione di tuo set di validazione mai usata in addestramento; NVIDIA consiglia almeno 500 immagini rappresentative. La calibrazione varia anche da un dispositivo all'altro, quindi eseguila sulla GPU di destinazione.
Sintomo: il richiamo cala dopo il passaggio a INT8 con lo stesso conf. Soluzione: INT8 può spostare i valori di confidenza; scegli di nuovo conf dalla curva F1 del motore INT8.
Sintomo: il motore non riesce a deserializzarsi o funziona più lentamente del previsto sul dispositivo di distribuzione. Soluzione: compila sulla famiglia di GPU di destinazione con versioni corrispondenti di TensorRT e del runtime CUDA e distribuisci .onnx, così i dispositivi possono ricompilare. Se la calibrazione si interrompe durante la compilazione, aumenta workspace oppure riduci imgsz o batch.
Su Jetson, DeepStream esegue gli engine risultanti in una pipeline video accelerata dall'hardware; nel data center, Triton Inference Server li mette a disposizione.
Mostra la soluzione
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Un report positivo riporta: differenza inferiore a 0,5 punti, p95 sotto il budget, decisione distribuire FP16. Se p95 non rispetta il budget, esporta INT8 con il tuo file YAML di calibrazione, ripeti le stesse due righe e distribuisci INT8 solo se la differenza resta entro il budget definito in precedenza; altrimenti prova QAT o un modello più piccolo.