OpenVINO su CPU
Esporta modelli OpenVINO FP32, FP16 e INT8, convalidali tutti e mantieni INT8 solo dove offre vantaggi sulla tua CPU.
Una CPU Intel che possiedi già può spesso sostituire un'istanza GPU: nei benchmark Ultralytics, YOLO26m passa da 192 ms in PyTorch a 36 ms con OpenVINO INT8 su una CPU Core Ultra per laptop. I vantaggi dipendono però dal chip e, sul laptop ARM usato per i test di questo corso, un'esportazione INT8 calibrata su quattro immagini ha perso 3 punti mAP. Imparerai a determinare quale caso ti riguarda prima della distribuzione.
Pratico
Cosa offre OpenVINO#
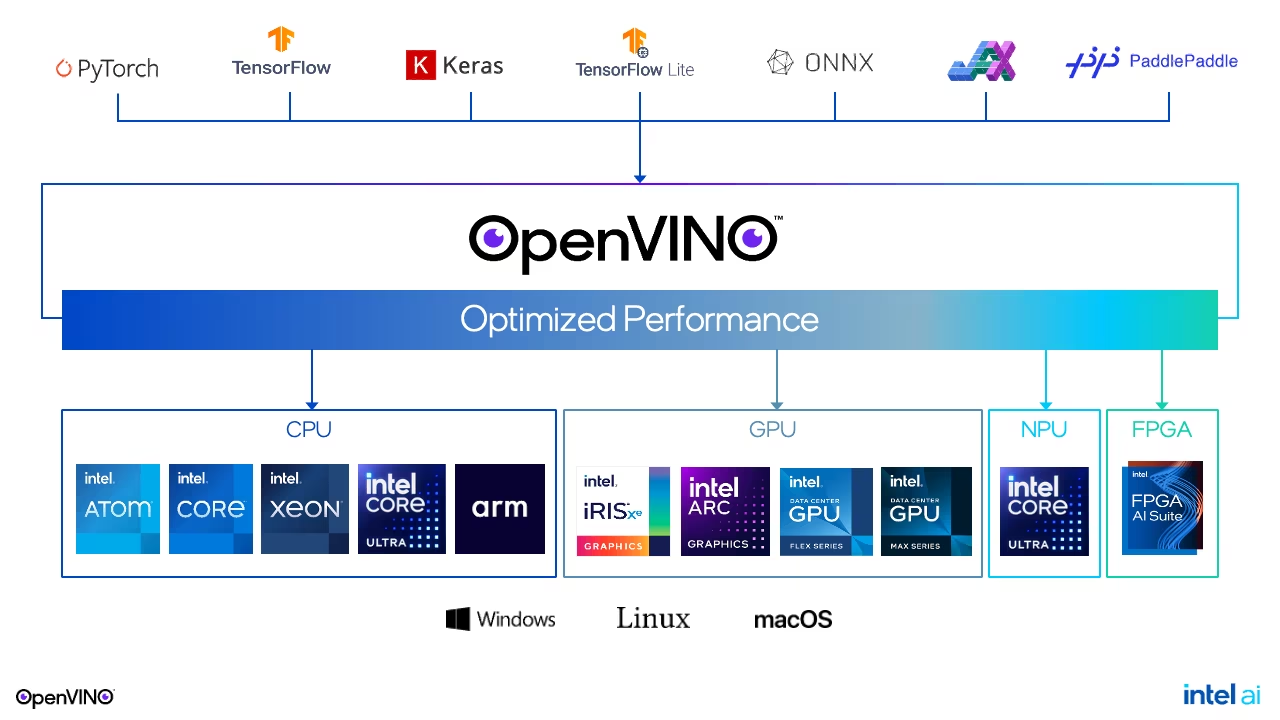
OpenVINO esegue modelli PyTorch e ONNX su CPU Intel, GPU integrate e dedicate e NPU tramite una sola API. I kernel per CPU supportano i set di istruzioni Intel (AVX2, AVX-512, AMX) e il percorso INT8 è maturo. Nota il riquadro ARM nella colonna CPU: OpenVINO funziona anche su ARM, ma i suoi kernel sono ottimizzati per Intel, quindi misura le prestazioni prima di farci affidamento.
Il benchmark pubblicato su una CPU Intel Core Ultra 7 155H (COCO128):
| Modello | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 da FP32 a INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Da questa tabella emergono tre regole:
- OpenVINO FP32 da solo dimezza circa la latenza di PyTorch su una CPU Intel. Inizia da qui.
- INT8 offre più vantaggi con i modelli più grandi: 1,2× per
n, 2,9× perm, al costo di 1,2–1,7 punti mAP. Pern, INT8 raramente vale la perdita di precisione. - Prova la GPU integrata prima di acquistare hardware: la GPU integrata Arc (iGPU) dello stesso chip (
device="intel:gpu") ha eseguito YOLO26n FP32 in 9.13 ms e YOLO26m in 34.47 ms.
Confronta i livelli di precisione sulla tua CPU#
Esporta ogni livello di precisione, convalidalo subito e solo dopo esporta il successivo:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Cosa indica ogni riga:
- FP32 e FP16 ottengono lo stesso punteggio e FP16 occupa metà dello spazio (5.1 contro 9.6 MB), ma entrambi sono stati scritti nella stessa cartella. Se li avessi esportati entrambi prima di convalidarli in seguito, avresti misurato FP16 due volte.
- INT8 occupa 3.2 MB e ha perso 3.2 punti, perché è stato calibrato sulle quattro immagini di COCO8. L'avviso lo segnala: una calibrazione reale richiede centinaia di immagini simili a quelle di produzione, tratte dal tuo YAML (
fractionlimita il numero di immagini usate). - Nessuna di queste misurazioni riguarda la velocità. Per misurarla, usa il benchmark qui sotto.
Per eseguire un modello esportato su un dispositivo Intel specifico:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # oppure intel:gpu, intel:npu
Distribuisci l'intera cartella: yolo26n.xml (il grafo), yolo26n.bin (i pesi) e metadata.yaml. intel:gpu e intel:npu richiedono hardware Intel.
Misura le prestazioni rispetto a ONNX Runtime#
La precisione è assodata; la velocità si determina sul dispositivo di destinazione, sotto il carico effettivo previsto. Esegui pick_runtime.py della prima lezione con CANDIDATES = ("onnx", "openvino"). Sul laptop di test con chip Apple, mentre altri processi condividevano la CPU:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO ha avuto una mediana migliore, ma una coda molto peggiore. Il wrapper Ultralytics compila OpenVINO con il suggerimento LATENCY (il log mostra Using OpenVINO LATENCY mode for batch=1 inference on CPU), distribuendo ogni richiesta sui core della CPU; quando altri processi competono per quei core, le richieste più lente ne risentono maggiormente. Su un sistema Intel dedicato, i risultati sono di solito quelli pubblicati sopra, ma solo il tuo p95 può dirtelo.
Regole per decidere:
Insidie#
Sintomo: l'esportazione FP16 è grande la metà ma è altrettanto lenta. Soluzione: sulla maggior parte delle CPU il plug-in sceglie autonomamente la precisione di esecuzione; usa FP16 per ridurre le dimensioni dei download e INT8 o la GPU integrata per aumentare la velocità.
Sintomo: FP32 e FP16 riportano valori identici perché si tratta dello stesso file. Soluzione: le esportazioni FP32 e FP16 condividono la cartella *_openvino_model/; convalida (o rinomina la cartella) subito dopo ogni esportazione.
Sintomo: la media sembra buona, ma nei momenti di maggiore attività si perdono comunque fotogrammi. Soluzione: misura il tempo di inferenza con il carico di produzione attivo e prendi decisioni in base al p95, non alla media. Per più flussi su un solo server, compila con il suggerimento THROUGHPUT caricando direttamente .xml con il runtime OpenVINO, come illustrato nella guida alle modalità latenza e throughput.
Su macOS e Windows, la validazione avvia processi worker che importano di nuovo lo script. Senza if __name__ == "__main__":, il test di questa lezione ha ripetuto le esportazioni all'interno di quei processi, sprecando minuti e contendendo la CPU che stava cercando di misurare.
Mostra la soluzione
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Ecco una decisione concreta basata sui numeri del Core Ultra 7 155H riportati sopra:
| Opzione | mAP50-95 | Dimensione | ms per immagine |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Distribuisci OpenVINO FP32 sulla GPU integrata: è l'opzione più veloce e non comporta alcuna perdita, mentre INT8 sulla CPU costerebbe 1,2 punti per risparmiare 2 ms. Con una distribuzione YOLO26m, la scelta si ribalta a favore di CPU INT8 (2,9 volte più veloce con una perdita di 1,7 punti), se tale perdita rientra nel tuo budget.