Kết hợp các tác vụ trong một pipeline
Xây dựng cascade detect rồi classify, phân loại mỗi đối tượng được tracking một lần thay vì ở mọi frame, và chuyển keypoint pose thành chuỗi thời gian cho từng người.
Các hệ thống hữu ích nhất ngoài detection thường dùng hai model chứ không phải một. Detector tìm từng công nhân và classifier xác định xem từng chiếc mũ bảo hộ có đúng loại hay không; model pose tìm các khớp và tracker biến chúng thành timeline để bạn có thể đếm số lần lặp. Code khá ngắn. Những vấn đề khiến các hệ thống này thất bại là dataset ở giai đoạn hai không khớp với crop của giai đoạn một, và chi phí tăng lên theo từng đối tượng trong mỗi frame — chạy theo cách ngây thơ, luồng 30 FPS với mười người sẽ cần 300 lượt phân loại mỗi giây.
Thực hành
Hai mô hình bao quát phần lớn sản phẩm#
Cả hai đều bắt đầu từ cùng một frame và cùng Ultralytics API; điểm khác biệt là dữ liệu mà giai đoạn thứ hai sử dụng. Việc chọn tracker, tinh chỉnh và xử lý luồng cho tracking đối tượng được trình bày trong Tracking đối tượng với ByteTrack, BoT-SORT và TrackTrack; ở đây, chúng ta tập trung vào việc kết hợp các tác vụ.
Detect, sau đó classify các crop#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)Luồng xử lý được thiết kế đúng: crop được lấy từ orig_img ở độ phân giải gốc, theo tọa độ pixel của chính detector, và classifier xử lý tất cả crop trong một lần gọi theo batch. Các nhãn cố ý vô nghĩa.
Bộ phân loại ImageNet chưa từng được huấn luyện trên các hình người ngoài đường bị cắt sát một phần, nên nó đoán — lưu ý rằng không có confidence nào vượt quá 0.50. Tình trạng tương tự xảy ra với bộ phân loại được huấn luyện trên ảnh sản phẩm rõ nét nhưng nhận các crop mờ từ detector.
Xây dựng dataset cho giai đoạn thứ hai từ crop của chính bạn#
Cách đáng tin cậy để có dữ liệu khớp là để detector tạo ra dữ liệu đó:
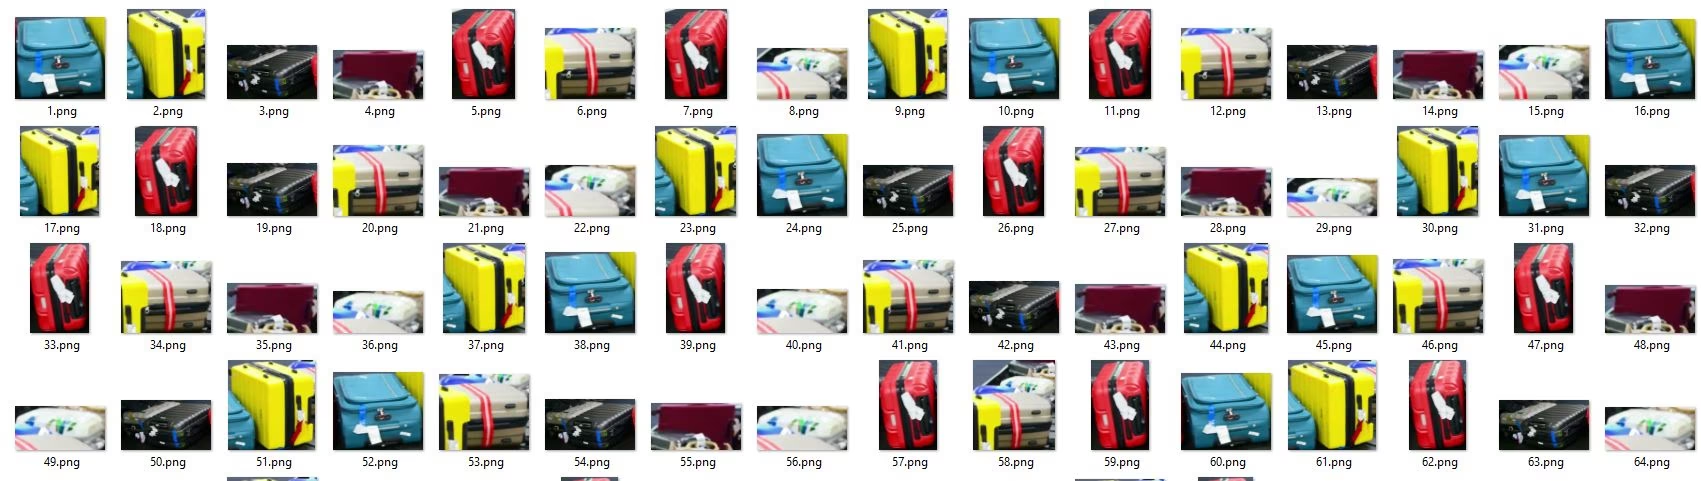
- Chạy detector trên video đại diện bằng
save_crop=True, chẳng hạn nhưyolo predict model=best.pt source=footage/ save_crop=True. Các crop được lưu vàoruns/detect/predict/crops/<class>/. - Sắp xếp crop của từng lớp vào các thư mục chi tiết (
helmet_ok/,helmet_missing/) — đây chính là bố cục phân loại đã trình bày trong bài học trước. - Huấn luyện classifier trên các thư mục đó và validation trên crop từ một ngày khác hoặc một camera khác.
Vì detector đã cắt crop nên các crop này giữ nguyên khung hình thực tế, độ mờ và tình trạng che khuất — đúng như những gì classifier sẽ gặp trong production — và việc fine-tuning trên dữ liệu đó là transfer learning thông thường.
Chỉ phân loại một lần cho mỗi track ID#
Mũ bảo hộ không thay đổi giữa các frame, vì vậy phân loại mọi box ở mọi frame là công việc lãng phí. Hãy tracking các detection và chỉ phân loại mỗi track ID mới một lần:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}Ba lần gọi classifier thay vì 33 lần trên một clip 11 frame; với luồng dài, mức tiết kiệm tăng theo mỗi frame mà một người vẫn xuất hiện trong tầm nhìn. Các nhãn vẫn chỉ là dự đoán từ ImageNet — thay bằng classifier đã fine-tune của bạn để có kết quả theo từng người.
Chỉ phân loại một lần cho mỗi track khi thuộc tính không thể thay đổi trong lúc đối tượng nằm trong khung hình (loại mũ bảo hiểm, hãng xe, SKU sản phẩm). Phân loại lại sau mỗi N frame khi thuộc tính có thể thay đổi (cửa mở, tay giơ lên). Nếu những lần phát hiện đầu tiên thường nhỏ và mờ, hãy phân loại ở frame mà box của track lớn nhất.
Pose kết hợp tracking#
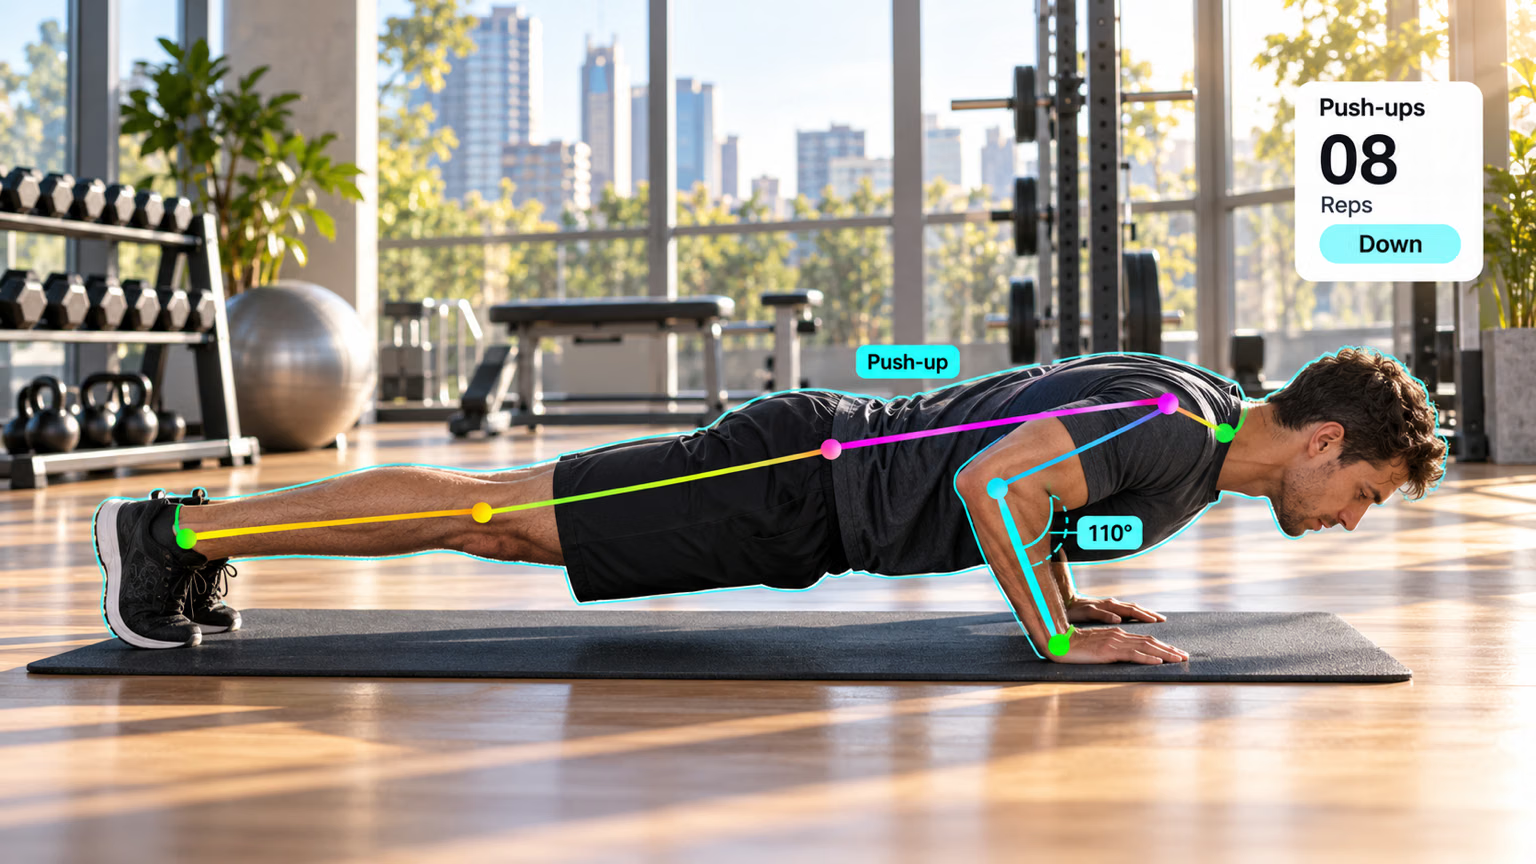
Chế độ tracking thêm một result.boxes.id duy trì ổn định cho mỗi người, biến keypoint thành chuỗi thời gian. Script này ghi lại góc đầu gối trái của từng người trong cùng một video ngắn:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degĐầu gối gập của ID 2 khớp với người đang ngồi trong clip; hai người còn lại đứng với chân duỗi thẳng, gần 180°. Từ đây, bộ đếm số lần lặp sẽ dựa trên việc góc của từng ID vượt qua các ngưỡng — hạ xuống dưới một góc, rồi nâng lên vượt quá một góc khác — đây chính là chức năng được đóng gói trong giải pháp giám sát bài tập.
Ước tính chi phí của pipeline#
| Yếu tố chi phối chi phí | Detect rồi classify | Pose kết hợp tracking |
|---|---|---|
| Tỷ lệ theo | số đối tượng mỗi frame | số frame |
| Yếu tố điều chỉnh chính | gom crop; phân loại một lần cho mỗi track ID và lưu cache | giảm imgsz hoặc vid_stride khi chuyển động chậm |
| Chế độ lỗi | classifier nhận các crop khác với dữ liệu huấn luyện | Việc đổi ID chia lịch sử của một người thành hai phần |
Triệu chứng: bộ đếm số lần lặp về 0 giữa chừng hoặc một người xuất hiện dưới hai ID. Nguyên nhân: tracker mất dấu người đó (bị che khuất, quay người nhanh) và gán ID mới. Cách khắc phục: tinh chỉnh tracker như trong khóa học production và thiết kế logic theo từng ID để chịu được các khoảng gián đoạn ngắn — nhãn classifier đã lưu trong cache sẽ được tính lại cho ID mới.
Hiển thị lời giải
Thêm save_crop=True vào lời gọi detector:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]Các crop xuất hiện trong runs/detect/predict*/crops/person/ và crops/bus/ (tên thư mục của lần chạy tăng sau mỗi lần dự đoán). Cơ chế lưu cache theo track chỉ cần 3 lần gọi classifier cho 33 box người, tiết kiệm 30 lần gọi trên clip 11 frame.
Để đếm góc đầu gối, thay vòng lặp cuối của pose_track.py:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 degID 2, người đang ngồi, có góc dưới 120° trong cả 11 frame; ID 1 và 3 thì không bao giờ.