Keypoint tùy chỉnh và chỉ số OKS
Thiết kế schema keypoint cho các đối tượng không phải người, viết và kiểm tra YAML của dataset, đồng thời thiết lập sigma OKS dựa trên độ chính xác có thể đạt được khi đặt từng điểm.
Pose không chỉ dành cho người. Đầu càng xe nâng, các góc của nhãn bưu kiện, mũi và đuôi động vật — bất kỳ đối tượng nào có các điểm ổn định, dễ gọi tên đều có thể trở thành dataset pose. Schema bạn viết ngay từ đầu sẽ được cố định: mọi nhãn, mọi cặp lật và mọi metric đều phụ thuộc vào schema đó; thay đổi về sau đồng nghĩa phải gán nhãn lại toàn bộ. Bài học này giúp hoàn thiện schema trước khi có người gán nhãn hàng nghìn ảnh, đồng thời giải thích chính xác cách metric đánh giá schema.
Thực hành
Thiết kế schema keypoint#
Keypoint tốt có ba đặc tính: rõ ràng (hai người gán nhãn đặt điểm ở cùng một vị trí), ổn định (điểm tồn tại trong mọi pose của đối tượng) và hữu ích (có phép tính downstream sử dụng điểm đó). Hãy lấy ví dụ xe nâng nhìn từ camera gắn trên trần, với câu hỏi cần trả lời là "càng xe có được nâng lên khi xe di chuyển không?":
| Chỉ số | Keypoint | Lý do tồn tại | Điểm đối xứng khi lật |
|---|---|---|---|
| 0 | left_fork_tip | Phạm vi và hướng của càng xe | 1 |
| 1 | right_fork_tip | Phạm vi và hướng của càng xe | 0 |
| 2 | mast_top | Chiều cao càng xe so với trụ nâng | 2 (chính nó) |
| 3 | mast_base | Điểm tham chiếu trên khung xe | 3 (chính nó) |
Mỗi điểm đều có lý do tồn tại vì góp phần vào phép tính: đầu càng xác định hướng, còn cặp điểm trên trụ nâng xác định chiều cao. Đánh giá từng điểm ứng viên theo cùng một bộ tiêu chí:
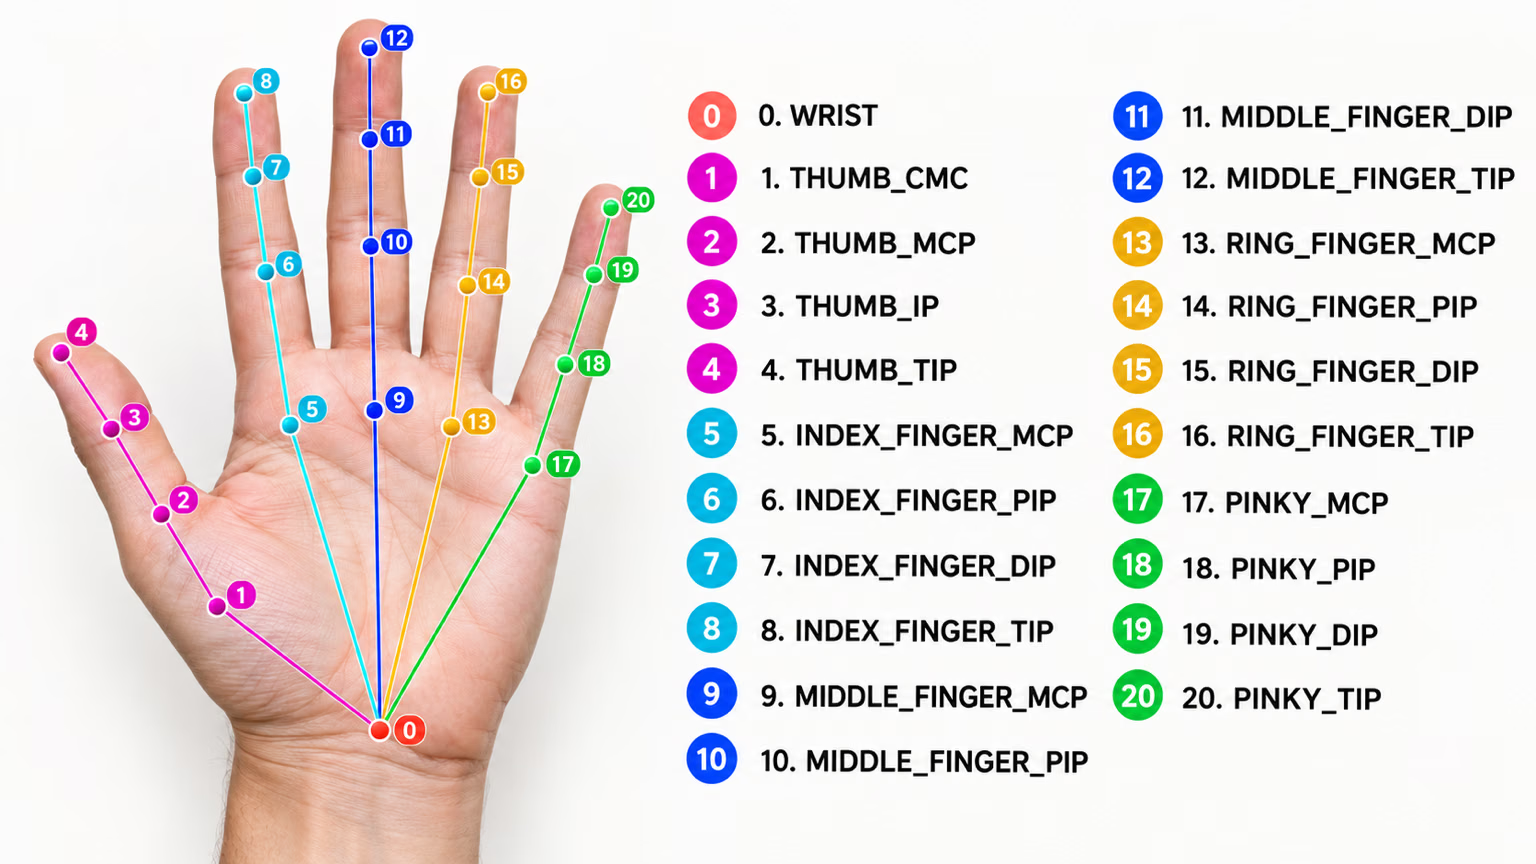
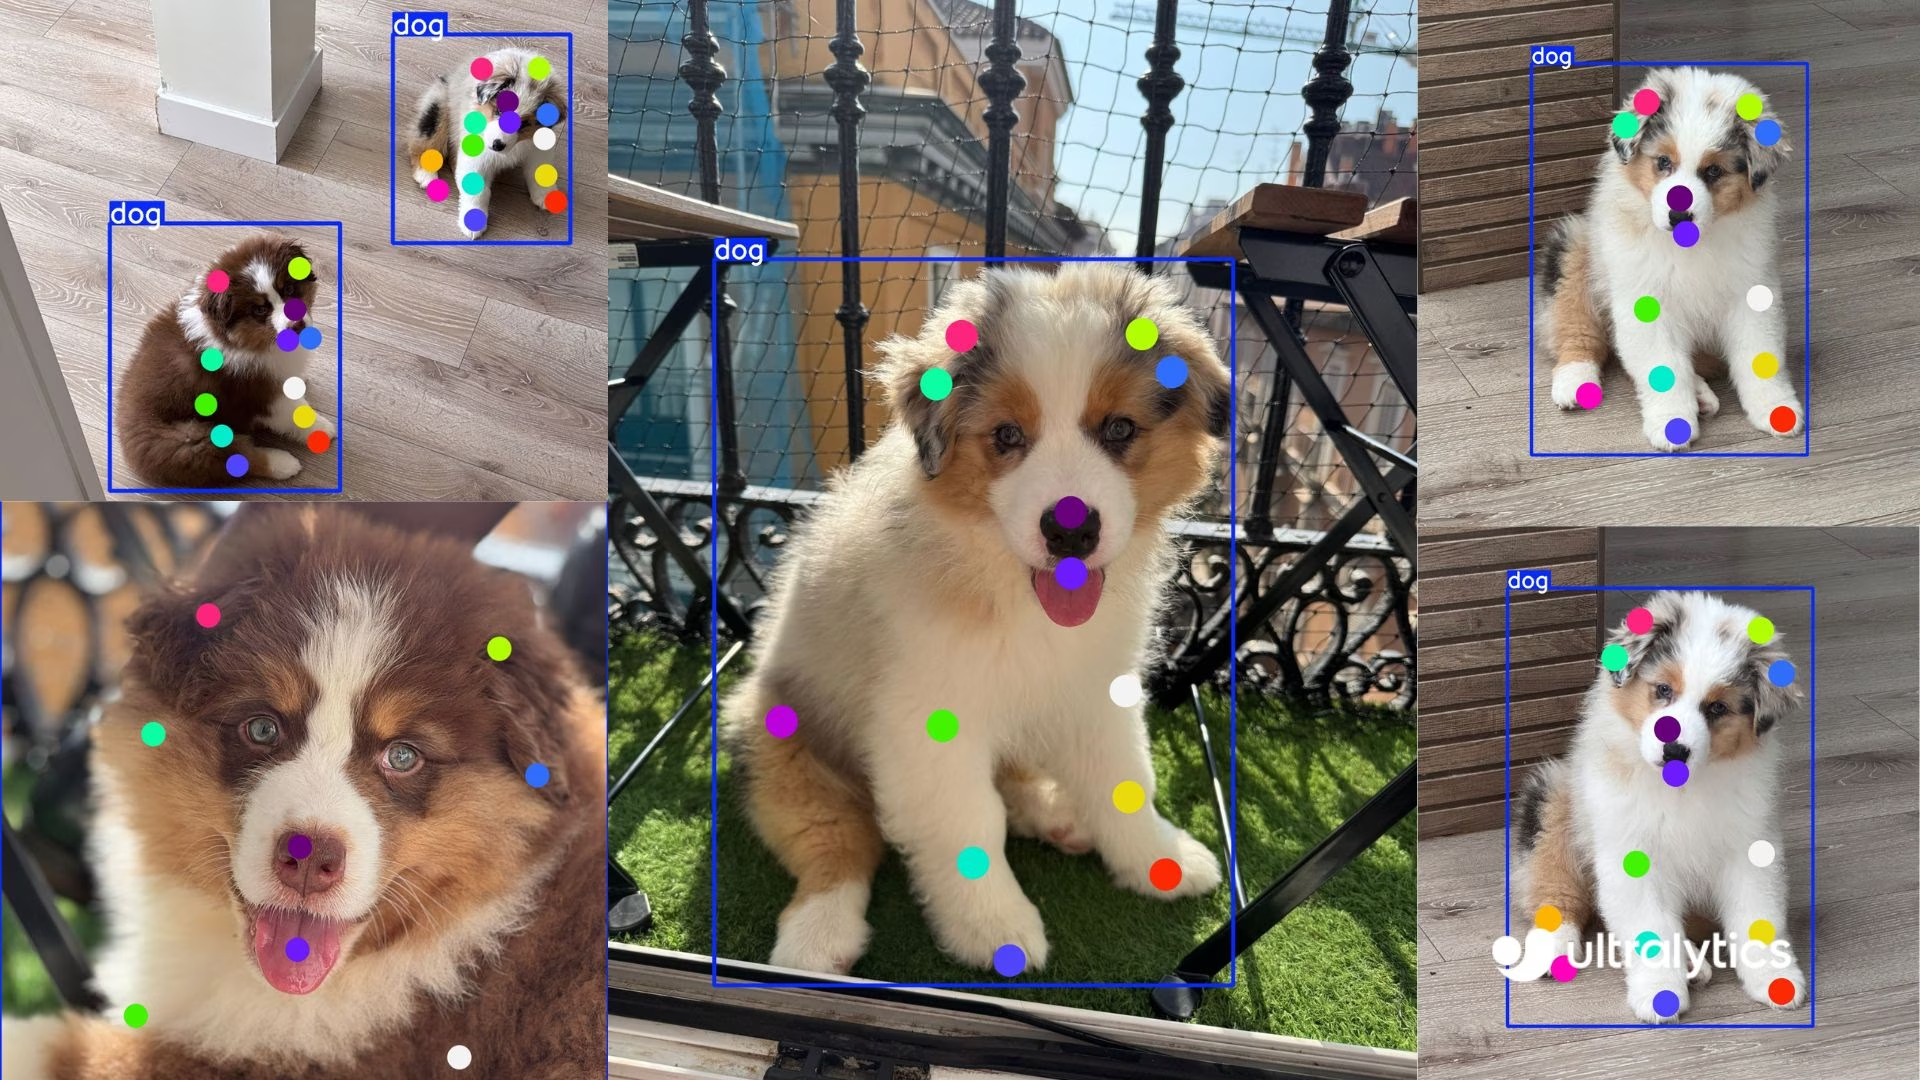
Đừng thêm điểm chỉ để "phòng khi cần": mỗi điểm làm tăng thời gian gán nhãn cho mọi đối tượng, còn những điểm không được sử dụng chỉ làm tăng nhiễu cho metric. Các dataset công khai cho thấy nhiều lựa chọn: Tiger-Pose dùng 12 điểm không có visibility, Dog-Pose dùng 24 điểm và Hand Keypoints dùng 21 điểm:
Viết YAML cho dataset#
path: forklift-pose
train: images/train
val: images/val

kpt_shape: [4, 3] # 4 keypoints, each x, y, visibility
flip_idx: [1, 0, 2, 3] # fork tips swap, mast points stay
kpt_oks_sigmas: [0.05, 0.05, 0.08, 0.08] # tips are sharp, mast ends are fuzzier

names:
  0: forklift

kpt_names:
  0:
    - left_fork_tip
    - right_fork_tip
    - mast_top
- mast_basekpt_namesmô tả thứ tự keypoint cho từng class, bao gồm người và dụng cụ.flip_idxphải là phép biến đổi tự nghịch đảo: áp dụng hai lần sẽ đưa mọi chỉ số về chính nó.kpt_oks_sigmaslà tùy chọn và dùng để đặt trọng số cho cả loss keypoint khi huấn luyện lẫn OKS khi validation; nếu có, danh sách phải chứa một giá trị dương cho mỗi keypoint, nếu không run sẽ dừng với mộtValueError.
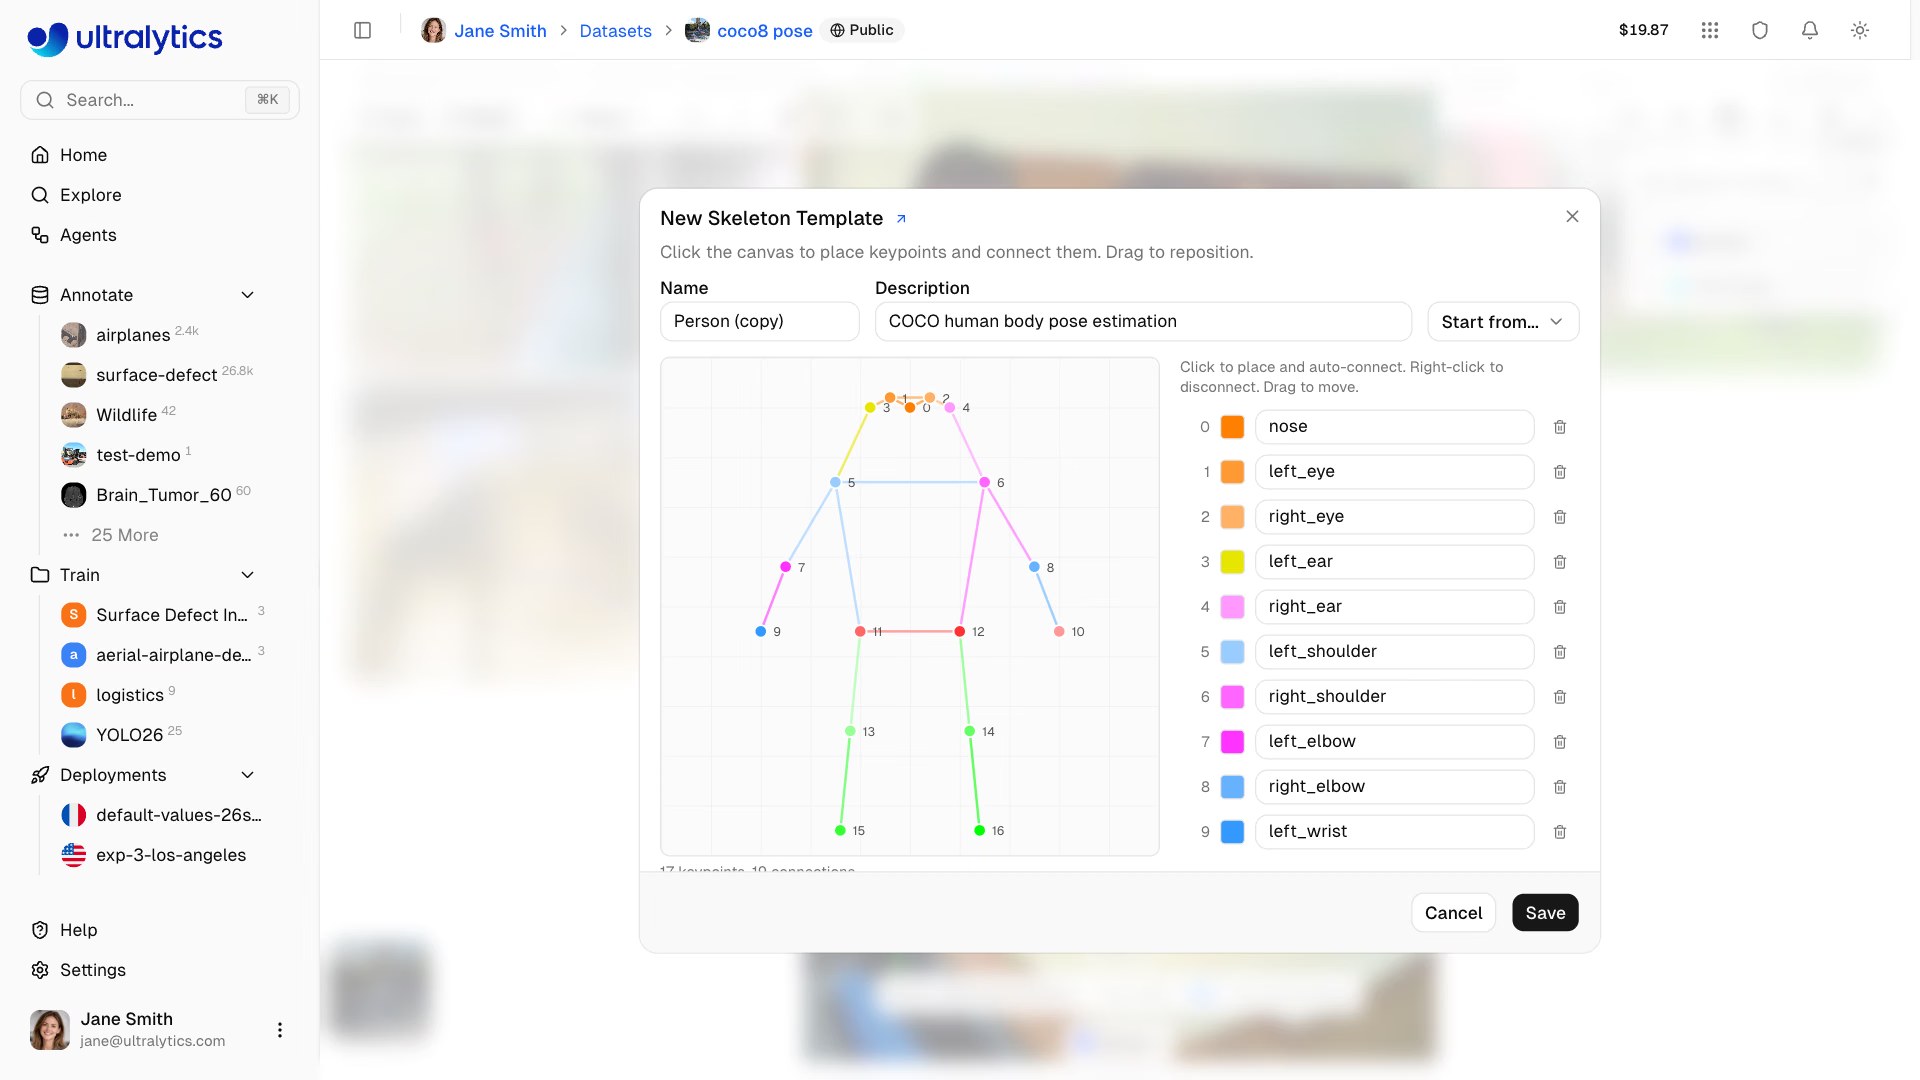
Trên Ultralytics Platform, schema tương ứng là một mẫu bộ khung xương. Có thể tạo mẫu mới từ một mẫu có sẵn (Bắt đầu từ…), nhờ đó bạn chỉ cần đổi tên và xóa bớt điểm thay vì đặt từng keypoint bằng tay — hãy giữ nguyên thứ tự chỉ số trong bảng schema:
Kiểm tra nhãn trước khi huấn luyện#
Dataset pose có thể gặp lỗi mà không báo rõ: một hàng thiếu một keypoint sẽ làm lệch mọi giá trị phía sau, còn visibility bằng 3 do exporter lỗi sẽ được đọc như mọi con số khác. Trình kiểm tra này tải YAML bằng loader của chính Ultralytics và xác thực từng hàng. Có thể chạy nguyên trạng trên COCO8-pose; thay bằng đường dẫn YAML của bạn:
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-pose.yaml")  # resolves paths, downloads if needed
k, dims = data["kpt_shape"]
flip = data.get("flip_idx", [])
assert not flip or sorted(flip) == list(range(k)), "flip_idx must list every keypoint index once"
assert all(flip[flip[i]] == i for i in range(len(flip))), "flip_idx must undo itself: pairs swap, center points stay"

expected = 5 + k * dims  # class + 4 box values + k keypoints of `dims` values
bad = 0
for label in Path(data["path"], "labels").rglob("*.txt"):
    for n, row in enumerate(label.read_text().splitlines(), 1):
        values = row.split()
        if len(values) != expected:
            bad += 1
            print(f"{label.name}:{n} has {len(values)} values, expected {expected}")
        elif dims == 3 and not {float(v) for v in values[7::3]} <= {0, 1, 2}:
            bad += 1
            print(f"{label.name}:{n} has a visibility flag outside 0/1/2")
print(f"kpt_shape={data['kpt_shape']}, flip_idx ok, {bad} bad rows")
kpt_shape=[17, 3], flip_idx ok, 0 bad rowsvalues[7::3] bắt đầu từ cờ visibility đầu tiên (class, bốn giá trị box, sau đó là x y v) và lấy mỗi giá trị thứ ba kể từ đó.
Cách OKS tính điểm cho keypoint#
Pose mAP thay IoU của box bằng Độ tương đồng điểm khóa đối tượng (OKS). Với mỗi keypoint được gán nhãn, OKS chuyển khoảng cách pixel giữa dự đoán và nhãn thành điểm từ 0 đến 1, được điều chỉnh theo kích thước đối tượng và sigma của keypoint đó, rồi tính trung bình trên các keypoint đã gán nhãn. Pose mAP50-95 tính trung bình precision tại các ngưỡng OKS từ 0.50 đến 0.95, giống hệt cách box mAP tính trên các ngưỡng IoU; hướng dẫn về metric hiệu năng giải thích cơ chế chung này.
Cách dễ nhất để hiểu sigma là đo lường chúng. Script này chấm điểm cùng một dự đoán xe nâng với hai giá trị sigma, sử dụng hàm kpt_iou mà bộ kiểm định pose gọi:
import torch

from ultralytics.utils.metrics import kpt_iou

# One labeled forklift, 4 keypoints (x, y, visibility) in pixels, inside a 200 x 120 px box
label = torch.tensor([[[40.0, 30, 2], [40, 90, 2], [170, 20, 2], [170, 100, 2]]])
area = torch.tensor([200 * 120 * 0.53])  # Ultralytics scales box area by 0.53 to approximate object area

for offset in (2, 5, 10, 20):
    pred = label.clone()
    pred[..., 0] += offset  # every predicted keypoint lands `offset` pixels to the right
    sharp = kpt_iou(label, pred, area, sigma=[0.025] * 4).item()
    loose = kpt_iou(label, pred, area, sigma=[0.10] * 4).item()
    print(f"{offset:2d} px off: OKS {sharp:.2f} with sigma 0.025, {loose:.2f} with sigma 0.10")
2 px off: OKS 0.94 with sigma 0.025, 1.00 with sigma 0.10
5 px off: OKS 0.67 with sigma 0.025, 0.98 with sigma 0.10
10 px off: OKS 0.21 with sigma 0.025, 0.91 with sigma 0.10
20 px off: OKS 0.00 with sigma 0.025, 0.67 with sigma 0.10Với xe nâng kích thước 200 × 120 pixel, dự đoán lệch 10 pixel không đạt ngưỡng OKS 0.50 với sigma 0.025, nhưng đạt mọi ngưỡng đến 0.90 với sigma 0.10. Cùng model, cùng sai số, nhưng pose mAP rất khác nhau.
| Sigma | Tác động | Dùng cho |
|---|---|---|
| Nhỏ (≈ 0.025–0.05) | Sai lệch vài pixel đã làm giảm điểm | Các điểm sắc nét: mắt, đầu càng, góc |
| Lớn (≈ 0.08–0.10) | Dung sai rộng | Các điểm khó xác định: hông, giữa trụ nâng |
| Mặc định | Sigma COCO cho kpt_shape: [17, 3]; nếu không có thì dùng 1/K cho mọi điểm | bắt đầu từ đây, sau đó đo lường |
Sigma nên phản ánh mức độ nhất quán khi người gán nhãn đặt từng điểm. Hãy đo lường: yêu cầu hai người gán nhãn cùng 50 ảnh rồi so sánh khoảng cách theo từng keypoint. Những điểm họ không thống nhất nên có sigma lớn hơn; nếu không, metric sẽ phạt model vì nhiễu do con người.
Thay đổi kpt_oks_sigmas làm thay đổi pose mAP dù model không đổi, như bảng trên cho thấy. Hãy cố định sigmas trước baseline đầu tiên, ghi lại sigmas cùng mỗi kết quả và không bao giờ so sánh các lần chạy được validation bằng các giá trị khác nhau.
Hiển thị lời giải
Ví dụ về bưu kiện trên băng chuyền, nhìn từ trên xuống, với câu hỏi "mặt có nhãn có hướng lên trên không và nhãn được xoay theo hướng nào?":
| Chỉ số | Keypoint | Mục đích | Điểm đối xứng khi lật | Sigma |
|---|---|---|---|---|
| 0 | label_top_left | Hướng của nhãn | 1 | 0.04 |
| 1 | label_top_right | Hướng của nhãn | 0 | 0.04 |
| 2 | label_bottom_right | Hướng của nhãn | 3 | 0.04 |
| 3 | label_bottom_left | Hướng của nhãn | 2 | 0.04 |
kpt_shape: [4, 3]
flip_idx: [1, 0, 3, 2]
kpt_oks_sigmas: [0.04, 0.04, 0.04, 0.04]
flip_idx vượt qua bước kiểm tra tự nghịch đảo: 0 → 1 → 0 và 2 → 3 → 2. Nhãn bị lật sẽ hoán đổi trái và phải nhưng giữ nguyên trên và dưới, vì vậy góc trên bên trái ghép cặp với góc trên bên phải, không phải góc dưới bên phải.
Để tìm dung sai, đặt sigma=[0.04] * 4 trong oks.py rồi mở rộng các độ lệch; bounding box của nhãn xác định tỷ lệ, vì vậy hãy dùng box có kích thước tương đương nhãn bưu kiện điển hình trong ảnh của bạn. Độ lệch tại đó OKS lần đầu giảm dưới 0.5 là sai số lớn nhất mà độ chính xác của người gán nhãn cho phép model chịu được.