Chọn tác vụ và lập kế hoạch pipeline
Ánh xạ từng câu hỏi về sản phẩm vào một trong bảy tác vụ Ultralytics YOLO, cùng weights, trường kết quả, định dạng nhãn và metric kiểm soát tương ứng, rồi kiểm chứng kế hoạch bằng cách chạy mọi tác vụ trên một ảnh.
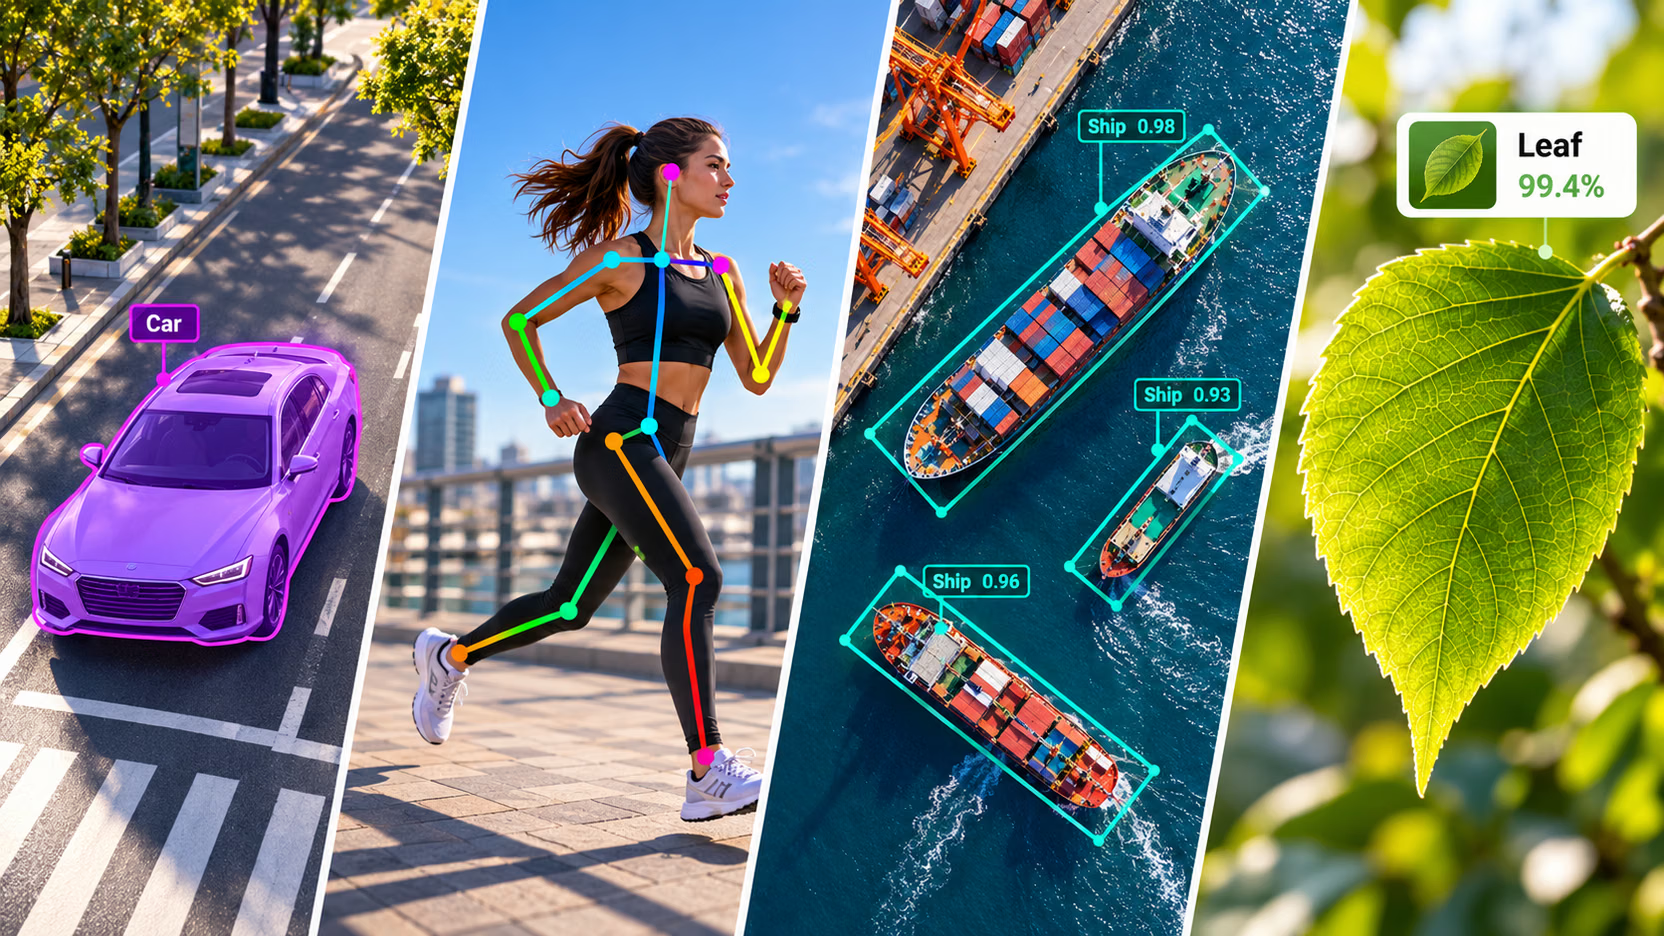
Sau khi đưa một detector vào sử dụng, các yêu cầu tiếp theo hiếm khi là "thêm box". Thường là "vết tràn rộng bao nhiêu", "lưng công nhân có bị cong không", "con tàu đang hướng về phía nào" và "bộ phận này có phải hàng loại không". Trong ảnh đường phố được dùng xuyên suốt khóa học này, bounding box của xe buýt chiếm 48% khung hình, trong khi bản thân xe buýt chỉ chiếm 29%, vì vậy câu trả lời về diện tích dựa trên box sẽ sai hơn một nửa. Tác vụ bạn chọn quyết định định dạng nhãn, nên chọn tác vụ trước khi bất kỳ ai gán nhãn là quyết định ít tốn kém nhất trong dự án; thay đổi sau đó đồng nghĩa với việc gán nhãn lại.
Thực hành
Một bức ảnh, bốn câu trả lời khác nhau#

Đặt một câu hỏi về một bức ảnh — xe buýt chiếm bao nhiêu phần khung hình và nó cách xa bao nhiêu? — rồi để bốn tác vụ Ultralytics YOLO trả lời:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraĐọc lần lượt từng dòng:
- detect trả lời câu hỏi ở đâu. Box còn chứa cả mặt đường bên dưới xe buýt và bốn người đứng phía trước, nên diện tích đo được lớn hơn thực tế 63%.
- segment trả lời câu hỏi hình dạng ra sao. 29.2% là diện tích thực của xe buýt trong ảnh, con số cần dùng cho mọi quy tắc về diện tích, độ phủ hoặc độ chồng lấp.
- semantic trả lời câu hỏi pixel nào thuộc lớp nào. Diện tích gần bằng diện tích của mask, nhưng model gọi xe buýt là
train: model gán nhãn bề mặt theo các lớp trong tập huấn luyện (Cityscapes, bài 4) và không bao giờ tách riêng từng phương tiện. - depth trả lời câu hỏi cách bao xa. Độ sâu trung vị bên trong mask xe buýt là 4.5 m — kết hợp hai tác vụ để trả lời một câu hỏi mà không tác vụ nào có thể tự trả lời.
Nếu giá trị sản phẩm báo cáo là diện tích, tỷ lệ bao phủ hoặc mức độ chồng lấp, bbox không phải công cụ phù hợp. Dùng mask (segment) cho đối tượng hoặc bản đồ lớp (semantic) cho bề mặt.
Tổng quan nhanh về bảy tác vụ#
Nền tảng Thị giác máy tính trình bày chi tiết cách chọn giữa các tác vụ — xem lại Bảy tác vụ thị giác nếu lựa chọn chưa rõ ràng. Đây là phần tóm lược thực hành cho phần còn lại của khóa học. Mọi hàng đều là một tác vụ mà package ultralytics đã cài đặt có thể huấn luyện, validation, dự đoán và xuất bằng cùng một API; tổng quan về các tác vụ là tài liệu tham khảo đầy đủ.
| Câu hỏi mà đầu ra trả lời | Tác vụ | Weights YOLO26 | Trường kết quả | Định dạng nhãn | Metric kiểm soát |
|---|---|---|---|---|---|
| Mỗi đối tượng nằm ở đâu? | detect | yolo26n.pt | boxes | lớp + box | mAP50-95 của box |
| Hình dạng và diện tích chính xác của mỗi đối tượng là gì? | segment | yolo26n-seg.pt | masks + boxes | lớp + polygon | mAP50-95 của mask |
| Mỗi pixel thuộc lớp nào? | semantic | yolo26n-sem.pt | semantic_mask | Bản đồ lớp PNG hoặc polygons | mIoU |
| Các khớp hoặc landmark nằm ở đâu? | pose | yolo26n-pose.pt | keypoints + boxes | lớp + box + keypoints | mAP50-95 của pose (OKS) |
| Mỗi đối tượng xoay như thế nào? | obb | yolo26n-obb.pt | obb | lớp + 4 góc | mAP50-95 của OBB |
| Toàn bộ ảnh (hoặc crop) này là gì? | classify | yolo26n-cls.pt | probs | một thư mục cho mỗi lớp | độ chính xác top-1 |
| Mỗi pixel cách camera bao xa? | depth | yolo26n-depth.pt | depth | bản đồ độ sâu cho mỗi ảnh (PNG 16-bit hoặc NPY) | δ1 (delta1) |
Bạn đã triển khai hàng đầu tiên. Các bài học 2 đến 8 hướng dẫn năm hàng ở giữa, còn các bài học 9 và 10 kết nối các hàng đó thành chuỗi rồi triển khai chúng. Hàng cuối cùng là bài toán ước lượng độ sâu đơn ảnh, dự đoán khoảng cách tính bằng mét cho từng pixel của một ảnh. Nhãn của bài toán này đến từ cảm biến độ sâu hoặc bộ kết xuất 3D thay vì từ người gán nhãn, nên bài toán này có định dạng dataset riêng; khóa học này bao gồm bài toán này ở tất cả những phần dùng chung quy trình làm việc: kế hoạch này, vòng lặp validation và bước kiểm tra export trong bài học cuối.
Mỗi lần chỉ chọn một câu hỏi#
Xem lần lượt các câu hỏi và dừng ở câu trả lời "có" đầu tiên:
Sơ đồ bao quát các trường hợp phổ biến. Bốn tiêu chí phân định sau xử lý phần lớn các trường hợp còn lại:
| Nếu yêu cầu… | Chọn | Vì |
|---|---|---|
| cần cả số lượng và diện tích ("có bao nhiêu vết tràn, và chúng lớn đến mức nào") | segment | semantic gộp các đối tượng tiếp giáp thành một vùng |
| liên quan đến các đối tượng dài, mảnh, xếp sát nhau và được nhìn từ trên xuống | obb | các box căn theo trục chồng lấp lên nhau và NMS loại bỏ đối tượng thật, ngay cả khi bạn không cần đọc góc |
| cần phân biệt mặt trước với mặt sau hoặc bên trái với bên phải | pose | OBB cung cấp một trục, không phải hướng di chuyển |
| theo thiết kế, mỗi ảnh chỉ có đúng một mặt hàng (trạm kiểm tra cố định) | classify | nhãn ít tốn kém nhất và model nhanh nhất |
Tác vụ được cố định khi bạn tạo dataset — trên Ultralytics Platform, đó là trường Task Type trong hộp thoại New Dataset — vì vậy cần đưa ra lựa chọn này trước khi gán nhãn lần đầu:

Một API, bảy trường kết quả#
Mọi tác vụ đều dùng cùng một lệnh gọi; model đọc tác vụ từ file weights. Điểm khác biệt là trường nào trong kết quả được điền dữ liệu, và code của bạn sẽ đọc trường đó:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Kết quả segmentation và pose vẫn giữ boxes, vì vậy code detect hiện có của bạn vẫn hoạt động với chúng. Kết quả classify, semantic và depth mô tả toàn bộ ảnh và hoàn toàn không có các trường theo từng đối tượng.
Code detection lặp qua result.boxes sẽ dừng với TypeError: 'NoneType' object is not iterable khi dùng model OBB: result.boxes là None, còn các detection xoay chỉ có trong result.obb. Chuyển code detection sang OBB bằng cách đọc result.obb, thay vì kiểm tra None rồi nhận về 0 detection.
Khi một model là chưa đủ#
Hầu hết hệ thống production vượt ra ngoài tác vụ detect đều có một trong ba dạng sau:
- Detect rồi classify. Detector tìm các đối tượng nhỏ trong khung hình lớn; một image classifier đưa ra phân loại chi tiết trên từng crop ở độ phân giải đầy đủ: loại mũ bảo hộ, cấp độ lỗi, mã SKU sản phẩm.
- Pose kết hợp tracking. Keypoints mô tả một khung hình; một tracker biến chúng thành chuỗi thời gian theo từng người để bạn có thể đếm số lần lặp hoặc phát hiện té ngã.
- Segment rồi đo lường. Model trả về các pixel; code thông thường chuyển chúng thành diện tích, chiều rộng, tỷ lệ độ phủ hoặc khoảng cách (khi có depth).
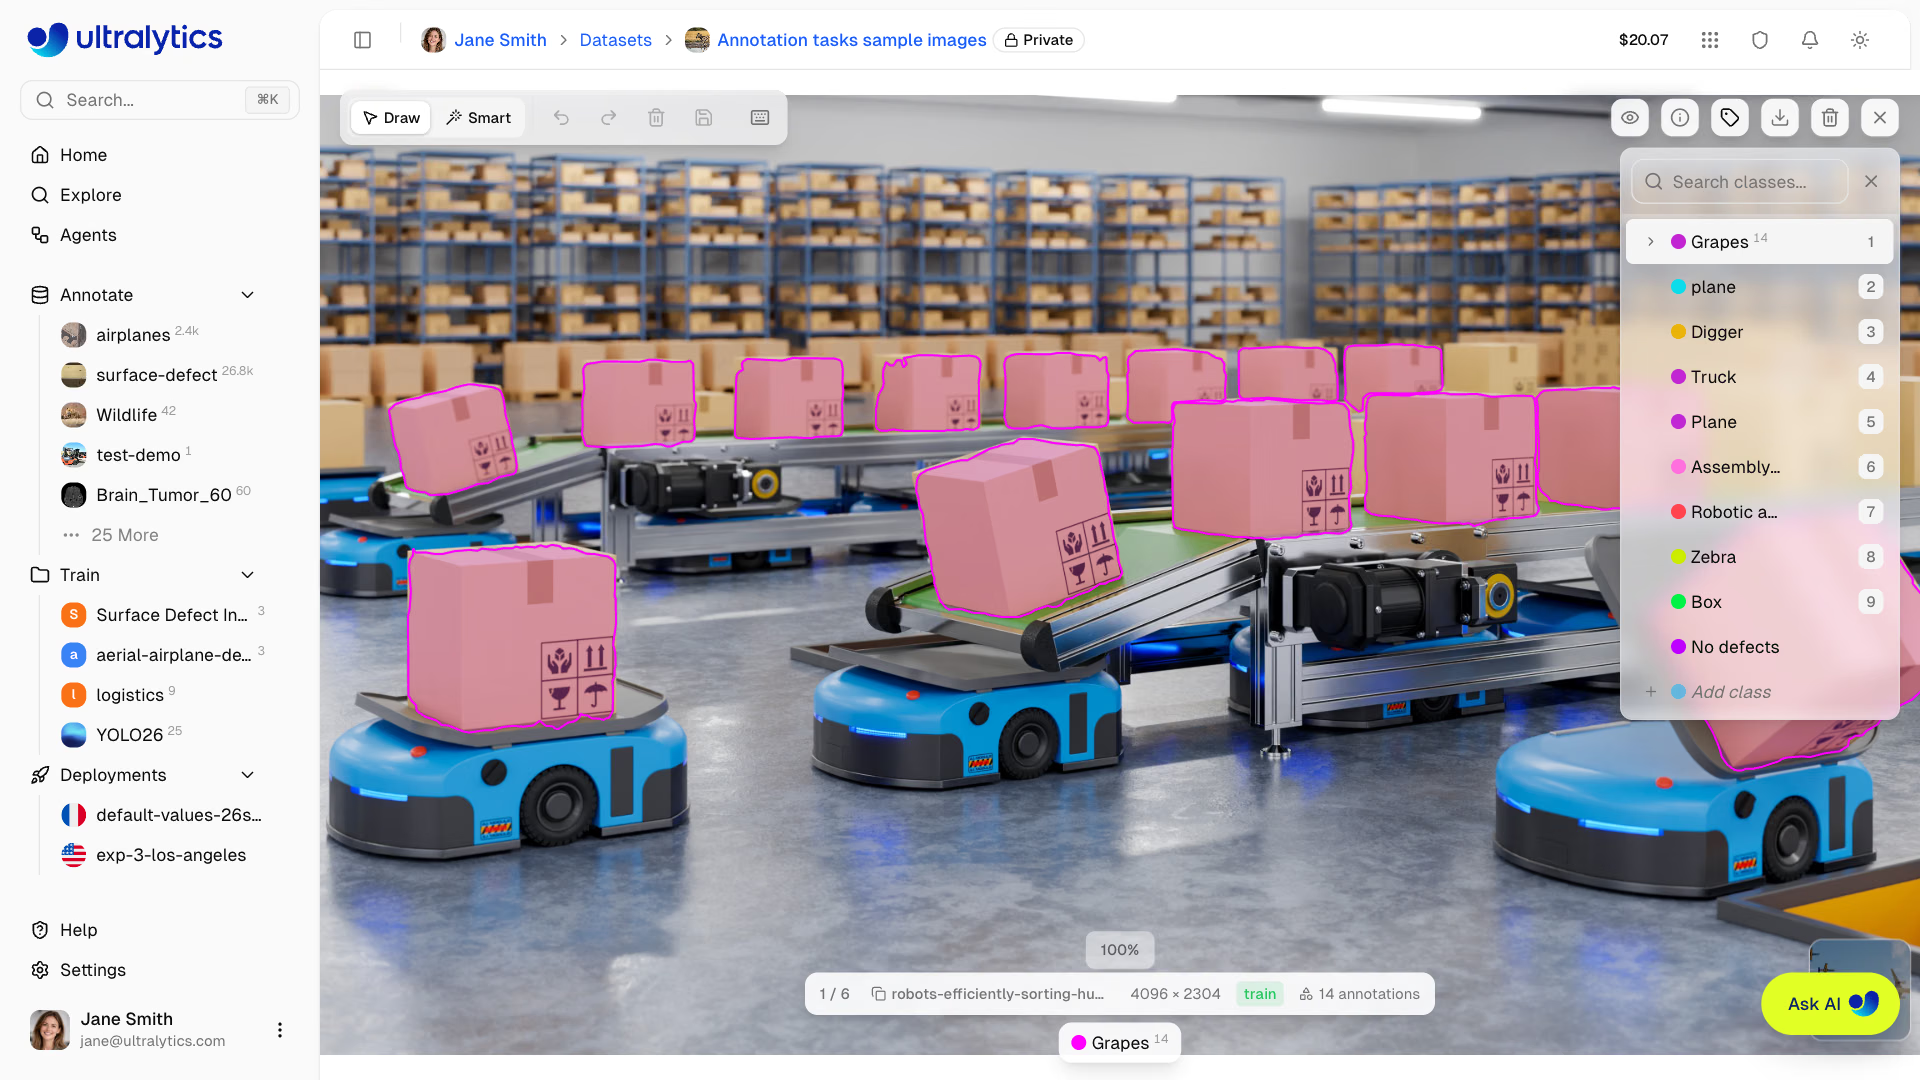
Nhãn cho pipeline segment rồi đo lường là một polygon cho mỗi đối tượng, như các kiện hàng trên robot kho trong trình chỉnh sửa Ultralytics Platform này:
Model thứ hai làm tăng độ trễ suy luận, đòi hỏi thêm một dataset cần gán nhãn và duy trì, đồng thời cần giám sát thêm một model. Chỉ kết hợp các model khi một tác vụ không thể trả lời câu hỏi — kế hoạch một model có thể triển khai tốt hơn kế hoạch ba model mà bạn không thể gán nhãn.
Các lỗi thường gặp#
Triệu chứng: nhóm gán nhãn polygon vì mask trông ấn tượng trong bản demo, nhưng sản phẩm chỉ cần đọc số lượng. Cách khắc phục: trước khi gán nhãn, hãy xác định dòng code sử dụng đầu ra. Nếu không có gì đọc đường viền, hãy triển khai detector: bbox dễ gán nhãn và chạy nhanh hơn.
Triệu chứng: sau một tháng gán nhãn, có người nhận ra sản phẩm cần hướng quay nhưng dataset có nhãn OBB, vốn chỉ cung cấp một trục. Cách khắc phục: ghi chính xác thuộc tính vào kế hoạch (result.masks.xy, result.keypoints.xy, result.obb.xywhr) và chạy tasks.py với weights đã chọn trước khi gán nhãn đầu tiên.
Triệu chứng: classifier đạt 95% trên ảnh sản phẩm rõ nét nhưng dự đoán sai phần lớn crop từ detector trong môi trường production. Cách khắc phục: tạo dataset cho giai đoạn thứ hai từ chính các crop của giai đoạn đầu, với độ nhòe và khung hình thực tế; bài học 9 hướng dẫn cách thực hiện.
Hiển thị lời giải
Với yêu cầu về pallet:
| Hàng | Lựa chọn |
|---|---|
| Câu hỏi | Có phần nào của pallet nhô qua đường mép dầm kệ không? |
| Tác vụ | segment — phần nhô ra phụ thuộc vào đường viền của pallet; box của pallet cũng bao phủ khoảng trống bên dưới pallet và hàng hóa bên trên |
| Weights | yolo26n-seg.pt, fine-tune trên các khung hình từ camera kho |
| Định dạng nhãn | Một polygon cho mỗi pallet |
| Trường kết quả | result.masks.data với retina_masks=True (pixel nằm ngoài đường mép dầm) |
| Metric kiểm soát | mAP50-95 của mask trên camera không được dùng trong quá trình huấn luyện |
| Giai đoạn hai | Không có — đường beam line được cố định cho từng camera, nên đây là cấu hình chứ không phải model |
Quy tắc phần nhô ra chỉ cần ba dòng code: vẽ đường beam line một lần cho mỗi camera, đếm số pixel mask ở phía sai của đường này và cảnh báo khi vượt ngưỡng pixel mà bạn hiệu chỉnh dựa trên một vài trường hợp phần nhô ra đã biết. Bài học 3 trình bày chính xác kiểu kiểm tra mask so với vùng này.