Gán nhãn và huấn luyện phân đoạn instance
Tạo nhãn polygon, kiểm tra bằng code, huấn luyện yolo26n-seg.pt trên COCO8-seg và chẩn đoán model dựa trên độ chênh lệch giữa metric box và mask.
Phân đoạn instance tạo đường viền riêng cho từng đối tượng, phù hợp khi quyết định phụ thuộc vào diện tích, vùng chồng lấp hoặc ranh giới. Polygon là loại nhãn tốn kém nhất mà hầu hết nhóm phải mua, và một dòng dữ liệu sai định dạng sẽ không làm quá trình huấn luyện bị lỗi — nó âm thầm khiến model học sai hình dạng. Bài học này giúp bạn tạo đúng định dạng dòng, kiểm tra một bộ nhãn bằng code và huấn luyện model đầu tiên để thấy giá trị của việc gán nhãn bổ sung: metric thứ hai đánh giá đường viền thay vì chỉ đánh giá vị trí.
Thực hành
Dòng nhãn polygon#
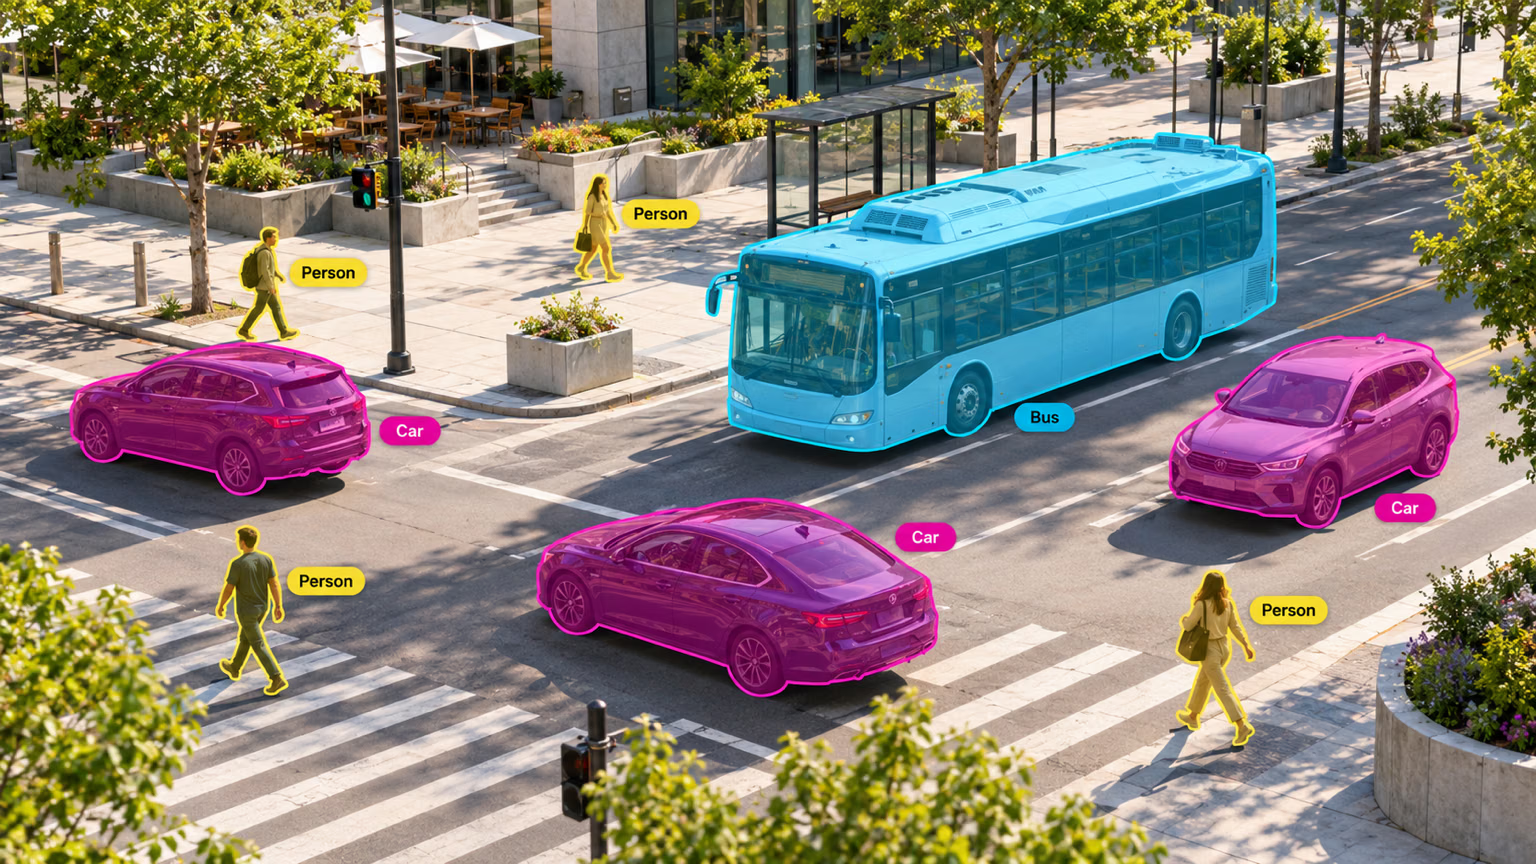
Tệp nhãn phân đoạn có một dòng cho mỗi đối tượng, tương tự nhãn phát hiện, nhưng thay vì box, tệp liệt kê đường viền đối tượng dưới dạng các cặp đỉnh đã chuẩn hóa. Đây là một dòng thực tế trong COCO8-seg, đã được rút gọn:
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| Vị trí | Dòng phát hiện | Dòng phân đoạn |
|---|---|---|
| 1 | chỉ số class (45 là bowl) | chỉ số class |
| 2–5 | x_center y_center width height | hai đỉnh đầu tiên, x1 y1 x2 y2 |
| 6+ | — | thêm đỉnh tùy theo số lượng cần thiết để mô tả đường viền |
| Đơn vị | được chuẩn hóa trong khoảng 0–1 | được chuẩn hóa trong khoảng 0–1 (pixel x ÷ chiều rộng ảnh, pixel y ÷ chiều cao ảnh) |
Ba quy tắc quan trọng nhất: mỗi đối tượng có ít nhất ba đỉnh, tọa độ được chia cho kích thước ảnh và mỗi instance có một dòng riêng ngay cả khi hai đối tượng cùng class chạm nhau. Hướng dẫn dataset phân đoạn có đầy đủ thông số kỹ thuật.
Polygon là tập hợp bao hàm các nhãn bbox. Cùng một thư mục nhãn có thể huấn luyện yolo26n.pt (Ultralytics suy ra từng bbox từ polygon) và yolo26n-sem.pt (rasterize polygon thành bản đồ lớp) — chúng tôi đã huấn luyện cả hai trên coco8-seg.yaml. Nếu kế hoạch thay đổi sau khi gán nhãn, ngân sách không bị lãng phí.
Kiểm tra nhãn trước khi huấn luyện#
Một dòng có số lượng giá trị lẻ, tọa độ được ghi bằng pixel hoặc đường viền bao quanh nhầm đối tượng sẽ không làm quá trình huấn luyện dừng lại. Trình kiểm tra này đọc dataset bằng chính loader của Ultralytics, từ chối các dòng sai định dạng và in diện tích của từng polygon bên cạnh box mà Ultralytics suy ra từ polygon đó:
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38Diện tích là phần tỷ lệ so với toàn ảnh, vì vậy chiếc bát đầu tiên chiếm 39% ảnh. Độ phủ là diện tích polygon chia cho diện tích box; đây là cột cần xem:
- Hầu hết các đối tượng nhỏ gọn (bát, cam, bông cải xanh) có giá trị khoảng 0.6–0.7.
- Giá trị 0.31 của hươu cao cổ là hợp lý: chân và cổ dài khiến phần lớn box bị bỏ trống — đây chính là lý do đối tượng này cần mask.
- Giá trị 0.15 của chiếc bát thứ ba là dòng mà người đánh giá nên mở ra xem. Chỉ có một vành mỏng của chiếc bát lộ ra quanh phần thức ăn, vì vậy đường viền là một dải hẹp bên trong box lớn. Trường hợp này là đúng; với dữ liệu của bạn, độ phủ thấp như vậy thường cũng có thể là do đường viền được vẽ quanh nhầm đối tượng.
Sửa mọi hàng BAD trước khi huấn luyện. Sau đó sắp xếp theo tỷ lệ lấp đầy và mở vài phần trăm hàng có tỷ lệ thấp nhất của mỗi lớp trong công cụ gán nhãn: tỷ lệ thấp có thể là đối tượng mảnh hoặc bị che khuất (giữ lại), hoặc đường viền vẽ sai (sửa lại).
Tạo polygon mà không cần vẽ theo từng cạnh#
Tự vẽ đường viền là phần tốn kém nhất trong gán nhãn dữ liệu. Hãy kiểm tra xem có lối tắt nào phù hợp trước khi bắt đầu:
| Bạn đã có | Công cụ |
|---|---|
| JSON COCO có dữ liệu phân đoạn | convert_coco(labels_dir, use_segments=True) từ ultralytics.data.converter |
| Mask PNG (giá trị pixel = chỉ số class + 1, 0 = nền) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes) — các đối tượng cùng class chạm nhau sẽ được tạo thành một polygon, vì vậy hãy tách chúng trong bước đánh giá |
| Chỉ có nhãn box | yolo_bbox2segment(im_dir) — dùng từng box làm prompt cho SAM để tạo polygon |
| Chưa có gì | Chú thích thông minh và gán nhãn hàng loạt — nhấp một lần, đánh giá polygon |
Trên Ultralytics Platform, chế độ Smart chạy SAM: một lần nhấp tích cực vào đối tượng và một lần nhấp loại trừ vào vùng cần bỏ ra sẽ tạo mask để bạn đánh giá.
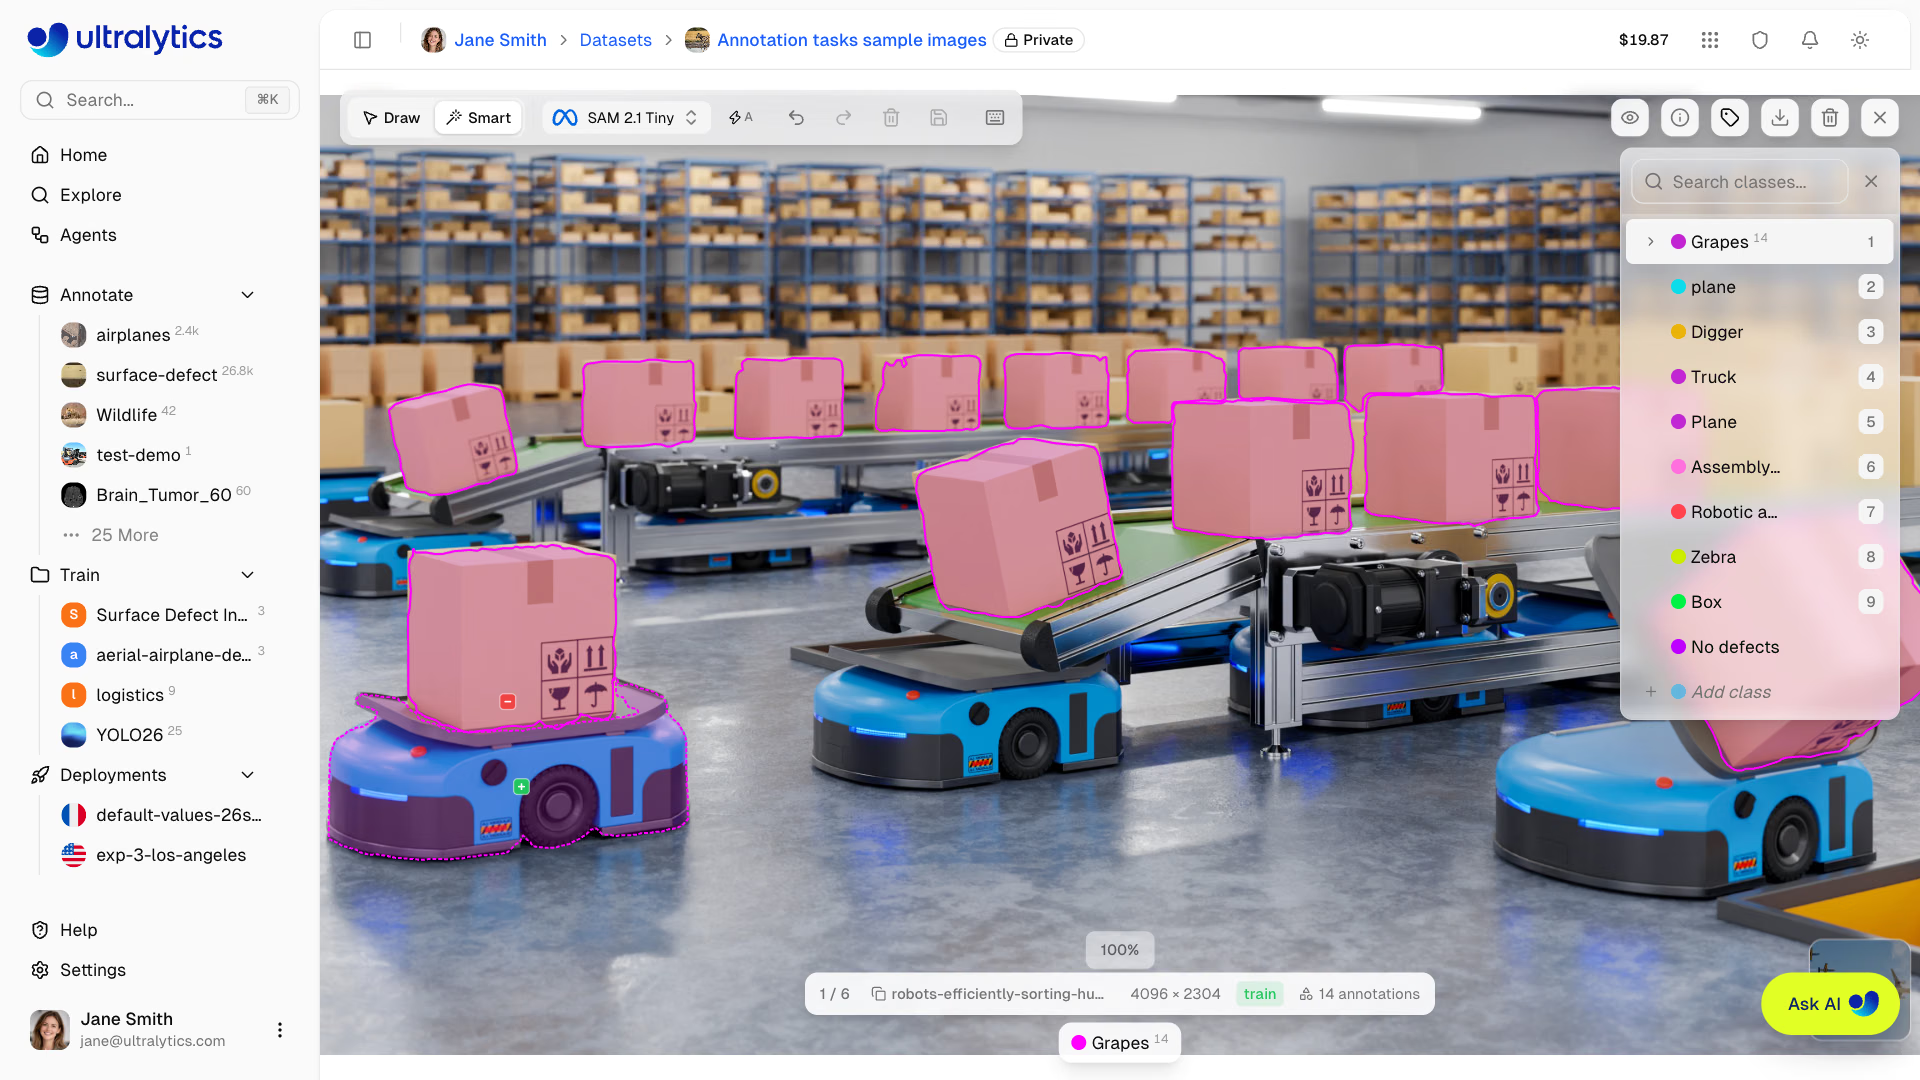
Mask bị lem vào nền sẽ khiến model học cách làm tương tự. Rà soát polygon do máy tạo theo tiêu chuẩn chất lượng trong BBox và mask, sau đó chạy lại bước kiểm tra nhãn ở trên.
Huấn luyện trên COCO8-seg#
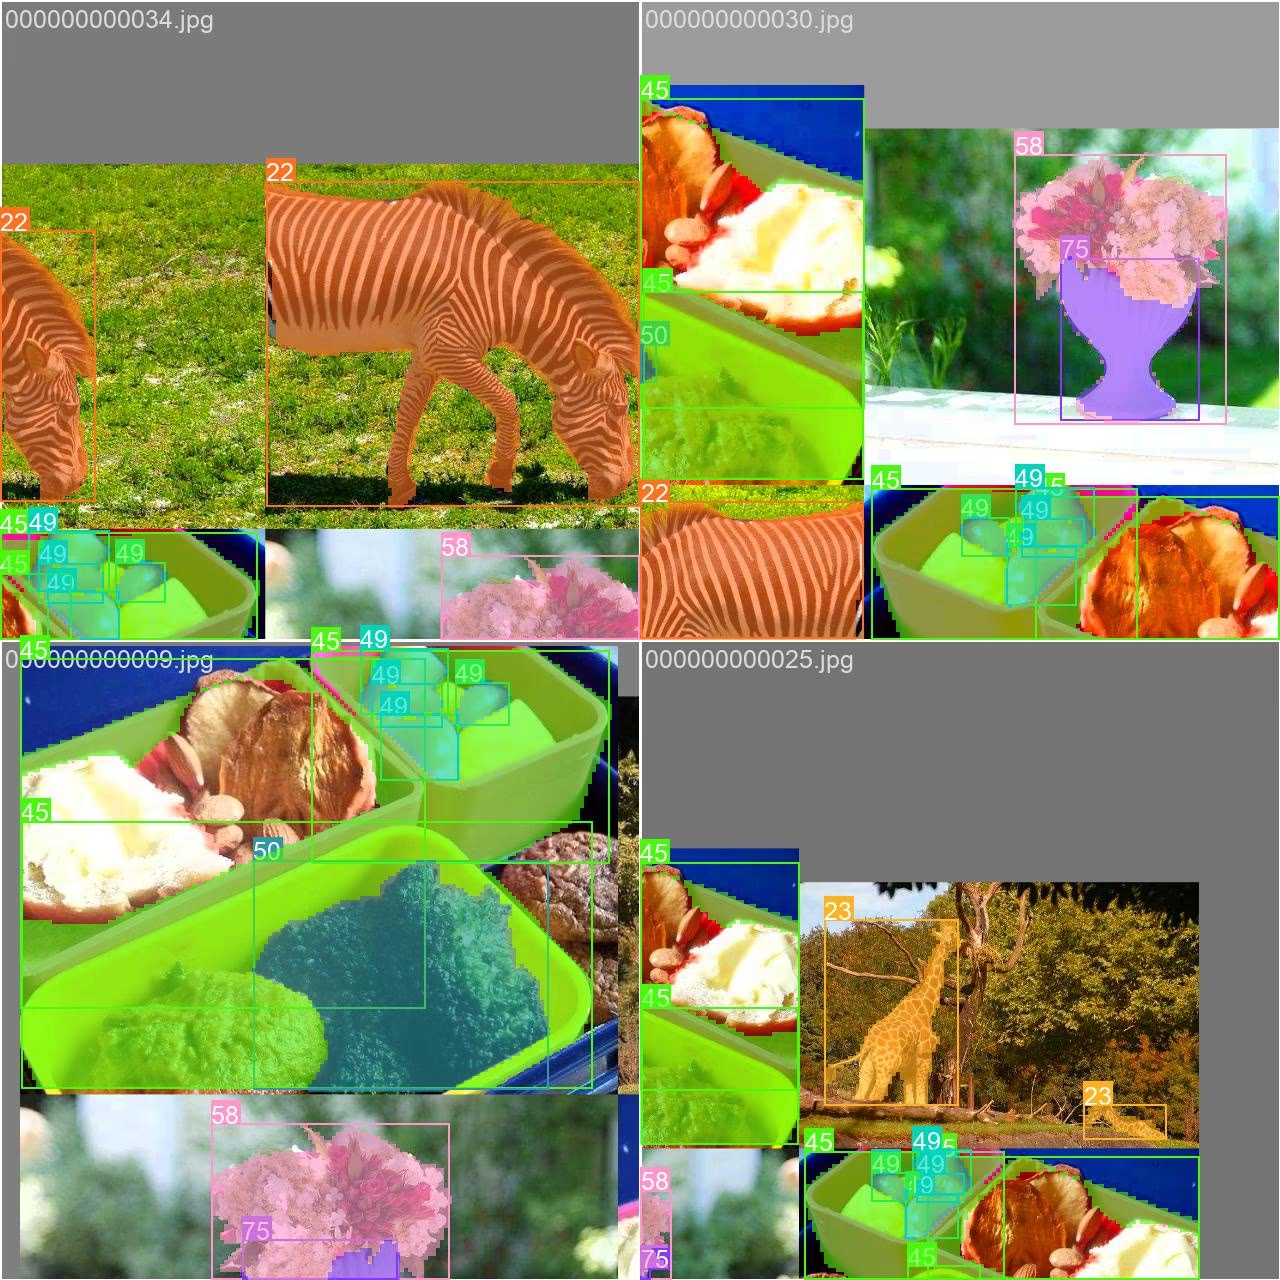
Quy trình huấn luyện tương tự quy trình phát hiện, nhưng dùng model -seg và dataset phân đoạn. Một epoch ở imgsz=320 trên CPU laptop hoàn tất trong vài giây, đủ để kiểm tra toàn bộ pipeline:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377Bốn ảnh validation khiến các con số này không đáng tin cậy; điều quan trọng là lần chạy hoàn tất và ghi weights/best.pt vào runs/segment/. Với dữ liệu thực tế, hãy làm theo hướng dẫn tác vụ Segment và huấn luyện toàn bộ lịch trình trên GPU.
Đọc metric box và mask song song#
Bảng validation có hai phần. Box chấm điểm từng box dự đoán so với box được suy ra từ nhãn; Mask chấm điểm pixel dự đoán so với polygon được gán nhãn. Cả hai đều dùng cùng cơ chế mAP; chỉ có IoU thay đổi.
Mask mAP50-95 gần như luôn thấp hơn box mAP50-95, vì IoU theo pixel nghiêm ngặt hơn: box lệch vài pixel vẫn có độ chồng lấp cao, trong khi mask bỏ sót cánh tay hoặc lấn vào mặt đường sẽ nhanh chóng mất IoU ở các ngưỡng 0.75–0.95. Dòng horse thể hiện rõ nhất điều này — box mAP50-95 là 0.564, mask là 0.199. Model tìm thấy cả hai con ngựa và đóng khung chúng tốt; model không vẽ được đường viền chân và đuôi. Dùng độ chênh lệch để quyết định cần sửa gì:
- Cả hai đều thấp: vấn đề nằm ở khả năng tìm đối tượng, không phải vẽ đường viền. Trước tiên, hãy bổ sung dữ liệu cho các điều kiện bị bỏ sót.
- Box tốt, mask thấp hơn nhiều: model tìm được đối tượng nhưng vẽ đường viền kém. Chạy kiểm tra nhãn, thử model lớn hơn hoặc huấn luyện và validation ở
imgszcao hơn. - Mask cải thiện trong khi box chững lại: không sao — với sản phẩm phân đoạn, mask mAP50-95 là ngưỡng để phát hành.
overlap_mask=True gộp các mask instance vào một ảnh trong quá trình huấn luyện, còn mask_ratio=4 giảm kích thước mask huấn luyện. Cả hai đều không làm thay đổi độ phân giải của mask dự đoán — tham số đó là retina_masks, trong bài học tiếp theo. Giữ nguyên giá trị mặc định của cả hai trừ khi bạn đã đo đạc và có lý do để thay đổi.
Hiển thị lời giải
Để kiểm tra mọi split, thay thư mục trong vòng lặp bằng Path(data["path"], "labels").rglob("*.txt"). Sau đó, huấn luyện:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}")   # 0.377 in our run
Độ chênh lệch 0.1 là điều dự kiến: IoU mask phạt mọi pixel ở ranh giới, còn IoU box chỉ phạt bốn cạnh. Trong lần chạy của chúng tôi, class có độ chênh lệch lớn nhất là horse (box 0.564, mask 0.199). Box mAP tốt nhưng mask thấp hơn nhiều, vì vậy sơ đồ hướng đến chất lượng đường viền: trước tiên hãy kiểm tra các polygon đó, sau đó thử model lớn hơn hoặc imgsz cao hơn.