Segmentation ngữ nghĩa: gán nhãn cho mọi pixel
Dự đoán bản đồ lớp theo từng pixel bằng yolo26n-sem.pt, chuyển bản đồ thành các số liệu về tỷ lệ phủ, tạo bộ dữ liệu bản đồ lớp PNG và đọc mIoU mà không để độ chính xác pixel đánh lừa.
Một số câu hỏi không có đối tượng để đếm: vỉa hè bị chắn bao nhiêu, cỏ dại chiếm bao nhiêu diện tích cánh đồng, đường dành cho xe chạy kết thúc ở đâu. Segmentation ngữ nghĩa trả lời những câu hỏi này bằng cách gán một ID lớp cho mỗi pixel. Tuy nhiên, chỉ số nổi bật nhất của nó rất dễ bị hiểu sai: model bạn huấn luyện trong bài học này đạt độ chính xác pixel 91% dù không phát hiện được một người nào.
Thực hành
Instance hay ngữ nghĩa?#
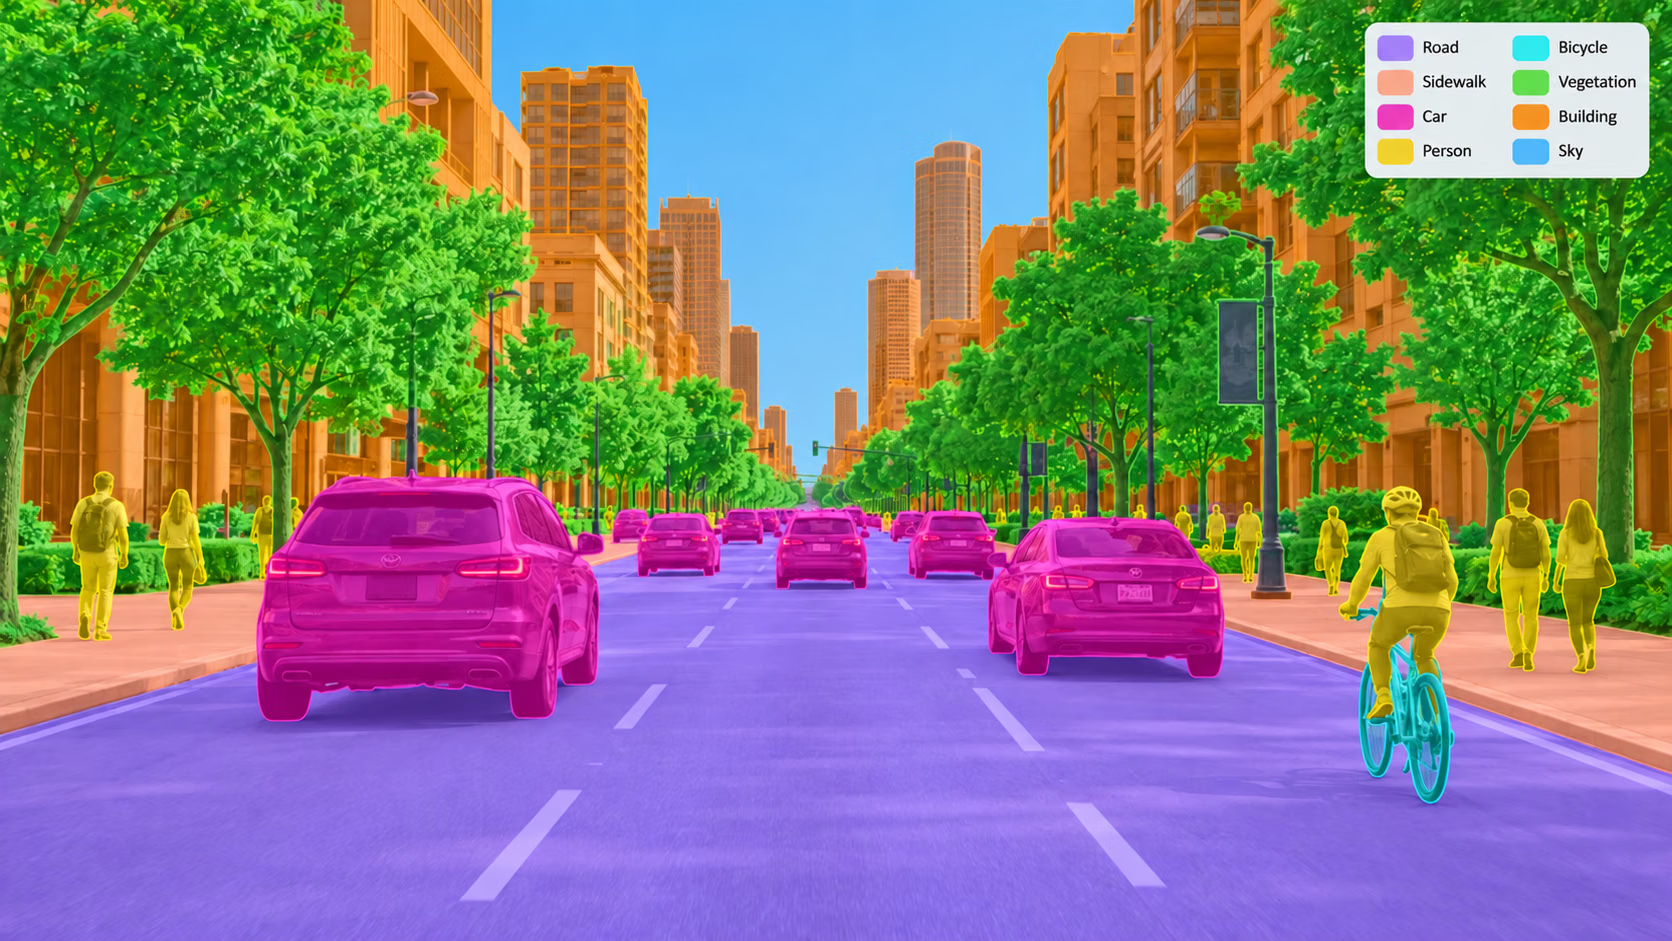
Segmentation instance (segment) | Segmentation ngữ nghĩa (semantic) | |
|---|---|---|
| Đầu ra | một mask cho mỗi đối tượng, kèm một box | một ID lớp cho mỗi pixel |
| Đếm đối tượng | có | không — hai ô tô chạm nhau tạo thành một vùng "ô tô" |
| Xử lý các vùng "stuff" (đường, bầu trời, cỏ) | kém — không có instance tự nhiên | có |
| Nhãn | đa giác | bản đồ lớp PNG hoặc đa giác |
| Metric kiểm soát | mAP50-95 của mask | mIoU |
| Weights pretrained | yolo26n-seg.pt (COCO, 80 lớp) | yolo26n-sem.pt (Cityscapes, 19 lớp) |
Nếu câu hỏi ở bước tiếp theo là "có bao nhiêu", hãy dùng instance segmentation. Nếu câu hỏi là "bao nhiêu" hoặc "ở đâu", semantic segmentation dễ gán nhãn và đọc kết quả hơn. Trang tác vụ Semantic Segmentation có bảng model.
Dự đoán bản đồ lớp#
result.semantic_mask.data là tensor H × W ở kích thước ảnh gốc; mỗi giá trị là một ID lớp và 255 nghĩa là bỏ qua. result.summary() chuyển tensor này thành tỷ lệ pixel theo từng lớp:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Hãy xem hàng cuối cùng. Cityscapes có lớp bus, nhưng model lại phân loại xe buýt thành train. Model được huấn luyện trên cảnh quay từ xe gắn camera, chủ yếu ghi lại đường phố ở Đức; xe buýt được chụp từ vỉa hè ở cự ly gần nằm ngoài phân phối đó. Model ngữ nghĩa kế thừa góc nhìn và định nghĩa lớp của tập dữ liệu huấn luyện — tức độ chệch của tập dữ liệu — cứng nhắc hơn detector, vì vậy hãy fine-tune trên camera của riêng bạn trước khi tin cậy bản đồ.
Chuyển bản đồ lớp thành câu trả lời#
Có thể chuyển bản đồ lớp thành một con số có ý nghĩa với sản phẩm bằng các phép so sánh tensor đơn giản. Sau đây là câu trả lời cho câu hỏi "trong vùng người đi bộ có thể bước vào, đường hoặc vỉa hè chiếm bao nhiêu, còn người chiếm bao nhiêu?":
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personBa thói quen giúp những con số này đáng tin cậy:
- Tra cứu ID theo tên từ
result.names, không dùng số được hard-code; model huấn luyện trên các lớp của riêng bạn sẽ đánh số chúng khác đi. - Giới hạn phạm vi vào vùng cần quan tâm. Tỷ lệ trên toàn khung hình sẽ tính cả bầu trời và các tòa nhà; trước tiên hãy cắt bản đồ lớp (hoặc nhân với mask vùng).
- Mở ảnh phủ lớp.
semantic_overlay.jpgcho thấy ngay liệu phần "đường" được tính trong con số đó có thực sự là đường hay không.
Định dạng tập dữ liệu#
Các tập dữ liệu segmentation ngữ nghĩa ghép mỗi ảnh với một ảnh mask một kênh, trong đó giá trị pixel là ID lớp. Hướng dẫn về tập dữ liệu ngữ nghĩa là tài liệu tham khảo; cấu trúc thư mục khớp từng tệp với images/:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
YAML bổ sung masks_dir và, khi ID được lưu trong mask khác với ID dùng để huấn luyện, một khối label_mapping:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Mask Cityscapes lưu ID nhãn thô từ -1 đến 33; phép ánh xạ giữ lại 19 ID và chuyển phần còn lại thành ignore_label, được lưu dưới dạng 255. Pixel có giá trị 255 sẽ bị loại khỏi cả loss lẫn metric — hãy dùng cùng giá trị này cho những vùng mà người gán nhãn không thể xác định.
Nếu bạn đã có nhãn đa giác nhưng không có masks_dir, data loader sẽ rasterize các đa giác giúp bạn và thêm một lớp background cho những pixel chưa được phủ.
Nén mất dữ liệu trộn lẫn giá trị pixel liền kề, biến đường biên giữa lớp 7 và lớp 8 thành vùng nhòe gồm các giá trị 7, 8 và những ID không tồn tại. Hãy lưu mọi mask dưới dạng PNG hoặc TIFF.
Huấn luyện và đọc mIoU#
Cityscapes8 có 8 ảnh cảnh đô thị, gồm 4 ảnh huấn luyện và 4 ảnh validation, đủ cho một bài kiểm tra nhanh trên CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Đã lược bớt các hàng theo từng lớp.) Độ chính xác pixel là 91%; mIoU là 42%; các hàng theo từng lớp cho thấy model không phát hiện được một người nào. Cả ba kết quả đều đúng. Đường, tòa nhà và thảm thực vật chiếm phần lớn pixel — riêng đường có 78,529 trên tổng số 192,315 — vì vậy model tô chính xác các lớp này sẽ đạt độ chính xác pixel cao dù bỏ sót mọi lớp nhỏ. mIoU tính trung bình IoU theo từng lớp với trọng số bằng nhau, nên mỗi lớp bị bỏ sót đều kéo chỉ số xuống.

Đặt ngưỡng theo mIoU và IoU của các lớp mà sản phẩm sử dụng. Tính năng an toàn cho người đi bộ có IoU của lớp người bằng 0 vẫn thất bại, bất kể độ chính xác pixel cho biết điều gì.
Hiển thị lời giải
Trong lượt chạy của chúng tôi: mIoU 0.415, độ chính xác pixel 0.906 và IoU bằng 0 cho tường, người, người đi xe, xe máy và xe đạp, cùng mọi lớp không có pixel trong bốn ảnh validation.
Độ chính xác pixel cao hơn vì chỉ số này đếm pixel, trong khi đường, tòa nhà, thảm thực vật và bầu trời chiếm phần lớn mỗi khung hình Cityscapes. mIoU tính trọng số bằng nhau cho từng lớp, nên năm lớp nhỏ bị bỏ sót kéo điểm trung bình xuống dù tổng diện tích của chúng chỉ vài trăm pixel. Với sản phẩm có hành động dựa trên người, riêng IoU của lớp người đã khiến model này không đạt yêu cầu.