Huấn luyện Image Classifier
Sắp xếp dataset theo thư mục, huấn luyện yolo26n-cls.pt trên MNIST160, đọc probs và độ chính xác top-1, rồi chuyển các dự đoán có độ tin cậy thấp cho người đánh giá.
Phân loại ảnh trả lời một câu hỏi cho mỗi ảnh: đây là gì? Công việc này cần loại nhãn đơn giản nhất trong mọi tác vụ — tên thư mục — và chạy nhanh nhất, nên đây là lựa chọn mặc định ở giai đoạn thứ hai sau detector, đồng thời là model đầu tiên phù hợp cho trạm kiểm tra chỉ nhìn thấy một bộ phận trong mỗi frame. Dataset không có YAML, vì vậy cấu trúc thư mục chính là quy ước, và classifier luôn đưa ra câu trả lời, kể cả với những ảnh hoàn toàn xa lạ. Biết khi nào không nên tin kết quả là một nửa công việc.
Thực hành
Bố cục dataset theo thư mục#
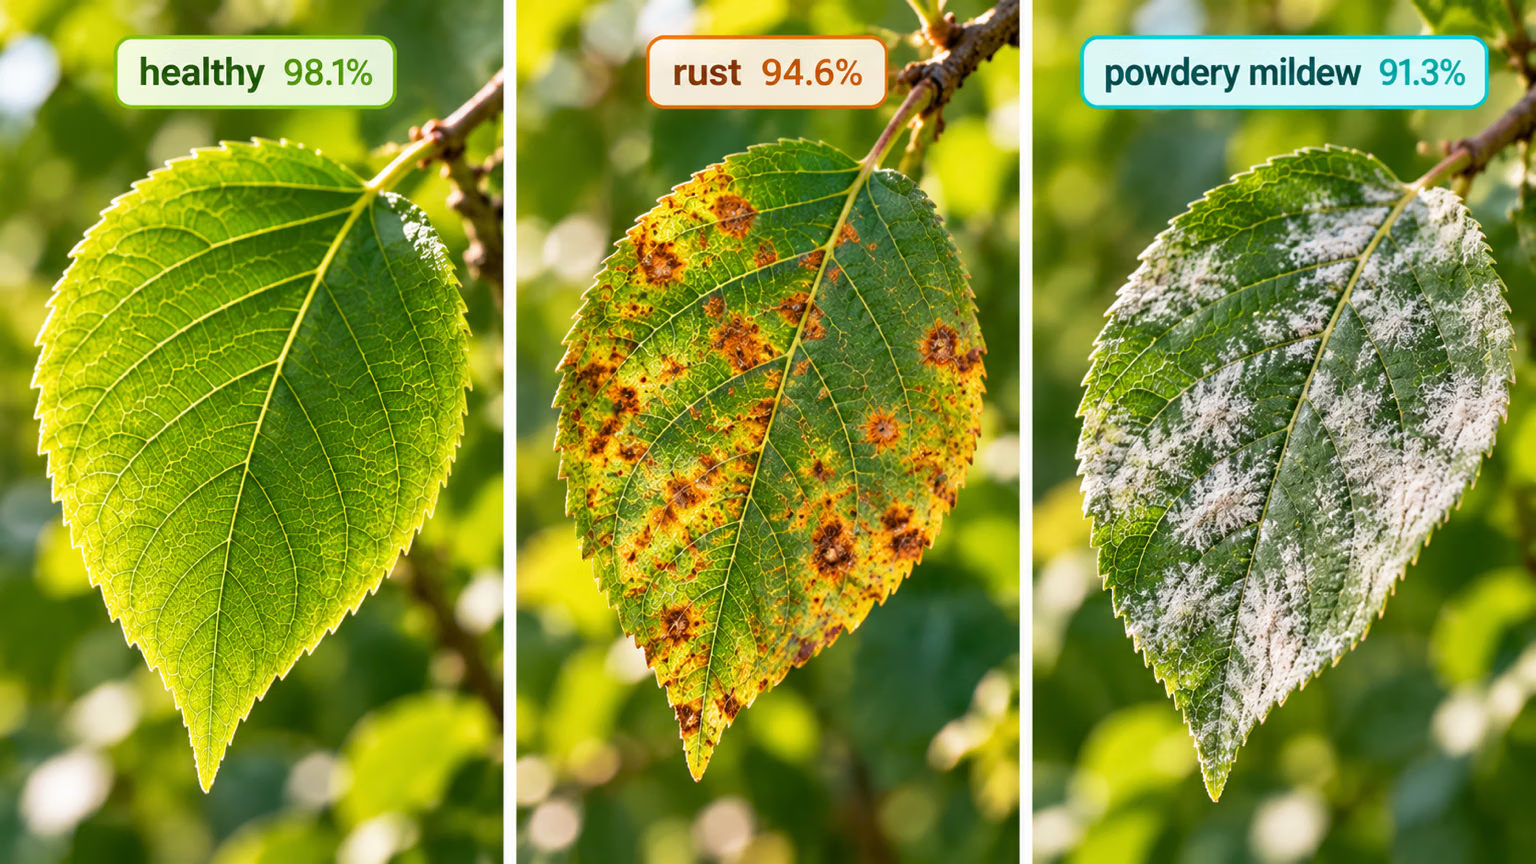
Dataset phân loại là các thư mục, không phải tệp YAML. Trỏ data= đến thư mục gốc:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Cách bộ nạp xử lý dữ liệu, dựa trên source đã cài đặt và hướng dẫn dataset phân loại:
| Tình huống | Hành vi |
|---|---|
| Chỉ số lớp | tên thư mục bên trong train/, sắp xếp theo thứ tự bảng chữ cái → dent=0, good=1, scratch=2 |
| Thư mục validation | val/, sau đó validation/, rồi valid/; nếu không có, dùng test/ kèm cảnh báo |
Không có thư mục train/, chỉ có các thư mục lớp | tự động chia dữ liệu theo tỷ lệ 80/20 vào train/ và val/ |
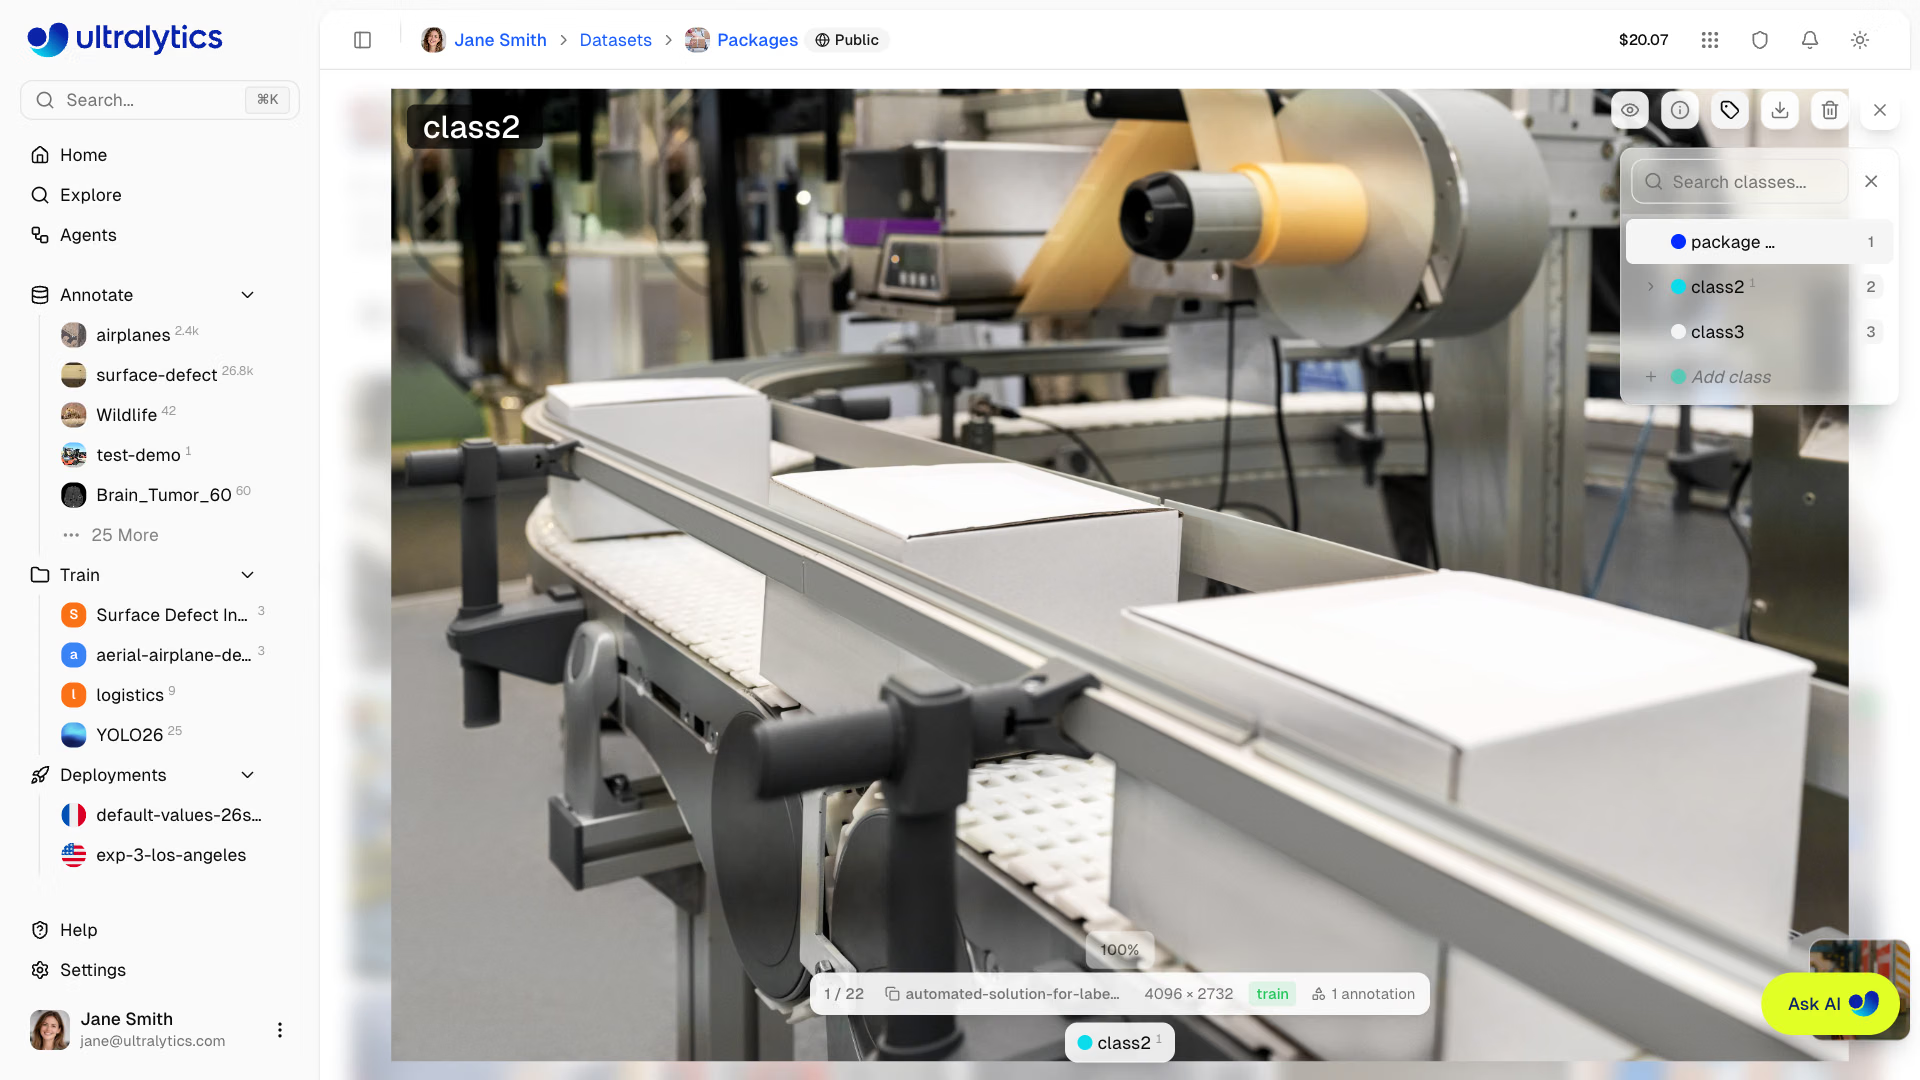
Trên Ultralytics Platform, dataset phân loại có một nhãn cấp ảnh cho mỗi ảnh thay vì các shape:
Triệu chứng: sau khi thêm một lớp, integration cũ báo các phần good thành dent. Nguyên nhân: thêm một thư mục tên bent khiến thư mục đó được sắp xếp lên đầu và đẩy mọi chỉ số phía sau. Cách khắc phục: luôn ánh xạ chỉ số sang tên bằng model.names (hoặc result.names); không bao giờ hard-code chỉ số.
Huấn luyện trên MNIST160#
MNIST160 gồm 160 chữ số viết tay, 80 chữ số trong train/ và 80 chữ số trong test/, mỗi tập được chia thành mười thư mục chữ số — đủ nhỏ để chạy kiểm tra nhanh trên CPU. Dataset không có thư mục val/, vì vậy hãy theo dõi cảnh báo của bộ nạp khi nó chuyển sang dùng test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Một epoch hầu như không cải thiện được head mười lớp mới. Trong lần chạy của chúng tôi, epochs=10 đạt top-1 0.55 và top-5 0.95 trong khoảng mười giây trên CPU của laptop — vòng lặp hoạt động, nhưng cần lịch huấn luyện dài hơn. Hướng dẫn tác vụ Classify liệt kê các kích thước model pretrained.
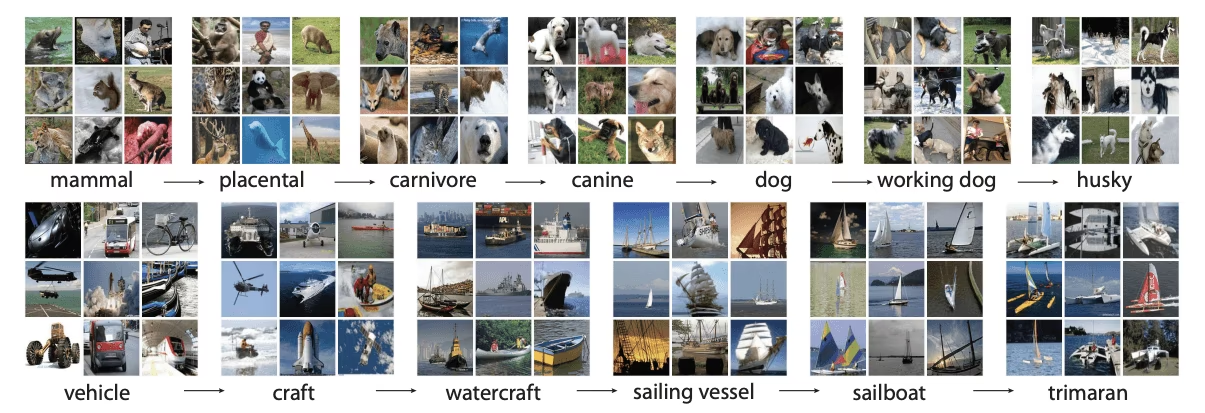
Top-1 là tỷ lệ ảnh có lớp xác suất cao nhất được dự đoán đúng. Top-5 tính là đúng nếu lớp chính xác nằm trong năm lớp có xác suất cao nhất. Top-5 hữu ích với ImageNet có 1.000 lớp, với các lớp trải từ khái quát đến rất chi tiết; với năm lớp trở xuống, chỉ số này luôn bằng 1.0, còn với mười lớp thì vẫn khá dễ đạt. Hãy đánh giá dựa trên độ chính xác top-1 cùng ma trận nhầm lẫn theo từng lớp.
Đọc xác suất trong code#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 là một chỉ số, probs.top5 là danh sách các chỉ số, còn probs.data là vector xác suất đầy đủ. Hãy chú ý độ tin cậy top-1: 0.52 chỉ nhỉnh hơn một chút so với tung đồng xu để phân biệt minibus và police_van. Đây là giá trị dùng để quyết định chuyển kết quả.
Chuyển các dự đoán không chắc chắn cho người đánh giá#
Classifier trong môi trường production hiếm khi cần dự đoán đúng mọi ảnh; điều quan trọng là dự đoán đúng những ảnh mà model tự đưa ra quyết định. Script này huấn luyện model trong 10 epoch, sau đó đo lường tác động của các ngưỡng độ tin cậy khác nhau trên 80 chữ số giữ lại để đánh giá:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Mỗi hàng thể hiện một sự đánh đổi: tăng ngưỡng giúp các dự đoán được chấp nhận chính xác hơn và chuyển nhiều ảnh hơn cho người đánh giá. Ở ngưỡng 0.6, model này chỉ tự quyết định 10 trong số 80 chữ số — model chưa sẵn sàng tự động hóa bất kỳ việc gì, và giải pháp là huấn luyện thêm chứ không phải chọn ngưỡng khéo hơn. Chạy lại cùng bảng sau mỗi vòng huấn luyện: bảng cho bạn biết cả độ chính xác sẽ đạt được lẫn chính xác lượng công việc đánh giá mà mỗi ngưỡng tạo ra.
Chọn ngưỡng thấp nhất sao cho độ chính xác trên các ảnh được chấp nhận đáp ứng yêu cầu của bạn, được đo trên dữ liệu giữ lại để đánh giá. Sau đó kiểm tra xem lượng ảnh cần rà soát mà ngưỡng này tạo ra có nằm trong khả năng xử lý của nhóm hay không; nếu không, hãy cải thiện model.
Các lỗi thường gặp#
Triệu chứng: một trạm trống, một linh kiện sai hoặc bàn tay che ống kính vẫn được gán nhãn lớp với độ tin cậy cao. Nguyên nhân: xác suất softmax luôn có tổng bằng 1, vì vậy bộ phân loại luôn chọn một trong các lớp của nó. Cách khắc phục: thêm thư mục other/ chỉ chứa những ảnh đó, và chuyển các dự đoán top1conf thấp sang bước rà soát.
Triệu chứng: model đã huấn luyện trước đạt điểm gần bằng 0 trên dataset của bạn trước khi được huấn luyện. Nguyên nhân: yolo26n-cls.pt dự đoán 1.000 chỉ số ImageNet, còn các thư mục của bạn dùng lại chỉ số 0–9 với ý nghĩa khác: trên MNIST160, thư mục 0 có chỉ số 0, nhưng head đã huấn luyện trước gọi đó là tench. Khi làm theo cách này, chúng tôi đo được top-1 là 0.000. Cách khắc phục: tinh chỉnh trước, sau đó mới validation.
Triệu chứng: top-1 gần 1.0 trong validation nhưng thấp hơn nhiều trong production. Nguyên nhân: có các ảnh gần như trùng lặp của cùng một linh kiện trong train/ và val/. Cách khắc phục: chia theo linh kiện hoặc theo phiên, như hướng dẫn Chia dataset đúng cách.
Classifier được pretrained ở imgsz=224, không phải 640. Với các đối tượng nhỏ nằm trong frame lớn, detect rồi classify (bài học tiếp theo) thường phù hợp hơn việc dùng imgsz lớn hơn.
Hiển thị lời giải
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Kết quả các lần chạy của chúng tôi: 1 epoch → top-1 0.162, top-5 0.463; 10 epoch → top-1 0.550, top-5 0.950. Với năm lớp, đáp án đúng luôn nằm trong top năm, vì vậy top-5 bằng 1.0 theo cách thiết lập và không cho bạn biết điều gì.
Để đạt độ chính xác 75% trên các ảnh được chấp nhận, route.py cho biết ngưỡng là 0.6 (độ chính xác 80% trên 10 ảnh được chấp nhận), đồng nghĩa với việc chuyển 70 trong số 80 chữ số sang đánh giá. Đó là câu trả lời trung thực: ngưỡng đáp ứng yêu cầu độ chính xác, nhưng model vẫn chưa hữu ích. Hãy huấn luyện lâu hơn và chạy lại bảng trước khi chọn ngưỡng để sử dụng thực tế.