在一个流水线中组合多个任务
构建先检测再分类的级联流程,让每个被跟踪的目标只分类一次而不是每帧都分类,并将姿态关键点转换为逐人的时间序列。
检测之外最实用的系统通常由两个模型组成,而不是一个。检测器找出每位工人,分类器判断每顶安全帽的类型是否正确;姿态模型找出关节,跟踪器则将关节转换为时间线,以便统计重复次数。代码很短。真正会让这些系统出问题的是第二阶段数据集与第一阶段裁剪图像不匹配,以及成本会随着每帧的每个目标而增加——如果直接运行,一个包含十个人的 30 FPS 视频流每秒需要进行 300 次分类。
实践操作
两种模式覆盖大多数产品需求#
两种模式都从同一帧和同一个 Ultralytics API 开始;它们的区别在于第二阶段处理的输入不同。目标跟踪的跟踪器选择、调优和流处理,请参阅使用 ByteTrack、BoT-SORT 和 TrackTrack 跟踪目标;这里我们重点介绍如何串联这些任务。
先检测,再对裁剪图像分类#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)这套流程是正确的:裁剪图像来自 orig_img,保持完整分辨率,并使用检测器自己的像素坐标;分类器会在一次批处理调用中处理所有裁剪图像。这里的标签故意设置得毫无意义。
ImageNet 分类器从未用紧密裁剪、部分被裁切的街景人物图像训练过,因此只能猜测——注意,置信度都不超过 0.50。用清晰产品照片训练的分类器接收模糊的检测器裁剪图像时,也会出现同样的问题。
使用你自己的裁剪图像构建第二阶段数据集#
获得匹配数据的可靠方法是让检测器生成这些数据:
- 使用
save_crop=True在具有代表性的视频素材上运行检测器,例如yolo predict model=best.pt source=footage/ save_crop=True。裁剪图像会保存在runs/detect/predict/crops/<class>/中。 - 将每个类别的裁剪图像整理到细分类别文件夹中(
helmet_ok/、helmet_missing/)——这正是上一课介绍的分类数据集结构。 - 使用这些文件夹训练分类器,并在来自不同日期或摄像头的裁剪图像上验证。
由于裁剪图像由检测器生成,因此包含真实的取景、模糊和遮挡情况——这与分类器在生产环境中看到的情况完全相同——而且在这些图像上进行微调就是常规的迁移学习。
每个跟踪 ID 只分类一次#
安全帽不会在不同帧之间发生变化,因此对每一帧中的每个框都进行分类是在浪费计算。跟踪检测结果,并且只对每个新的跟踪 ID 分类一次:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}在 11 帧的片段中,分类器调用次数从 33 次降到 3 次;在长视频流中,随着每个人在画面中停留的时间增加,节省的计算量也会不断增加。标签仍然是 ImageNet 的猜测结果——换成你微调后的分类器,就能得到每个人对应的分类结果。
如果目标在视野内时属性不会改变(头盔类型、车辆品牌、产品 SKU),则每条轨迹分类一次。如果属性可能改变(门打开、手举起),则每 N 帧重新分类一次。如果目标刚出现时通常较小且模糊,则改为在轨迹框最大的一帧进行分类。
姿态加跟踪#
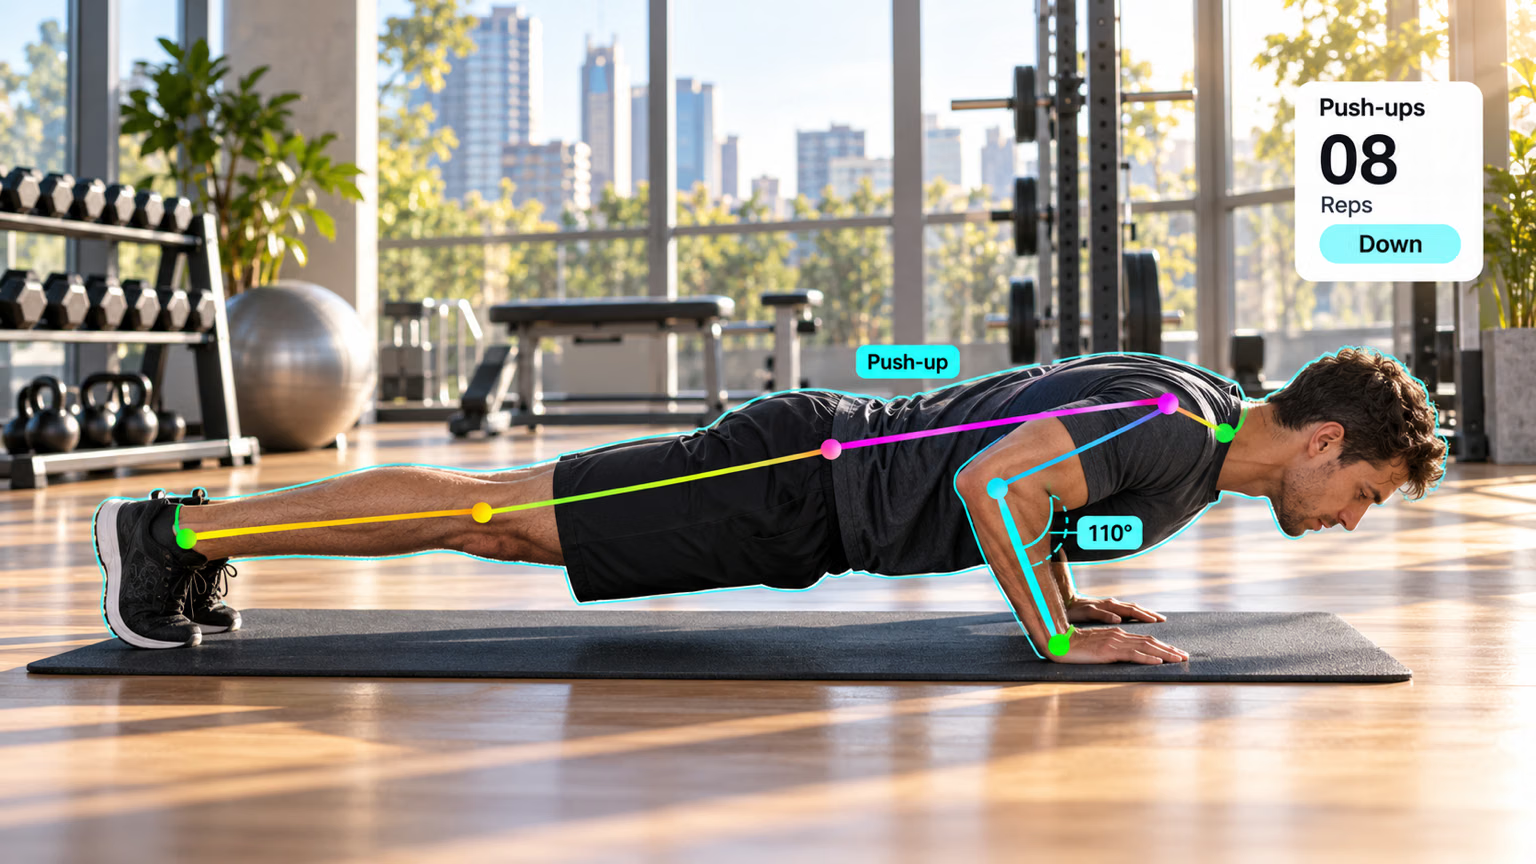
跟踪模式会为每个人分配一个持久的 result.boxes.id,因此关键点可以构成时间序列。这个脚本会记录同一段短视频中每个人左膝的角度:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degID 2 的弯曲膝盖与片段中坐着的人相符;另外两个人站立,腿部伸直,角度接近 180°。接下来,可以根据每个 ID 的角度序列检测阈值交叉来统计重复次数——角度低于一个阈值时向下,然后高于另一个阈值时再向上——这正是锻炼监控解决方案为你提供的功能。
为这条处理链规划计算预算#
| 成本驱动因素 | 先检测再分类 | 姿态加跟踪 |
|---|---|---|
| 随什么变化 | 每帧的目标数 | 帧数 |
| 主要调节手段 | 批量裁剪;每个跟踪 ID 只分类一次并缓存 | 运动缓慢时,降低 imgsz 或 vid_stride |
| 故障模式 | 分类器看到的裁剪图与训练数据不同 | ID 切换会将同一个人的历史记录拆成两段 |
症状:计数器在一组动作中途重置,或同一个人出现两个 ID。原因:跟踪器丢失了该人(被遮挡、快速转身),随后分配了新 ID。解决方法:按照生产课程中的说明调整跟踪器,并让每 ID 逻辑能够容忍短暂间断——缓存的分类器标签会为新 ID 重新计算。
显示解答
将 save_crop=True 添加到检测器调用中:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]裁剪图出现在 runs/detect/predict*/crops/person/ 和 crops/bus/ 下(每次预测运行都会递增运行文件夹名称)。按跟踪 ID 缓存后,33 个人物框只触发了 3 次分类器调用;在 11 帧的视频片段中,减少了 30 次调用。
要统计膝盖角度,请替换 pose_track.py 的最后一个循环:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 deg坐着的人(ID 2)在全部 11 帧中的角度都低于 120°;ID 1 和 ID 3 则从未低于 120°。