评估并交付每项任务
为每项任务设定适用于部署尺寸的专属指标门槛,在一个循环中验证所有任务,并将每项任务导出为 ONNX,且验证预测结果。
每项任务对正确的定义各不相同:像素重叠度、关键点相似度、旋转框 IoU、top-1 命中,或深度比。沿用检测检查清单的团队,可能会用框 mAP 作为分割模型的门槛,或用并非产品目标的框作为姿态模型的门槛。即使模型通过了门槛,导出后仍可能失效:本课中,同一组姿态权重在一种输入尺寸下检测到 5 个人,在另一种尺寸下只检测到 3 个;深度模型测得的距离则几乎翻倍。
实践操作
每项任务设定一个门槛#
| 任务 | 门槛指标 | results_dict 键 | Python 属性 | 评分依据 |
|---|---|---|---|---|
| 分割 | 掩码 mAP50-95 | metrics/mAP50-95(M) | metrics.seg.map | 每个实例的像素 IoU |
| 语义分割 | mIoU(+ 每类 IoU) | metrics/mIoU | metrics.miou | 每类像素 IoU |
| 姿态 | 姿态 mAP50-95 | metrics/mAP50-95(P) | metrics.pose.map | OKS |
| obb | OBB mAP50-95 | metrics/mAP50-95(B) | metrics.box.map | 旋转框 IoU |
| 分类 | top-1 准确率 | metrics/accuracy_top1 | metrics.top1 | 正确的 top 类别 |
| 深度 | δ1(+ AbsRel) | metrics/delta1 | metrics.delta1 | 深度值与真实深度相差不超过 1.25 倍的像素占比 |
性能指标指南介绍了每项评分。分割和姿态运行也会报告框指标;请将这些指标作为诊断信息保留——框与掩码之间的差距可以反映轮廓质量——但它们不是产品本身。阈值扫描和混淆矩阵等检测专属分析,可沿用验证与诊断中的方法。
在一个循环中验证所有任务#
验证模式接受任意任务的权重,只需搭配相应数据集即可,因此一个循环就能生成发布表所需的指标:
from ultralytics import YOLO

runs = {
    "yolo26n-seg.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)"),
    "yolo26n-sem.pt": ("cityscapes8.yaml", "metrics/mIoU"),
    "yolo26n-pose.pt": ("coco8-pose.yaml", "metrics/mAP50-95(P)"),
    "yolo26n-obb.pt": ("dota8.yaml", "metrics/mAP50-95(B)"),
    "yolo26n-depth.pt": ("depth8.yaml", "metrics/delta1"),
}
for weights, (data, key) in runs.items():
    metrics = YOLO(weights).val(data=data, device="cpu", plots=False, verbose=False)
    print(f"{weights:17s} {key:22s} {metrics.results_dict[key]:.3f}")
yolo26n-seg.pt metrics/mAP50-95(M) 0.538
yolo26n-sem.pt metrics/mIoU 0.610
yolo26n-pose.pt metrics/mAP50-95(P) 0.419
yolo26n-obb.pt metrics/mAP50-95(B) 0.857
yolo26n-depth.pt metrics/delta1 0.377如果不显式指定 imgsz,每个模型都会以训练时的尺寸进行验证:分割和姿态为 640,深度为 768,语义分割和 OBB 为 1024。这些预训练模型的数值高于课程前面 320 像素训练运行的结果——部分原因是训练效果,部分原因是分辨率。这里每项指标都基于 4 张验证图像,只能作为冒烟测试;例如,深度任务页面报告的是完整 NYU 基准上的 δ1。这里有意省略了分类:请像分类器课程中那样,使用分类器自己的文件夹验证微调后的分类器。
同一组权重在不同 imgsz 下的得分也不同。记录每个数值对应的 imgsz,在实际部署的尺寸下验证,并且不要比较不同尺寸下测得的数值。
导出每项任务#
每项任务都使用相同的导出模式调用导出为 ONNX。任务信息会保存在模型元数据中,因此 YOLO("model.onnx") 会应用正确的后处理。运行时选择、结果一致性检查以及 TensorRT 或 OpenVINO 调优,请参阅导出为 ONNX(并验证结果一致性);此循环会检查每项任务能否顺利完成往返流程:
from ultralytics import YOLO

for weights in ["yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]:
    onnx_path = YOLO(weights).export(format="onnx", imgsz=320)
    onnx_model = YOLO(onnx_path)  # task comes from the ONNX metadata
    result = onnx_model("https://ultralytics.com/images/bus.jpg", imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:9s} {result.verbose()}")
segment 4 persons, 1 bus,
semantic
pose 3 persons,
obb (no detections),
classify minibus 0.38, police_van 0.21, trolleybus 0.05, amphibian 0.05, bullet_train 0.03,
depth depth 4.67-26.91m,每个导出文件重新加载后都识别出了正确的任务。有三项结果值得再仔细检查:
- 姿态模型在 320 像素下检测到 3 个人,而 640 像素下的 PyTorch 运行检测到了 5 个。
- 深度模型将场景读为 4.7–26.9 米,而同一组权重在原生 768 像素下读出的距离为 2.1–14.9 米。
- OBB 模型在街景照片中没有检测到任何目标——对于航空图像模型,这是正确行为,并非导出错误。
imgsz=320 下的 PyTorch 结果与 ONNX 的姿态和深度数值相同,因此这两者都不是导出错误:改变输入尺寸就会改变结果。请按你验证过的 imgsz 导出。语义分割没有逐对象摘要行,因此请改为检查 result.semantic_mask。
在把导出模型判定为故障或交付之前,先用一张与训练数据相似的图像对每个导出模型进行一次预测——COCO 模型用街景图像,OBB 用航拍图块,深度模型则用合适尺度的室内或街景图像。
如果你要编写自己的后处理,以下是导出日志中 imgsz=320 下的原始 ONNX 输出:
| 任务 | ONNX 输出形状 | 内容 |
|---|---|---|
| 分割 | (1, 116, 2100) 和 (1, 32, 80, 80) | 框 + 80 个类别分数 + 32 个掩码系数;掩码原型 |
| 语义分割 | (1, 320, 320) | 类别图,argmax 已在计算图中完成 |
| 姿态 | (1, 56, 2100) | 框 + 1 个分数 + 17 × 3 个关键点值 |
| obb | (1, 20, 2100) | 框 + 15 个类别分数 + 1 个角度 |
| 分类 | (1, 1000) | 类别概率 |
| 深度 | (1, 1, 320, 320) | 每像素深度(米) |
在 Ultralytics Platform 上,模型页面会显示该任务自身的指标(例如分割模型的掩码 mAP),下方的导出选项卡则可生成相同格式的文件:

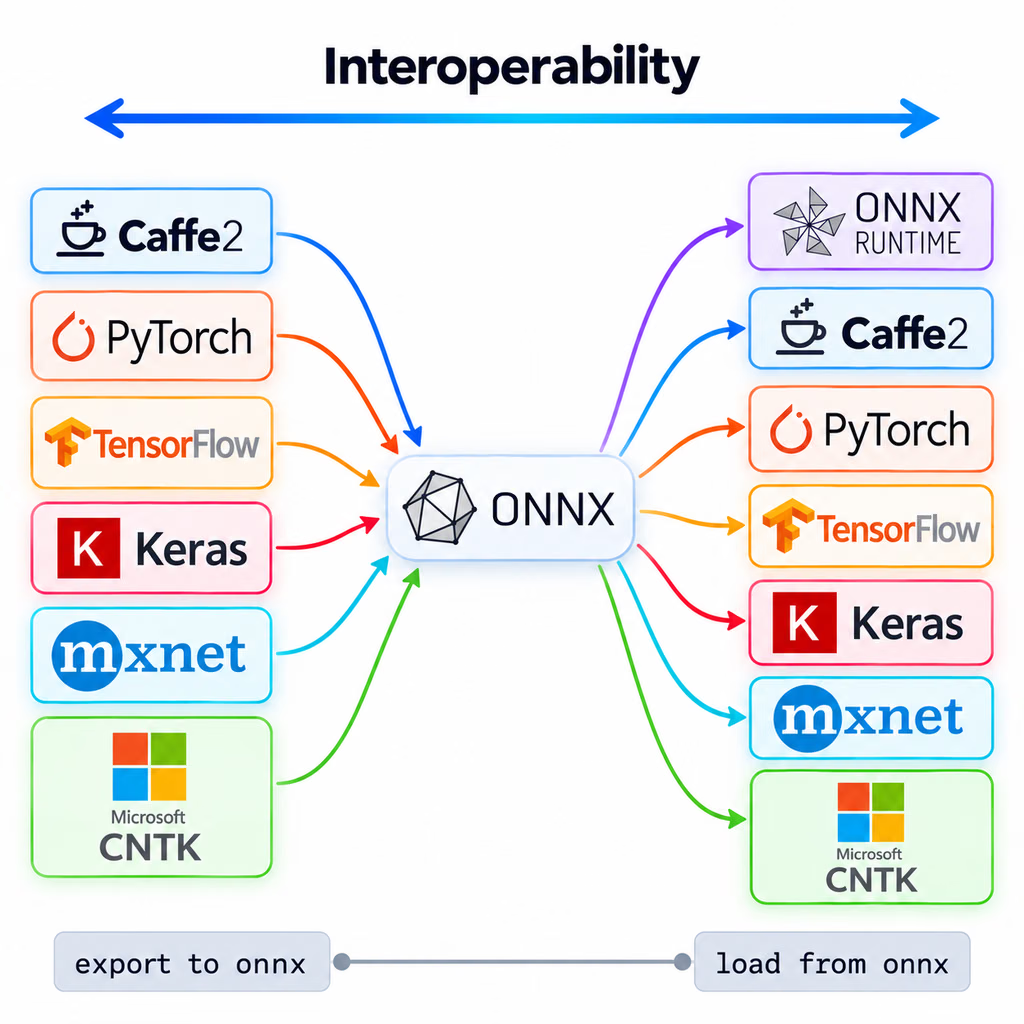
ONNX 是模型交换格式:一个导出的文件既能在 ONNX Runtime 中运行,也能转换为其他运行时支持的格式。
交付检查清单#
- 上表中的门槛指标在留出集上达到目标,并且使用部署
imgsz进行评估。 - 导出的模型重新加载后具有预期的
task,并且在固定图像集上的预测与 PyTorch 一致。 - 每项任务的代码路径都能处理空结果:
masks is None、零个关键点、零个 OBB。 - 按照可观测性与漂移中的说明,记录下游数值(面积、角度、距离、类别概率),以便监测它们是否发生漂移。
未达到门槛时,“回到数据”通常意味着调整以下三项中的一项:
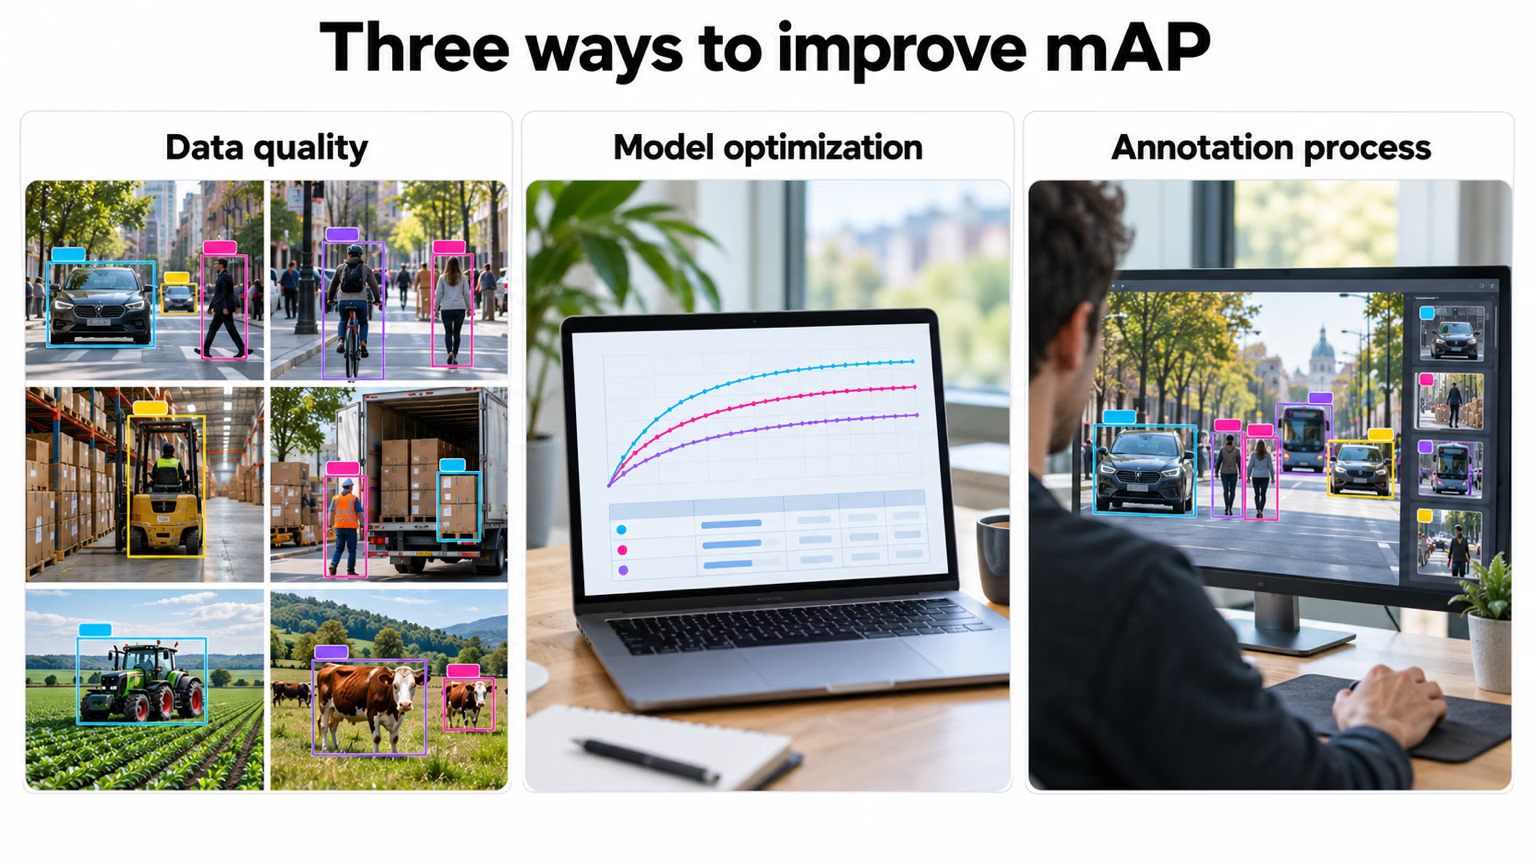
先改善数据质量和标注流程——第 2 课和第 6 课中的标签检查是成本最低的起点——只有在数据干净后才调整模型。
显示解答
from ultralytics import YOLO

checks = {
    "runs/segment/train/weights/best.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)", "https://ultralytics.com/images/bus.jpg"),
    "runs/obb/train/weights/best.pt": ("dota8.yaml", "metrics/mAP50-95(B)", "https://ultralytics.com/images/boats.jpg"),
}
for weights, (data, key, image) in checks.items():
    model = YOLO(weights)
    gate = model.val(data=data, imgsz=320, plots=False, verbose=False).results_dict[key]
    onnx_model = YOLO(model.export(format="onnx", imgsz=320))
    result = onnx_model(image, imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:8s} {key} @320 = {gate:.3f} | ONNX: {result.verbose()}")
将 runs/... 路径调整为训练运行打印出的文件夹(Results saved to ...)。使用第 2 课和第 7 课中的单轮训练运行:
segment  metrics/mAP50-95(M) @320 = 0.377 | ONNX: 4 persons, 1 bus,
obb metrics/mAP50-95(B) @320 = 0.832 | ONNX: 185 ships, 3 harbors,| 模型 | 门控指标 | 值 | 图像尺寸 | ONNX |
|---|---|---|---|---|
| 分割 | 掩码 mAP50-95 | 0.377 | 320 | 重新加载后识别为 segment,并检测到巴士和 4 个人 |
| obb | OBB mAP50-95 | 0.832 | 320 | 重新加载后识别为 obb,并检测到 185 艘船和 3 个港口 |
每项检查都使用其自身领域的图像:OBB 模型使用航空港口照片,而不是街景。两行都通过了导出检查;但两个模型都还不能交付,因为只训练 1 轮且只有 4 张验证图像,这只是冒烟测试,而非门槛验证。