自定义关键点与 OKS 指标
为非人类对象设计关键点方案,编写并检查数据集 YAML,并根据每个点可被定位的精度设置 OKS sigma。
姿势估计并非只适用于人。叉车货叉的尖端、包裹标签的角、动物的鼻子和尾巴——任何具有稳定且可命名点位的对象都可以构成姿势数据集。你在第一天编写的方案将永久沿用:每个标签、每组翻转配对和每项指标都取决于它,之后更改就意味着要重新标注所有数据。本课会在任何人标注上千张图像之前,帮你确定正确的方案,并准确说明指标将如何评估它。
实践操作
设计关键点方案#
好的关键点有三个共同特征:明确无歧义(两位标注者会把点放在同一位置)、稳定(对象呈现的每种姿势中都存在该点)以及有用(有下游计算会读取该点)。以顶置摄像头拍摄的叉车为例,产品要回答的问题是“卡车移动时货叉是否抬起?”:
| 索引 | 关键点 | 存在原因 | 镜像对应点 |
|---|---|---|---|
| 0 | left_fork_tip | 货叉的长度和方向 | 1 |
| 1 | right_fork_tip | 货叉的长度和方向 | 0 |
| 2 | mast_top | 货叉相对于门架的高度 | 2(自身) |
| 3 | mast_base | 车架上的参考点 | 3(自身) |
每个点都有其用途,因为它们都为计算提供信息:货叉尖端用于确定方向,门架上的一对点用于确定高度。对每个候选点都应用相同的筛选标准:
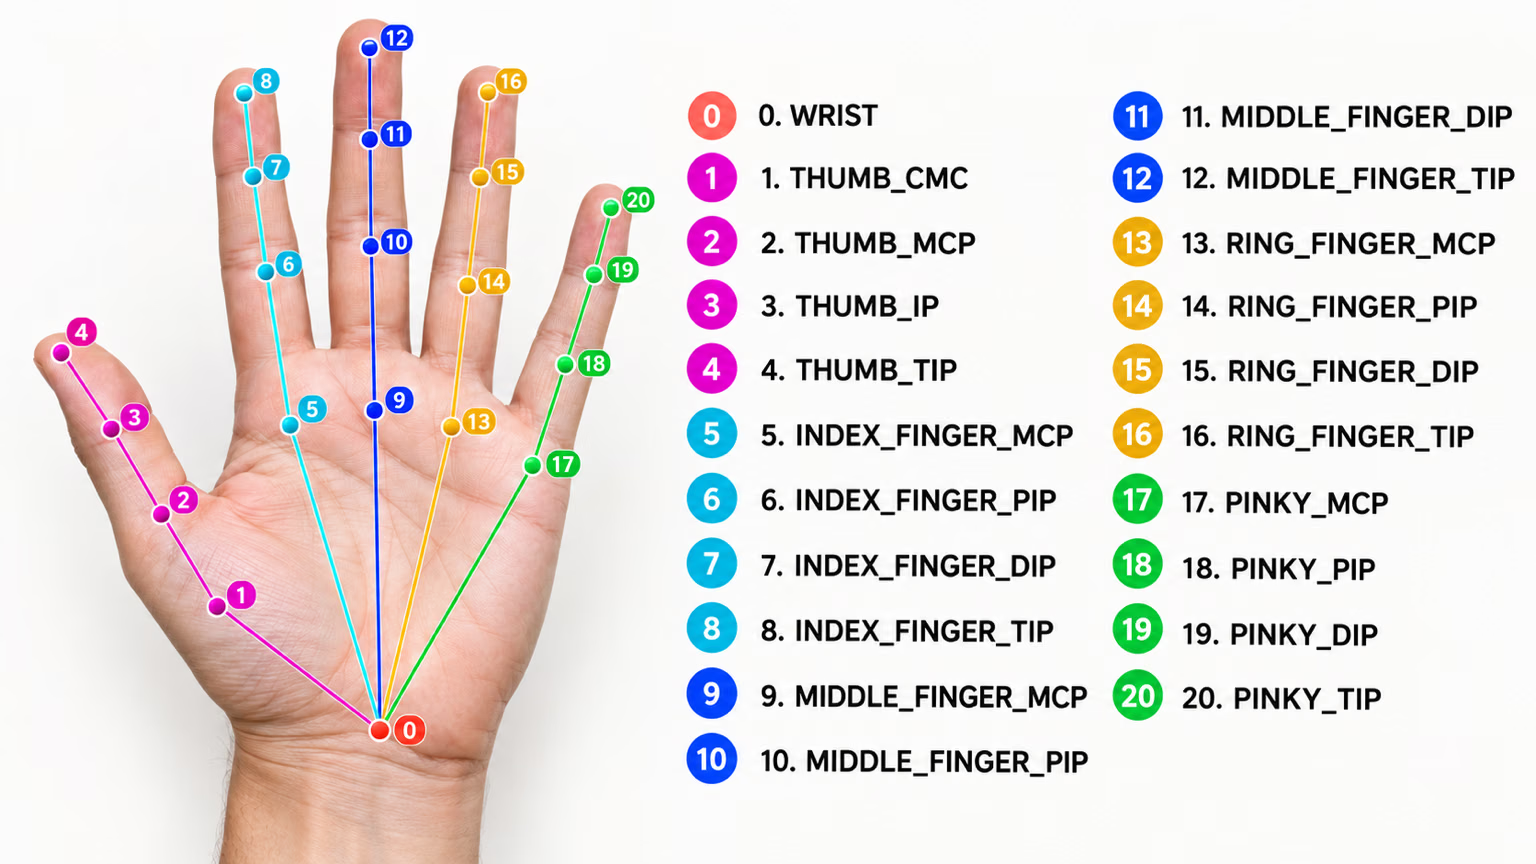
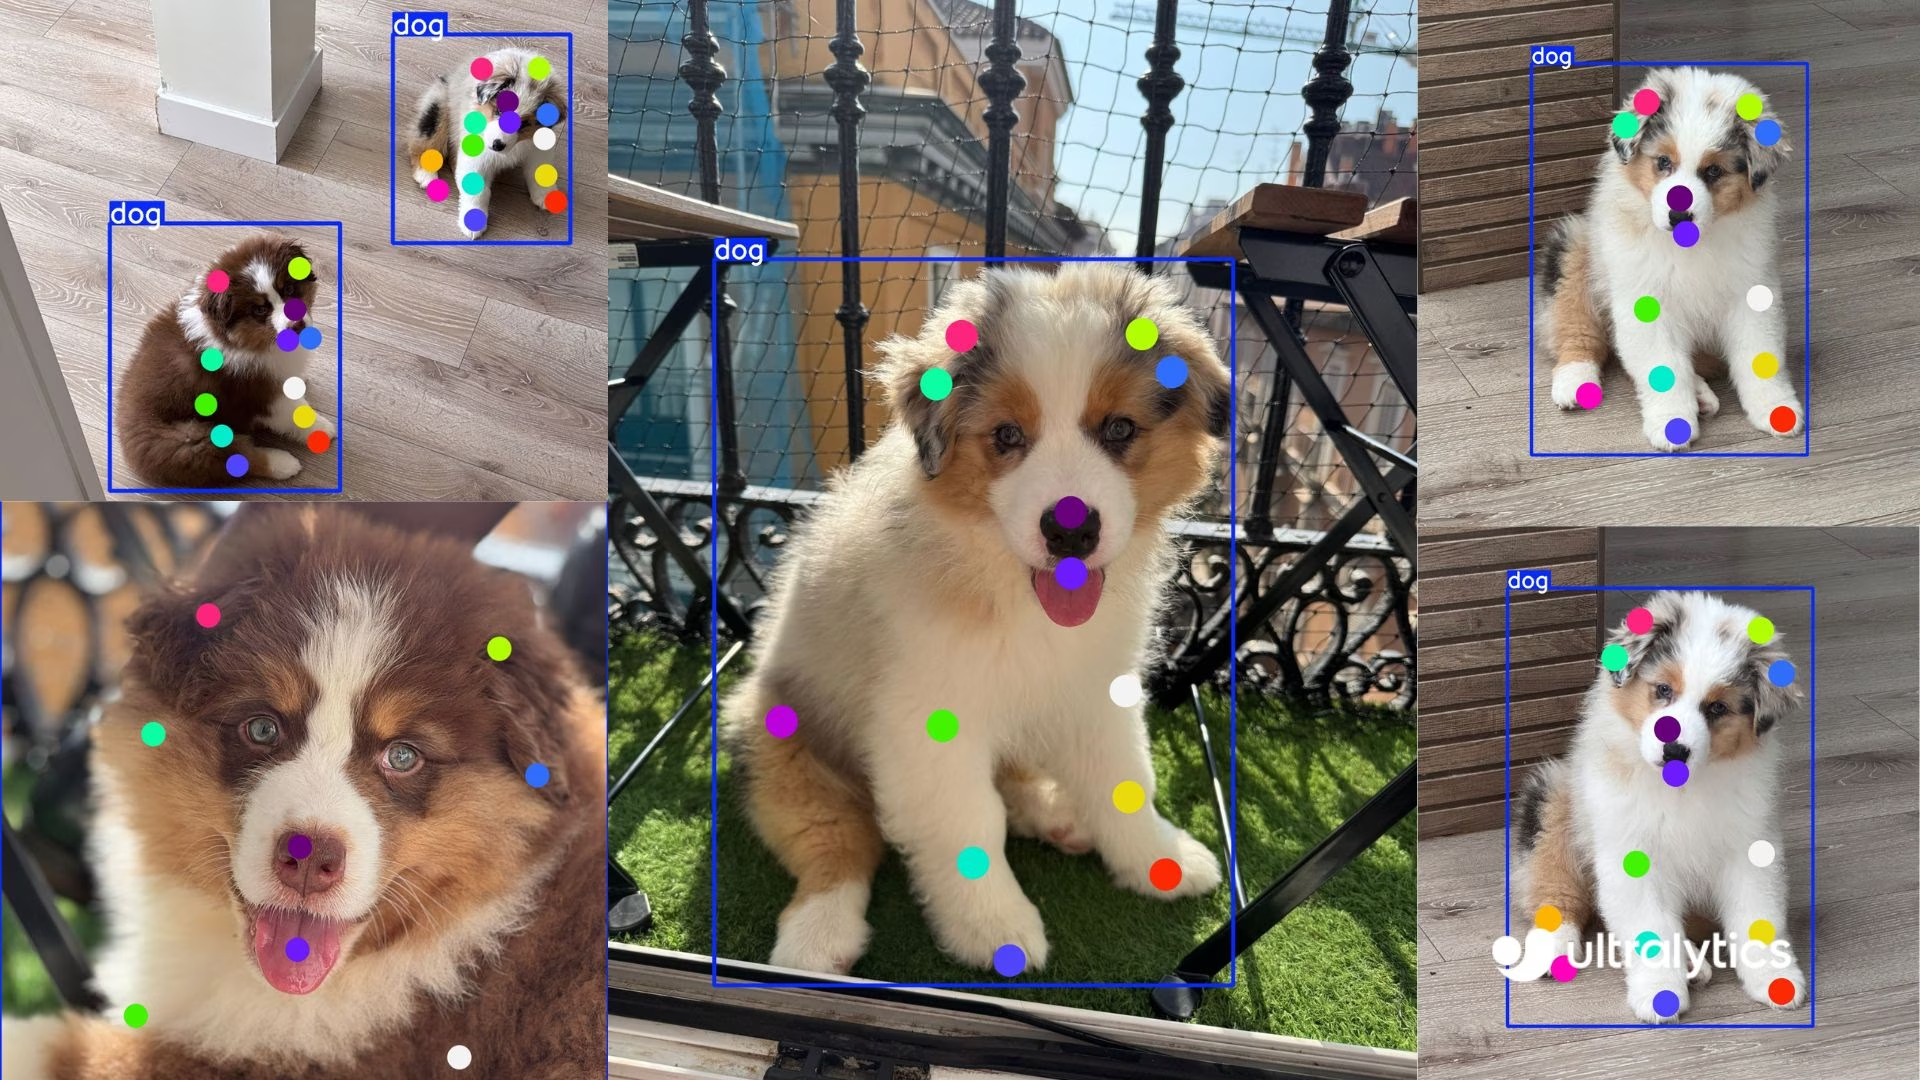
克制住“以防万一”而添加点的冲动:每个点都会增加每个实例的标注时间,而无人读取的点只会给指标增加噪声。公开数据集展示了不同规模:Tiger-Pose 使用 12 个点且不包含可见性,Dog-Pose 使用 24 个点,Hand Keypoints 使用 21 个点:
编写数据集 YAML#
path: forklift-pose
train: images/train
val: images/val

kpt_shape: [4, 3] # 4 keypoints, each x, y, visibility
flip_idx: [1, 0, 2, 3] # fork tips swap, mast points stay
kpt_oks_sigmas: [0.05, 0.05, 0.08, 0.08] # tips are sharp, mast ends are fuzzier

names:
  0: forklift

kpt_names:
  0:
    - left_fork_tip
    - right_fork_tip
    - mast_top
- mast_basekpt_names按类别记录人员和工具的关键点顺序。flip_idx必须能够还原自身:应用两次后,每个索引都应映射回自身。kpt_oks_sigmas是可选项,会同时对训练中的关键点损失和验证中的 OKS 加权;如果使用,它必须为每个关键点提供一个正值,否则运行会因ValueError而停止。
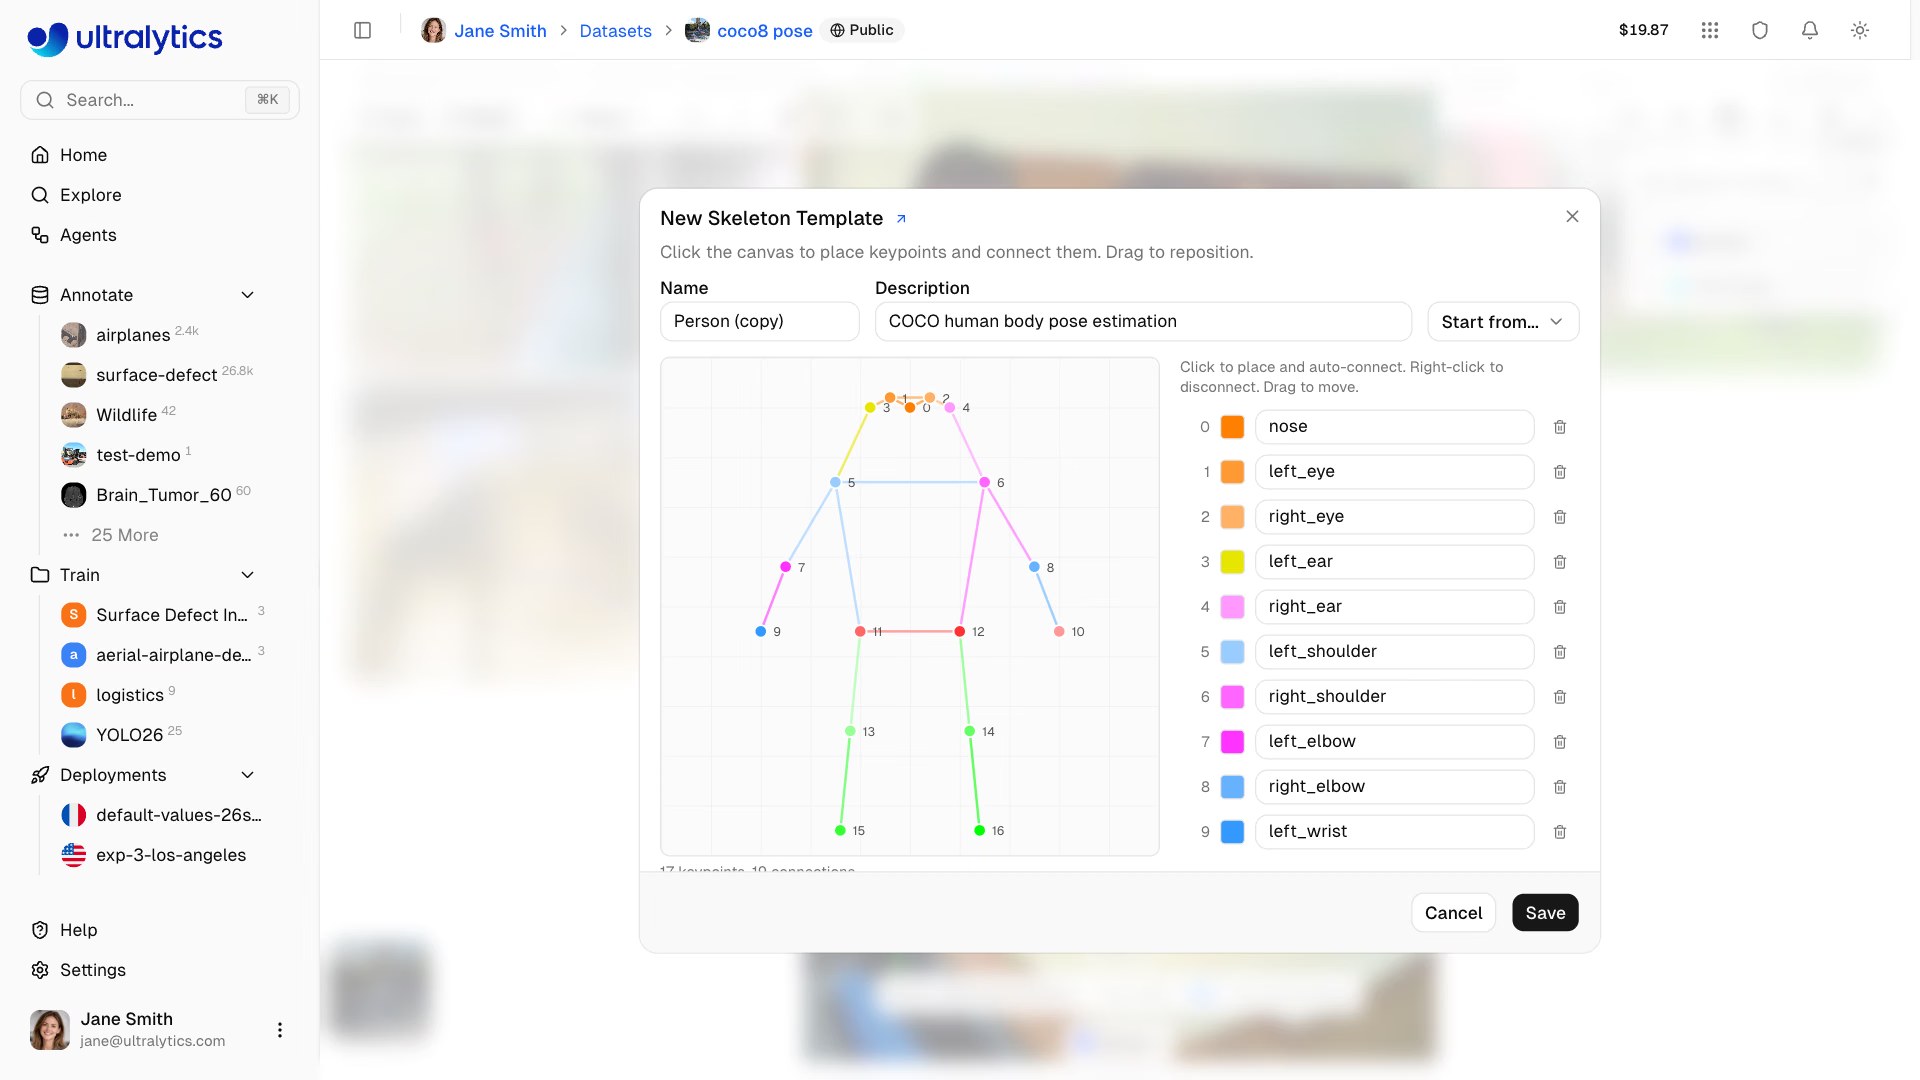
在 Ultralytics Platform 上,同一套方案会成为骨架模板。你可以从已有模板开始创建新模板(从……开始),这样只需重命名和删减关键点,而不必手动逐一放置所有关键点——请保持与方案表一致的索引顺序:
训练前检查标签#
姿势数据集出错时往往不会明显报错:某行少了一个关键点,就会导致之后的所有值错位;有缺陷的导出器输出可见性值 3 时,程序也会像读取其他数字一样读取它。这个校验器会使用 Ultralytics 自带的加载器加载 YAML,并验证每一行。它可以直接用于 COCO8-pose;要换成你自己的 YAML 路径:
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-pose.yaml")  # resolves paths, downloads if needed
k, dims = data["kpt_shape"]
flip = data.get("flip_idx", [])
assert not flip or sorted(flip) == list(range(k)), "flip_idx must list every keypoint index once"
assert all(flip[flip[i]] == i for i in range(len(flip))), "flip_idx must undo itself: pairs swap, center points stay"

expected = 5 + k * dims  # class + 4 box values + k keypoints of `dims` values
bad = 0
for label in Path(data["path"], "labels").rglob("*.txt"):
    for n, row in enumerate(label.read_text().splitlines(), 1):
        values = row.split()
        if len(values) != expected:
            bad += 1
            print(f"{label.name}:{n} has {len(values)} values, expected {expected}")
        elif dims == 3 and not {float(v) for v in values[7::3]} <= {0, 1, 2}:
            bad += 1
            print(f"{label.name}:{n} has a visibility flag outside 0/1/2")
print(f"kpt_shape={data['kpt_shape']}, flip_idx ok, {bad} bad rows")
kpt_shape=[17, 3], flip_idx ok, 0 bad rowsvalues[7::3] 从第一个可见性标志开始(类别、四个框值,然后是 x y v),之后每隔两个值取一个值。
OKS 如何为关键点评分#
姿势 mAP 用对象关键点相似度(OKS)取代边界框 IoU。对于每个已标注的关键点,OKS 会将预测值与标签之间的像素距离转换为 0 到 1 的分数,并根据对象大小和该关键点的 sigma 进行缩放,然后对已标注的关键点取平均值。Pose mAP50-95 会对 OKS 阈值从 0.50 到 0.95 的精确率取平均值,和框 mAP 对 IoU 阈值取平均值完全相同;性能指标指南介绍了两者共用的机制。
通过测量最容易理解 sigma。下面的脚本使用两个 sigma 对同一个叉车预测进行评分,并调用姿势验证器使用的 kpt_iou 函数:
import torch

from ultralytics.utils.metrics import kpt_iou

# One labeled forklift, 4 keypoints (x, y, visibility) in pixels, inside a 200 x 120 px box
label = torch.tensor([[[40.0, 30, 2], [40, 90, 2], [170, 20, 2], [170, 100, 2]]])
area = torch.tensor([200 * 120 * 0.53])  # Ultralytics scales box area by 0.53 to approximate object area

for offset in (2, 5, 10, 20):
    pred = label.clone()
    pred[..., 0] += offset  # every predicted keypoint lands `offset` pixels to the right
    sharp = kpt_iou(label, pred, area, sigma=[0.025] * 4).item()
    loose = kpt_iou(label, pred, area, sigma=[0.10] * 4).item()
    print(f"{offset:2d} px off: OKS {sharp:.2f} with sigma 0.025, {loose:.2f} with sigma 0.10")
2 px off: OKS 0.94 with sigma 0.025, 1.00 with sigma 0.10
5 px off: OKS 0.67 with sigma 0.025, 0.98 with sigma 0.10
10 px off: OKS 0.21 with sigma 0.025, 0.91 with sigma 0.10
20 px off: OKS 0.00 with sigma 0.025, 0.67 with sigma 0.10对于一辆 200 × 120 像素的叉车,预测误差为 10 像素时,sigma 为 0.025 会导致其无法通过 0.50 OKS 阈值;sigma 为 0.10 时,则能通过所有不高于 0.90 的阈值。同一个模型、相同的误差,姿势 mAP 却大不相同。
| Sigma | 效果 | 适用情况 |
|---|---|---|
| 较小(≈ 0.025–0.05) | 只偏差几像素就会降低分数 | 边界清晰的点:眼睛、货叉尖端、角点 |
| 较大(≈ 0.08–0.10) | 容差较大 | 边界模糊的点:髋部、门架中部 |
| 默认 | kpt_shape: [17, 3] 使用 COCO sigma;否则每个点使用 1/K | 从这里开始,然后进行测量 |
Sigma 应反映标注者定位每个点的一致程度。实际测量一下:让两个人标注相同的 50 张图像,并比较每个关键点的距离。对于有分歧的点,应使用较大的 sigma;否则,指标就会因人为噪声而惩罚模型。
如上表所示,改变 kpt_oks_sigmas 会改变姿态 mAP,但不会改变模型。首次建立基准前就应确定 sigma,并在每个结果中记录;绝不要比较使用不同数值进行验证的运行结果。
显示解答
例如,从上方观察传送带上的包裹时,问题是“标签面朝上吗?标签旋转了多少?”:
| 索引 | 关键点 | 用途 | 镜像对应点 | Sigma |
|---|---|---|---|---|
| 0 | label_top_left | 标签方向 | 1 | 0.04 |
| 1 | label_top_right | 标签方向 | 0 | 0.04 |
| 2 | label_bottom_right | 标签方向 | 3 | 0.04 |
| 3 | label_bottom_left | 标签方向 | 2 | 0.04 |
kpt_shape: [4, 3]
flip_idx: [1, 0, 3, 2]
kpt_oks_sigmas: [0.04, 0.04, 0.04, 0.04]
flip_idx 通过了自身为逆映射的检查:0 → 1 → 0,2 → 3 → 2。镜像后的标签会交换左右,但保持上下不变,因此左上角应与右上角配对,而不是与右下角配对。
要确定容差,请在 oks.py 中设置 sigma=[0.04] * 4 并扩展偏移范围;标签边界框决定缩放比例,因此请使用与你的图像中典型包裹标签大小相同的边界框。OKS 首次低于 0.5 时的偏移量,就是在标注者精度范围内模型能够容忍的最大误差。