语义分割:标注每个像素
用 yolo26n-sem.pt 预测逐像素类别图,将其转换为覆盖率数值,构建 PNG 类别图数据集,并解读 mIoU,避免被像素准确率误导。
有些问题不涉及对象计数:人行道有多少被堵住,田地里有多少杂草,可行驶道路在哪里结束。语义分割通过为每个像素分配一个类别 ID 来回答这些问题。不过,它的核心指标很容易被误读:你在本课中训练的模型像素准确率达到 91%,却一个人都没检测出来。
实践操作
实例分割还是语义分割?#
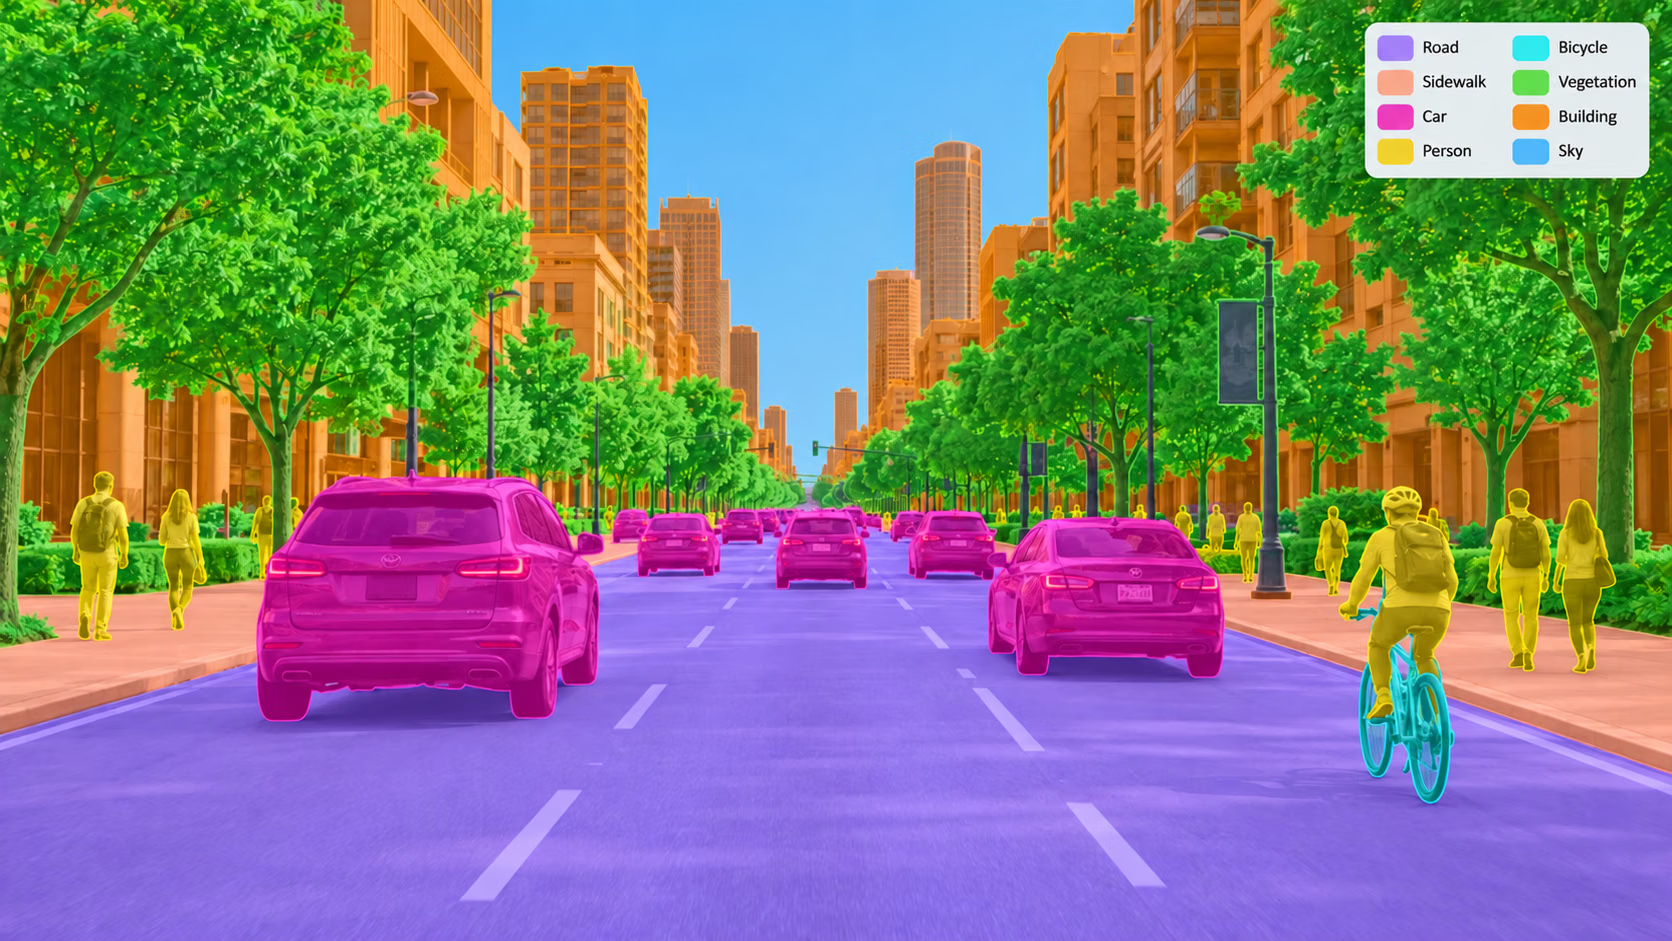
实例分割(segment) | 语义分割(semantic) | |
|---|---|---|
| 输出 | 每个对象一个掩码,另有一个框 | 每个像素一个类别 ID |
| 统计对象数量 | 是 | 不能——两辆相邻的汽车会被视为一个“汽车”区域 |
| 处理“stuff”(道路、天空、草地) | 效果差——不存在自然划分的实例 | 是 |
| 标签 | 多边形 | PNG 类别图或多边形 |
| 门控指标 | 掩码 mAP50-95 | mIoU |
| 预训练权重 | yolo26n-seg.pt(COCO,80 个类别) | yolo26n-sem.pt(Cityscapes,19 个类别) |
如果下游问题是“有多少个”,就使用实例分割。如果问题是“有多少”或“在哪里”,语义分割更易标注和读取。语义分割任务页面包含模型表。
预测类别图#
result.semantic_mask.data 是一个 H × W 张量,尺寸与原始图像相同;每个值都是类别 ID,255 表示忽略。result.summary() 可将它转换为各类别的像素比例:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%看最后一行。Cityscapes 有一个 bus 类别,但模型却把公交车识别为 train。模型从车载拍摄的影像中学习,而这些影像大多拍摄于德国街道;从人行道近距离拍摄的公交车不属于这种数据分布。与检测器相比,语义模型更严格地继承训练集的视角和类别定义,也就是其数据集偏差,因此在相信类别图之前,请先用你自己的相机数据进行微调。
将类别图转换为答案#
通过简单的张量比较,类别图就能变成产品指标。下面回答“行人会走进的区域中,道路或人行道占多少,人占多少?”:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% person三个习惯能让这些数值更可靠:
- 按名称查找 ID,从
result.names获取,绝不要硬编码数字;用你自己的类别训练的模型,其类别编号会不同。 - 只关注重要区域。整幅画面的比例会混入天空和建筑;应先裁取类别图(或乘以区域掩码)。
- 打开叠加图查看。
semantic_overlay.jpg能让你一眼看出数值所统计的“道路”是否真的是道路。
数据集格式#
语义数据集将每张图像与一张单通道掩码图像配对,掩码像素值表示类别 ID。语义数据集指南是参考资料;其目录结构与 images/ 逐文件对应:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
YAML 中增加 masks_dir;如果掩码中存储的 ID 与训练 ID 不同,还需要添加 label_mapping 区块:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Cityscapes 掩码存储 -1 到 33 的原始标签 ID;映射会保留其中 19 个,其余都映射到 ignore_label,并存储为 255。值为 255 的像素不会计入损失或指标;对于标注人员无法确定的区域,也使用相同的值。
如果你已有多边形标签,但没有 masks_dir,加载器会为你将多边形栅格化,并为未覆盖的像素添加 background 类别。
有损压缩会混合相邻像素值,使类别 7 和类别 8 之间的边界变成由 7、8 以及不存在的 ID 构成的模糊带。所有掩码都应保存为 PNG 或 TIFF。
训练并解读 mIoU#
Cityscapes8包含 8 张城市场景图像,其中 4 张用于训练,4 张用于验证,足以进行 CPU 冒烟测试:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(已省略部分类别行。)像素准确率显示为 91%,mIoU 显示为 42%;各类别行则表明模型一个人都没检测出来。这些结果都是真的。道路、建筑和植被占据了大部分像素——仅道路就有 78,529 个像素,占总数 192,315 的很大一部分——因此,能很好地标注这些区域的模型,即使漏掉所有小类别,像素准确率仍然很高。mIoU 对各类别的 IoU 取等权平均,因此每个漏检类别都会拉低它。

除了 mIoU,还要根据产品实际处理的类别的 IoU 设置门槛。对于行人安全功能,如果 person IoU 为 0,无论像素准确率如何,都不合格。
显示解答
在我们的运行中:mIoU 为 0.415,像素准确率为 0.906;墙壁、行人、骑行者、摩托车和自行车的 IoU 为 0,此外,验证集四张图像中没有像素的类别也全部为 0。
像素准确率更高,是因为它按像素计数,而道路、建筑、植被和天空占据了每张 Cityscapes 图像的大部分区域。mIoU 对每个类别赋予相同权重,因此即使五个漏检的小类别只覆盖几百个像素,也会拉低平均值。对于需要对人采取行动的产品,这个模型仅因行人 IoU 不达标就无法通过门槛。