选择任务并规划流水线
将每个产品问题映射到 Ultralytics YOLO 七种任务之一,并确定其权重、结果字段、标签格式和门控指标,再通过在一张图像上运行每项任务来验证计划。
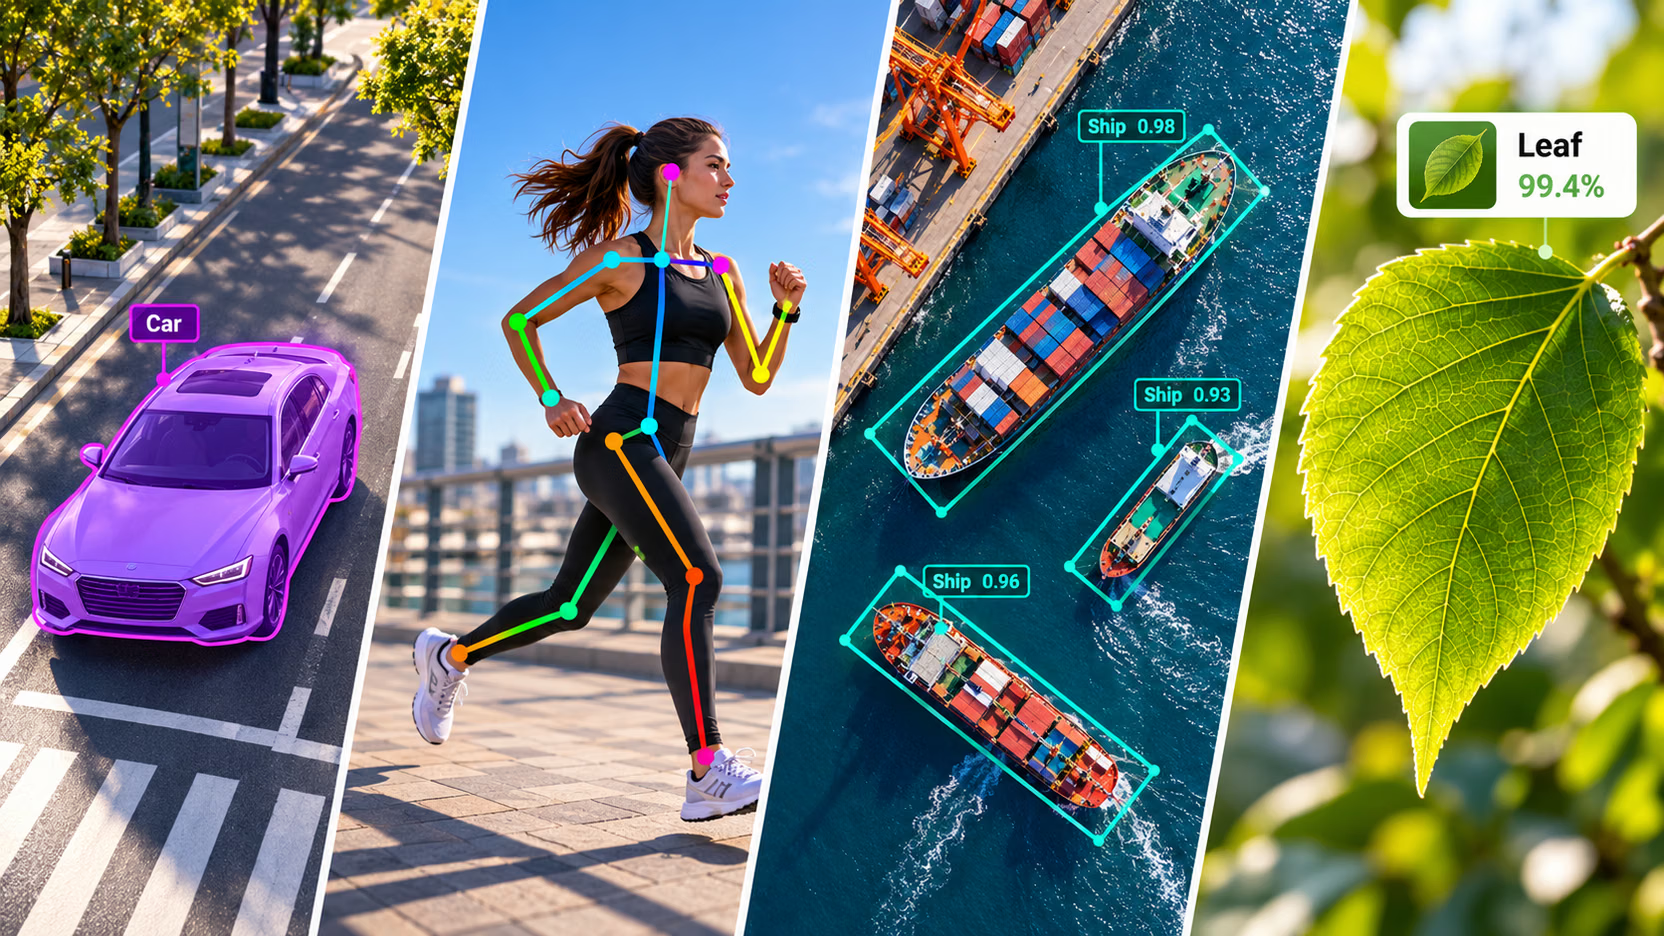
检测器上线后,接下来的需求很少是“再多检测几个框”。人们会问“溢出面积有多大”“工人的背是否弯曲”“船头朝向哪里”以及“这个零件是否报废”。在本课程全程使用的街景照片中,公交车的边界框占画面的 48%,而公交车本身只占 29%,因此基于框计算面积会产生超过一半的误差。你选择的任务决定了标签格式,因此在开始标注前选定任务,是整个项目中成本最低的决策;之后再更改就意味着重新标注。
实践操作
一张照片,四种不同答案#

针对一张照片提出一个问题——画面中公交车占多大面积,距离有多远?——然后让四种 Ultralytics YOLO 任务来回答:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the camera逐行来看:
- detect 回答在哪里。边界框还包含公交车下方的道路,以及站在公交车前面的四个人,因此用它计算面积会多出 63%。
- segment 回答是什么形状。29.2% 是公交车在图像中的实际占地面积,这个数字可用于任何面积、覆盖率或重叠规则。
- semantic 回答哪些像素属于哪个类别。计算出的面积与掩码接近,但模型会把公交车标为
train:它根据训练集(Cityscapes,第 4 课)的类别给表面贴标签,无法区分不同车辆。 - depth 回答距离有多远。公交车掩码内部的中位深度为 4.5 m——结合两项任务才能回答这个单独任务无法回答的问题。
如果产品报告的数值是面积、覆盖比例或重叠程度,那么边界框就不是合适的工具。对物体使用掩码(实例分割),对表面使用类别图(语义分割)。
七项任务一览#
计算机视觉基础详细介绍了如何在不同任务之间做选择——如果选择不明显,请重温七种视觉任务。这是本课程后续内容的实用回顾。每一行都对应已安装的 ultralytics 包支持训练、验证、预测和导出的任务,而且都使用相同的 API;完整参考资料请见任务概览。
| 输出要回答的问题 | 任务 | YOLO26 权重 | 结果字段 | 标签格式 | 门控指标 |
|---|---|---|---|---|---|
| 每个对象在哪里? | detect | yolo26n.pt | boxes | 类别 + 边界框 | 边界框 mAP50-95 |
| 每个对象的准确形状和面积是什么? | segment | yolo26n-seg.pt | masks + boxes | 类别 + 多边形 | 掩码 mAP50-95 |
| 每个像素属于哪个类别? | semantic | yolo26n-sem.pt | semantic_mask | PNG 类别图或多边形 | mIoU |
| 关节或关键点在哪里? | pose | yolo26n-pose.pt | keypoints + boxes | 类别 + 边界框 + 关键点 | 姿态 mAP50-95 (OKS) |
| 每个对象旋转了多少? | obb | yolo26n-obb.pt | obb | 类别 + 4 个角点 | OBB mAP50-95 |
| 整张图像(或裁剪图)中是什么? | classify | yolo26n-cls.pt | probs | 每个类别一个文件夹 | top-1 准确率 |
| 每个像素距离相机有多远? | depth | yolo26n-depth.pt | depth | 每张图像一张深度图(16 位 PNG 或 NPY) | δ1 (delta1) |
第一行你已经在实际使用。第 2 到第 8 课讲解中间五行,第 9 和第 10 课则将这些任务串联起来并投入使用。最后一行是单目深度估计,它会预测单张图像中每个像素以米为单位的距离。其标签来自深度传感器或 3D 渲染器,而不是标注人员,因此有自己的数据集格式;本课程会在工作流程通用的环节中介绍它:本计划、验证循环,以及最后一课中的导出检查。
每次只选择一个问题#
按顺序检查这些问题,遇到第一个回答“是”的问题时就停下:
决策图涵盖了常见情况。以下四个判断标准可解决大多数其他情况:
| 如果需求…… | 选择 | 原因 |
|---|---|---|
| 既需要计数又需要面积(“有多少处溢出,面积有多大”) | segment | 语义分割会把相接的对象合并成一个区域 |
| 涉及从上方观察、并排紧密排列的细长对象 | obb | 轴对齐框会相互重叠,NMS 会漏掉真实对象,即使你从不读取角度也是如此 |
| 需要区分前后或左右 | pose | OBB 给出的是轴线,而不是朝向 |
| 按设计每张图像恰好只有一个物品(固定式检测站) | classify | 标签成本最低,模型速度最快 |
创建数据集时任务就已确定——在 Ultralytics Platform 中,它对应“新建数据集”对话框里的 Task Type 字段——因此必须在开始标注前做出选择:

一个 API,七个结果字段#
所有任务都使用相同的调用;模型会从权重文件中读取任务类型。变化的是结果中哪个字段会被填充,而你的代码将读取的就是这个字段:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']分割和姿态结果会保留 boxes,因此你现有的检测代码也能继续处理它们。分类、语义分割和深度结果描述的是整张图像,完全没有任何逐对象字段。
在 OBB 模型上,循环处理 result.boxes 的检测代码会因 TypeError: 'NoneType' object is not iterable 而停止:result.boxes 的值是 None,旋转检测结果只存在于 result.obb 中。要将检测代码迁移到 OBB,应读取 result.obb,而不是通过检查 None 来防止报错,结果却一个检测都没有。
一个模型不够用时#
大多数超出检测范围的生产系统都可归为以下三种形式之一:
- 先检测,再分类。 检测器在大画面中找到小目标;图像分类器则对每个全分辨率裁剪图进行细粒度判断:头盔类型、缺陷等级、产品 SKU。
- 姿态加跟踪。 关键点描述单帧内容;跟踪器将关键点转换为逐人的时间序列,你可以据此统计重复次数或检测跌倒。
- 先分割,再测量。 模型返回像素,普通代码再将其转换为面积、宽度、覆盖率或(结合深度时的)距离。
先分割再测量流水线所需的标签,是每个对象一个多边形,例如 Ultralytics Platform 编辑器中这些仓储机器人的包裹:
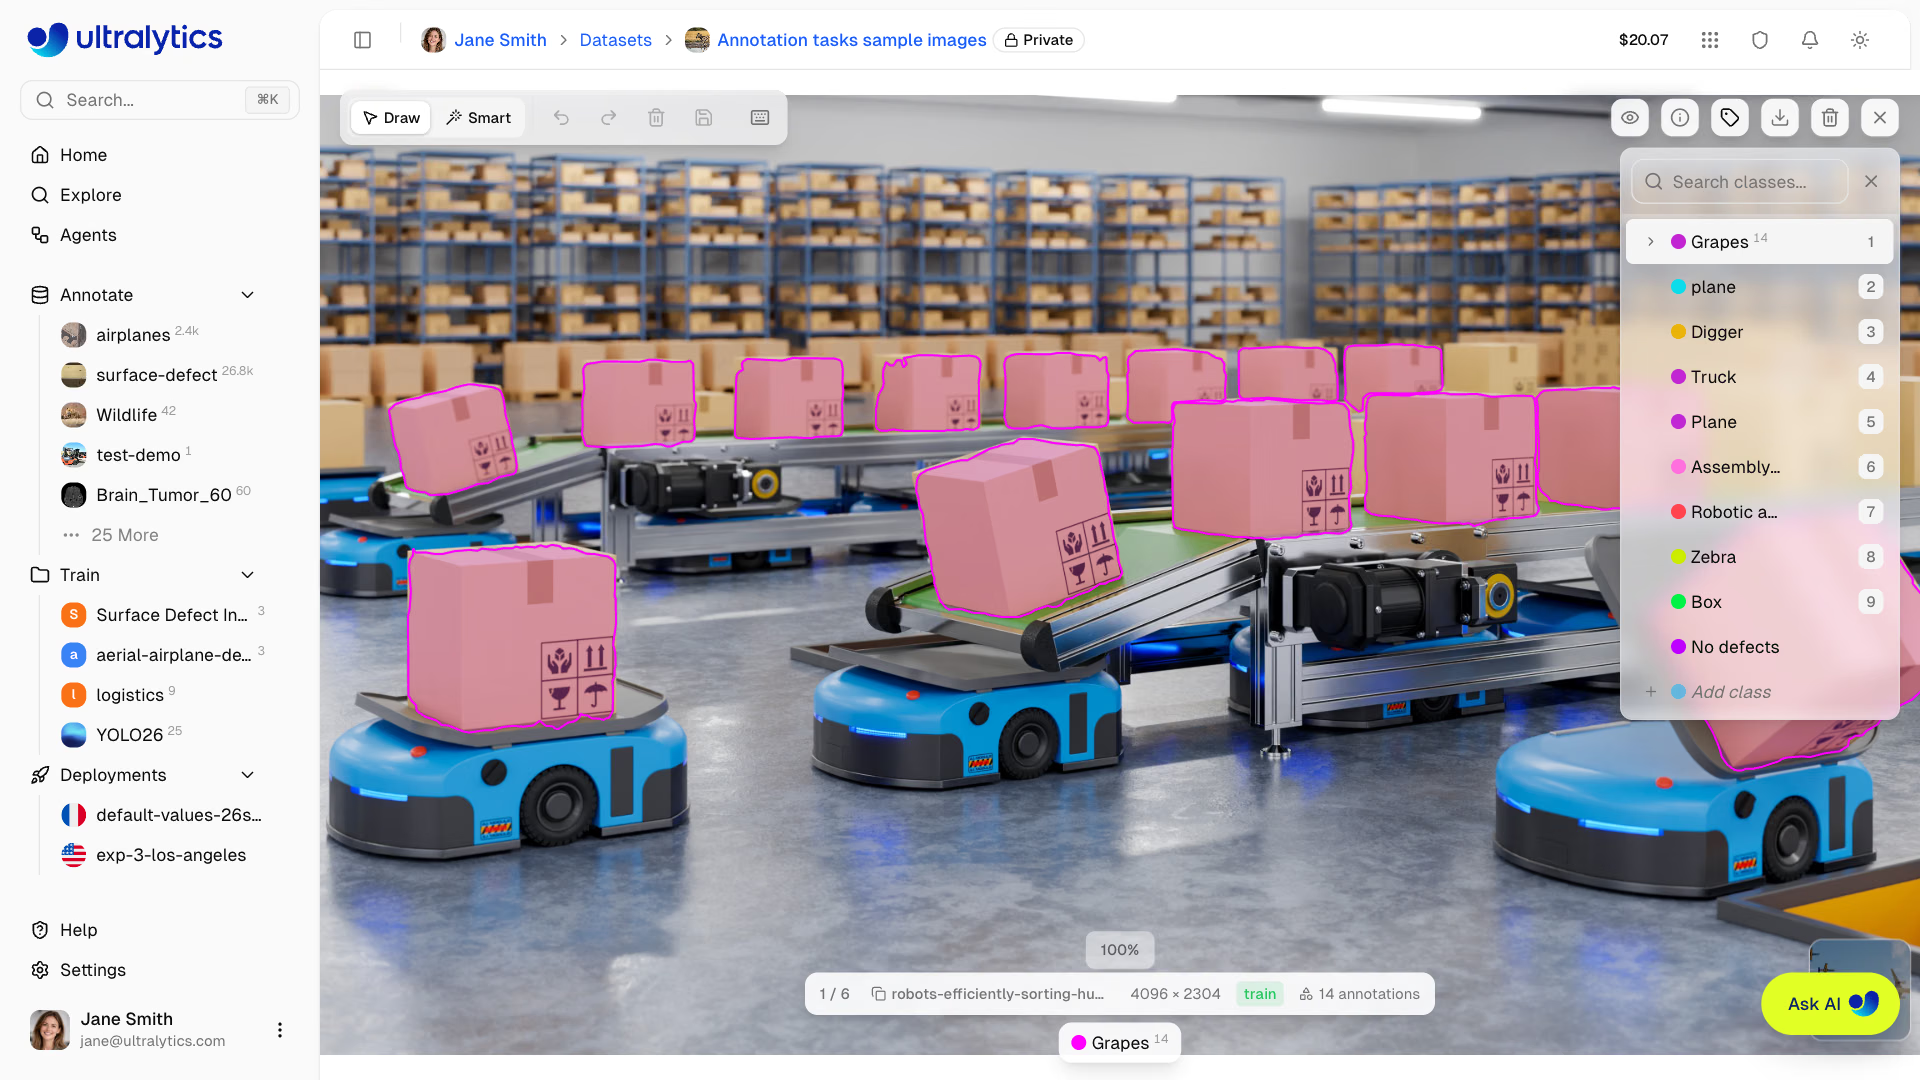
第二个模型会增加推理延迟,还需要标注和维护第二个数据集,并监控第二个模型。只有当一个任务无法回答问题时才串联模型——能交付的单模型方案,胜过无法完成标注的三模型方案。
常见问题#
症状:团队因为掩码演示效果好而标注多边形,结果产品只读取计数。解决方法:开始标注前,先明确指出哪行代码会使用输出结果。如果没有任何代码读取轮廓,就部署检测器:边界框标注和运行都更快。
症状:标注一个月后,有人发现产品需要航向,而数据集只有 OBB 标签,只能提供轴的方向。解决方法:在计划中写明确切的属性(result.masks.xy、result.keypoints.xy、result.obb.xywhr),并在首次标注前使用选定的权重运行 tasks.py。
症状:分类器在清晰的产品照片上得分为 95%,但在生产环境中的大多数检测器裁剪图上都预测错误。解决方法:使用第一阶段实际生成的裁剪图构建第二阶段数据集,并保留真实的模糊和取景效果;第 9 课会介绍具体方法。
显示解答
以托盘需求为例:
| 项目 | 选择 |
|---|---|
| 问题 | 托盘是否有任何部分超出了货架横梁线? |
| 任务 | segment——判断超出部分需要知道托盘的轮廓;它的边界框还会覆盖托盘下方的空隙和上方的货物 |
| 权重 | yolo26n-seg.pt,使用来自仓库摄像头的画面进行微调 |
| 标签格式 | 每个托盘一个多边形 |
| 结果字段 | result.masks.data 与 retina_masks=True(横梁线之外的像素) |
| 门控指标 | 在未参与训练的摄像头数据上评估掩码 mAP50-95 |
| 第二阶段 | 无——每台相机的光束线都是固定的,因此它属于配置,而不是模型 |
因此,悬挑规则只需三行代码:为每台相机绘制一次光束线,统计位于光束线错误一侧的掩码像素数,并在超过你根据几个已知悬挑样本校准的像素阈值时发出警报。第 3 课展示的正是这种掩码与区域对比测试。