训练图像分类器
整理文件夹数据集,在 MNIST160 上训练 yolo26n-cls.pt,读取概率和 top-1 准确率,并将低置信度预测转交人工审核。
图像分类针对每张图像回答一个问题:这是什么?它所需的标注成本是所有任务中最低的——只需一个文件夹名称——而且运行速度最快,因此它是检测器之后默认的第二阶段,也是每帧只看到一个部件的检测工位的理想首选模型。它的数据集没有 YAML 文件,因此文件夹结构就是约定;分类器总会给出答案,即使它从未见过类似的图像。判断何时不该相信分类器,也是工作的一半。
实践操作
文件夹数据集的结构#
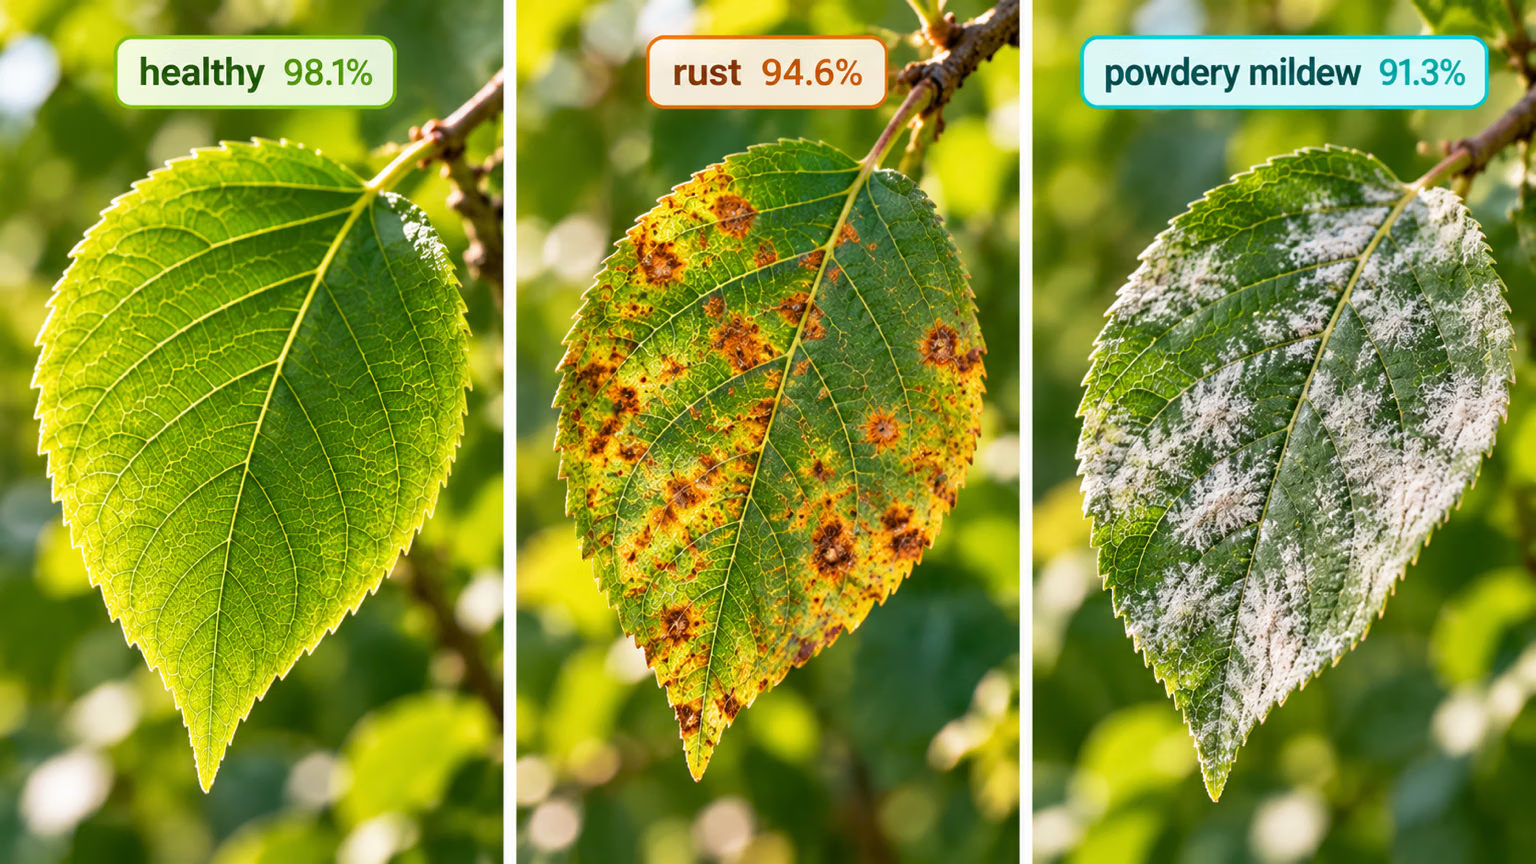
分类数据集是目录,而不是 YAML 文件。将 data= 指向根文件夹:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
└── dent/根据已安装的源码和分类数据集指南,加载器对数据集的处理方式如下:
| 情况 | 行为 |
|---|---|
| 类别索引 | train/ 下的文件夹名称按字母顺序排序 → dent=0,good=1,scratch=2 |
| 验证文件夹 | 先是 val/,然后是 validation/,再是 valid/;如果都没有,则在发出警告后回退到 test/ |
没有 train/ 文件夹,只有类别文件夹 | 自动按 80/20 的比例拆分到 train/ 和 val/ |
在 Ultralytics Platform 上,分类数据集为每张图像提供一个图像级标签,而不是形状标注:
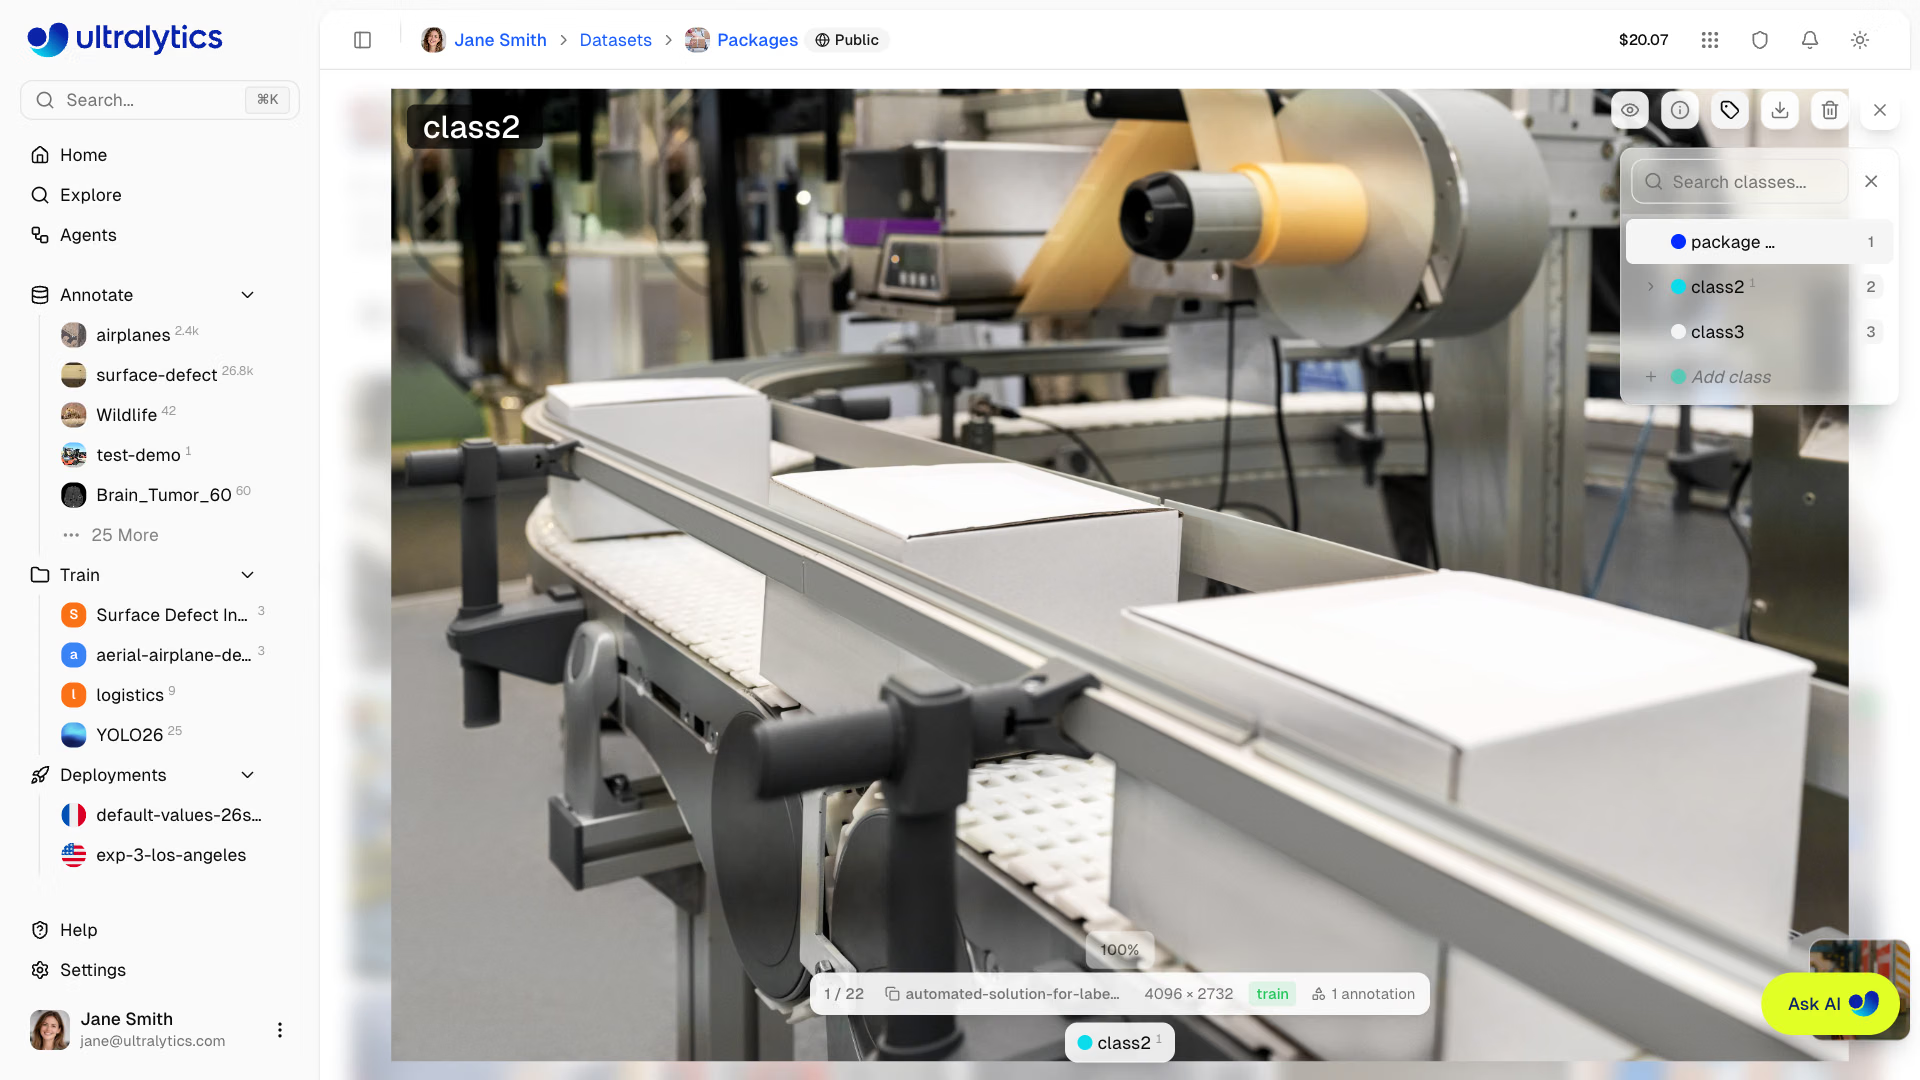
症状:添加类别后,旧集成会把 good 部件报告为 dent。原因:添加名为 bent 的文件夹后,它会排在最前面,导致其后所有索引都发生偏移。解决方法:始终使用 model.names(或 result.names)将索引映射到名称;不要硬编码索引。
在 MNIST160 上训练#
MNIST160 包含 160 张手写数字图像,train/ 和 test/ 中各有 80 张,每个部分又分为十个数字文件夹——非常适合 CPU 冒烟测试。它没有 val/ 文件夹,因此请留意加载器发出警告并回退到 test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463一个 epoch 几乎不会改变新建的十分类头。在我们的运行中,epochs=10 在笔记本电脑 CPU 上约 10 秒内达到了 top-1 0.55 和 top-5 0.95——流程运行正常,只是还需要更长的训练计划。分类任务指南列出了预训练模型的尺寸。
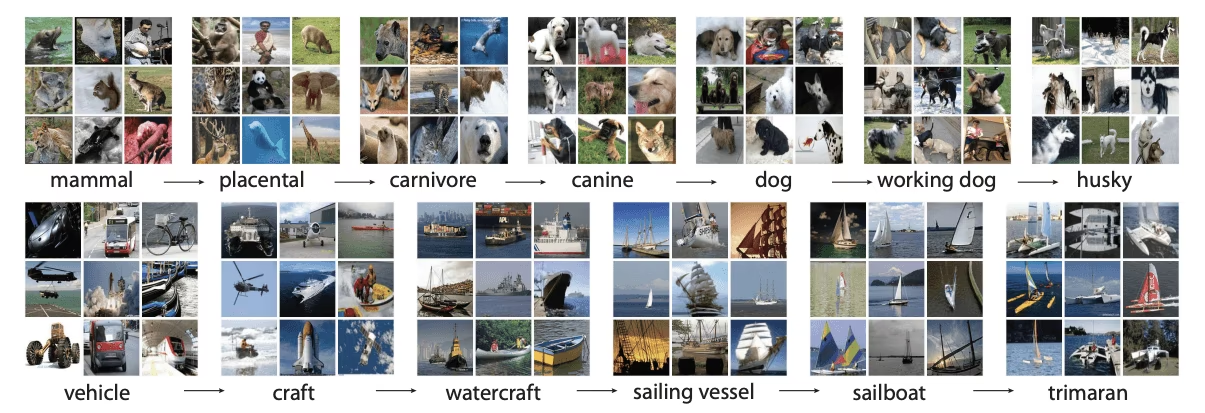
Top-1 表示最高概率类别正确的图像占比。Top-5 在正确类别出现在概率最高的五个类别中时计为命中。对于包含 1,000 个类别的 ImageNet,top-5 很有参考价值,因为其类别从宽泛类别到非常细粒度的类别都有;类别数不超过五个时,top-5 始终为 1.0,类别数为十个时,它也很宽松。应结合 top-1 准确率和逐类别混淆矩阵来设定准入标准。
在代码中读取概率#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 是一个索引,probs.top5 是索引列表,而 probs.data 是完整的概率向量。注意 top-1 置信度:0.52 仅略高于在 minibus 和 police_van 之间抛硬币的概率。你可以根据这个数值决定如何分流。
将不确定的预测交给人工处理#
生产环境中的分类器很少需要对每张图像都判断正确;它需要对自己决定处理的图像判断正确。这个脚本会训练 10 个 epoch 的模型,然后测量不同置信度阈值在 80 张留出数字图像上的效果:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%每一行都代表一种权衡:提高阈值会让被接受的预测更准确,同时会把更多图像交给人工处理。在 0.6 阈值下,该模型仅对 80 个数字中的 10 个自行作出判断——它还无法自动处理任何任务,解决方法是增加训练,而不是设计更巧妙的阈值。每轮训练后重新运行同一张表:它会同时告诉你能够达到的准确率,以及各阈值会产生多少审核工作。
在留出数据上测量已接受图像的准确率,选择满足要求的最低阈值。然后检查由此产生的审核量是否在团队可处理的范围内;如果超出范围,就改进模型。
常见问题#
症状:空工位、错误部件或遮住镜头的手都被赋予了置信度很高的类别标签。原因:softmax 概率之和始终为 1,因此分类器总会从已有类别中选出一个。解决方法:添加一个装有这些图像的 other/ 文件夹,并将低 top1conf 预测结果送审。
症状:预训练模型在尚未训练前,在你的数据集上得分接近零。原因:yolo26n-cls.pt 会预测 1,000 个 ImageNet 索引,而你的文件夹复用了索引 0–9,但含义不同:在 MNIST160 上,文件夹 0 是索引 0,预训练分类头将其称为 tench。我们测得这种情况下 top-1 为 0.000。解决方法:先微调,再验证。
症状:验证时 top-1 接近 1.0,生产环境中的表现却低得多。原因:train/ 和 val/ 中存在同一部件的近重复照片。解决方法:按部件或采集批次划分数据集,参见正确划分数据集。
分类器是在 imgsz=224 尺寸上预训练的,而不是 640。对于大图像中的小目标,与其使用更大的 imgsz,不如采用先检测再分类的方法(下一课会介绍)。
显示解答
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
我们的运行结果:1 个 epoch → top-1 0.162,top-5 0.463;10 个 epoch → top-1 0.550,top-5 0.950。对于五分类问题,正确答案总会出现在前五名中,因此 top-5 按定义就是 1.0,无法提供任何信息。
若要让被接受图像的准确率达到 75%,route.py 给出的阈值是 0.6(接受的 10 张图像中准确率为 80%),这会将 80 个数字中的 70 个送去审核。这才是实情:该阈值满足准确率要求,但模型目前还没有实用价值。继续训练,并在为实际应用选择阈值之前重新运行这张表。